
遇见数据集

Rocktim/EXAMS-V

收藏
Hugging Face2024-05-07 更新2024-06-12 收录
官方服务:

资源简介:

EXAMS-V是一个多学科、多语言、多模态的考试基准数据集,用于评估视觉语言模型。该数据集包含20,932个多项选择题,涵盖20个学科,包括自然科学、社会科学和其他杂项研究。问题以11种语言呈现,来自7个语系。数据集的特点包括文本、图像、表格、图表、地图、科学符号和方程等多种模态特征。数据集通过收集来自不同国家的学校考试题目,要求跨语言的复杂推理和地区特定知识。数据集的评估结果表明,即使对于先进的视觉-文本模型如GPT-4V和Gemini,这也是一个具有挑战性的数据集。

EXAMS-V是一个多学科、多语言、多模态的考试基准数据集,用于评估视觉语言模型。该数据集包含20,932个多项选择题,涵盖20个学科,包括自然科学、社会科学和其他杂项研究。问题以11种语言呈现,来自7个语系。数据集的特点包括文本、图像、表格、图表、地图、科学符号和方程等多种模态特征。数据集通过收集来自不同国家的学校考试题目,要求跨语言的复杂推理和地区特定知识。数据集的评估结果表明,即使对于先进的视觉-文本模型如GPT-4V和Gemini,这也是一个具有挑战性的数据集。

提供机构:
Rocktim
原始信息汇总

数据集概述

数据集名称

EXAMS-V: A Multi-Discipline Multilingual Multimodal Exam Benchmark for Evaluating Vision Language Models

数据集特征

  • image: 图像数据
  • sample_id: 字符串,样本ID
  • answer_key: 字符串,答案键
  • type: 字符串,类型
  • grade: 字符串,年级
  • subject: 字符串,学科
  • subject_grouped: 字符串,学科分类
  • language: 字符串,语言
  • chemical_structure: 浮点数,化学结构
  • table: 浮点数,表格
  • figure: 浮点数,图形
  • graph: 浮点数,图表

数据集分割

  • train: 训练集,包含16494个样本,总大小为4447843755.352字节
  • test: 测试集,包含4797个样本,总大小为1418470579.681字节

数据集大小

  • 下载大小: 6442812293字节
  • 数据集总大小: 5866314335.033字节

配置文件

  • config_name: default
  • data_files:
    • train: data/train-*
    • test: data/test-*

数据集统计

  • 包含20,932个多选题,覆盖20个学科,涉及自然科学、社会科学及其他学科。
  • 问题以11种语言呈现,来自7个语言家族。
  • 数据集包含多种多模态特征,如文本、图像、表格、图形等。
  • 语言和学科的分布显示了数据集的多样性和复杂性。

许可证

  • Apache-2.0许可证

引用信息

@misc{das2024examsv, title={EXAMS-V: A Multi-Discipline Multilingual Multimodal Exam Benchmark for Evaluating Vision Language Models}, author={Rocktim Jyoti Das and Simeon Emilov Hristov and Haonan Li and Dimitar Iliyanov Dimitrov and Ivan Koychev and Preslav Nakov}, year={2024}, eprint={2403.10378}, archivePrefix={arXiv}, primaryClass={cs.CL} }
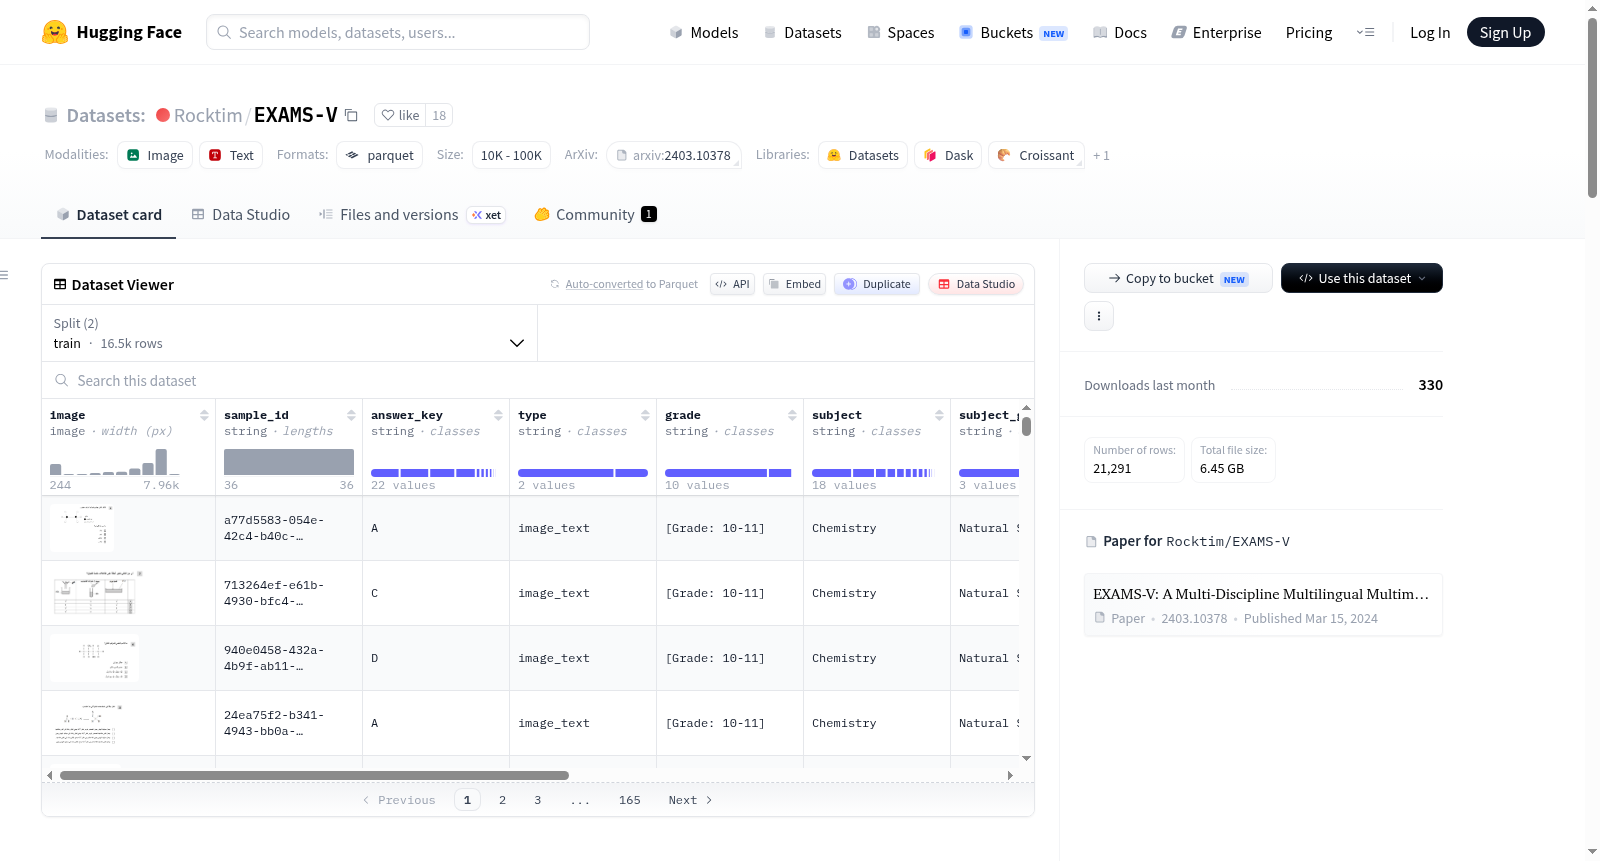
搜集汇总
数据集介绍
Rocktim/EXAMS-V 数据集图片
构建方式
EXAMS-V数据集的构建根植于教育评估的真实场景,通过系统性地收集来自多个国家的学校考试试题,形成了涵盖20个学科、11种语言的多模态基准。这些试题横跨自然科学、社会科学及人文艺术等领域,包含文本、图像、表格、图表、科学符号与方程等丰富模态。构建过程注重地域教育体系的差异性,确保问题不仅依赖于多语言理解,还涉及区域特有的知识背景,从而对视觉-语言模型的跨文化推理能力提出严苛挑战。
特点
该数据集的核心特色在于其多学科、多语言与多模态的深度融合。共包含20,932道选择题,覆盖从高资源语言(如英语、中文)到低资源语言(如保加利亚语、塞尔维亚语)的11种语言,隶属于7个语系。每个问题均携带精细的元数据标注,如年级、学科分组及视觉元素类型(化学结构、表格、图形等),为细粒度分析模型在不同模态与语言上的表现提供了独特视角。这种设计使得EXAMS-V成为评估高级感知与联合推理能力的标杆。
使用方法
EXAMS-V数据集以HuggingFace格式发布,提供默认配置下的训练集(16,494例)和测试集(4,797例),可通过`load_dataset`函数直接加载。使用者需注意数据包含图像字段,需配合视觉编码器处理。建议将多选题的`answer_key`作为标签,利用`subject`和`language`字段进行跨学科或跨语言性能分析。基准评估显示,即使如GPT-4V等先进模型也面临挑战,因此该数据集适用于检验多模态大模型在教育场景下的鲁棒性与泛化能力。
背景与挑战
背景概述
EXAMS-V是由穆罕默德·本·扎耶德人工智能大学与索非亚大学的研究人员于2024年联合推出的大规模多学科、多语言、多模态考试基准数据集。该数据集由Rocktim Jyoti Das、Simeon Emilov Hristov、Haonan Li等学者主导构建,旨在系统评估视觉语言模型在复杂教育场景下的综合推理能力。EXAMS-V涵盖自然科学、社会科学及人文艺术等20个学科,包含20,932道多项选择题,涉及英语、中文、法语等11种语言,横跨7个语系。其独特之处在于从各国真实学校考试中采集试题,融合文本、图像、表格、图表、地图、科学符号及方程式等多种模态信息,要求模型具备跨语言、跨文化的深度感知与联合推理能力。作为评估视觉语言模型的前沿基准,EXAMS-V对推动多模态人工智能在教育领域的应用具有重要影响力。
当前挑战
EXAMS-V所解决的领域挑战在于视觉语言模型在真实教育场景中面临的多模态、多语言与多学科交叉推理难题。现有基准多聚焦单一模态或语言,难以评估模型对复杂视觉元素(如化学结构式、图表、地图)与文本内容的协同理解能力,而该数据集通过整合多国考试内容,迫使模型突破语言与学科壁垒。构建过程中,研究人员遭遇了数据采集的显著挑战:从不同教育体系的国家收集标准化试题,需处理语言多样性、学科分类差异及试题格式不统一等问题。此外,确保多模态数据的质量与标注一致性,特别是将图像、表格等非文本信息与问题答案精准对应,成为技术难点。最终,高级模型如GPT-4V和Gemini在该基准上的表现仍不理想,凸显了数据集在推动模型泛化能力与深层推理发展方面的重要挑战。
常用场景
经典使用场景
EXAMS-V数据集的核心经典使用场景在于作为多学科、多语言、多模态的视觉语言模型评估基准。该数据集汇聚了来自不同国家教育体系的20,932道多选题,覆盖自然科学、社会科学及人文学科等20门学科,并融合文本、图像、表格、图表、地图、科学符号与方程等多种模态信息。研究者可借助EXAMS-V全面检验模型在跨语言、跨文化背景下的细粒度感知与联合推理能力,尤其适用于评估模型对视觉内容与文本语义的协同理解水平。
解决学术问题
EXAMS-V旨在解决当前视觉语言模型评估中缺乏多语言、多学科、高难度真实考试场景的学术瓶颈。现有基准多集中于单一语言或有限学科,难以反映模型在复杂教育情境下的泛化能力。该数据集通过引入11种语言、7大语系以及区域特异性知识,揭示了先进模型如GPT-4V和Gemini在跨模态推理与深度语义理解上的显著不足,从而为模型鲁棒性、知识迁移及跨文化认知等研究方向提供了关键挑战与评测标尺。
衍生相关工作
EXAMS-V的发布催生了多项相关研究工作,包括针对多语言多模态模型的跨文化知识迁移分析、基于视觉语言模型的考试推理能力增强方法,以及结合区域教育背景的少样本学习策略。后续工作进一步探索了如何利用该数据集改进模型对图表、化学结构式等专业视觉元素的细粒度解析能力,并衍生出面向低资源语言的跨模态预训练范式。此外,该基准也被用于评估大型语言模型在结构化知识图谱与视觉信息融合方面的进展,推动了教育场景下多模态AI的标准化评测体系建设。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

