
遇见数据集

ekrombouts/dutch_nursing_home_notes

收藏
Hugging Face2024-06-29 更新2024-07-06 收录
官方服务:

资源简介:

该数据集之前名为dutch_nursing_home_records,为了与临床NLP社区更常用的术语保持一致,更名为dutch_nursing_home_notes。它包含为NLP实验生成的合成医疗数据,模仿了真实世界的护理院客户笔记,用于机器学习和数据分析。数据生成使用了OpenAI的3.5模型,并由经验丰富的老年病专家编写提示。数据集包含两列:报告和主题,主题分为多个类别。此外,还讨论了数据集的伦理问题,如偏见、隐私和局限性。

This dataset, named Dutch nursinghome care notes, contains synthetic healthcare data generated for NLP experiments. It mimics real-world client notes of nursing care homes for machine learning and data analysis. The dataset consists of two columns: report (textual nursing care reports) and topic (categorized into multiple care-related topics). The data generation used OpenAIs 3.5 model, with prompts written by an experienced geriatric specialist. Although the data is synthetic, ethical considerations such as potential biases, privacy issues, and data limitations should be noted.

提供机构:
ekrombouts
原始信息汇总

Dutch Nursing Home Care Notes 数据集

描述

该数据集之前名为 dutch_nursing_home_records,为了与临床自然语言处理(NLP)社区的常用术语保持一致,名称更改为 dutch_nursing_home_notes。该数据集包含用于NLP实验的合成医疗数据,模拟了护理之家的真实客户笔记,适用于机器学习和数据分析。

数据生成

数据生成脚本可在 GitHub 找到。生成过程使用 OpenAI 的 3.5 模型创建现实且匿名的数据集,提示由经验丰富的老年病专家编写。

数据集结构

数据集包含两列:

  • report: 文本护理报告。
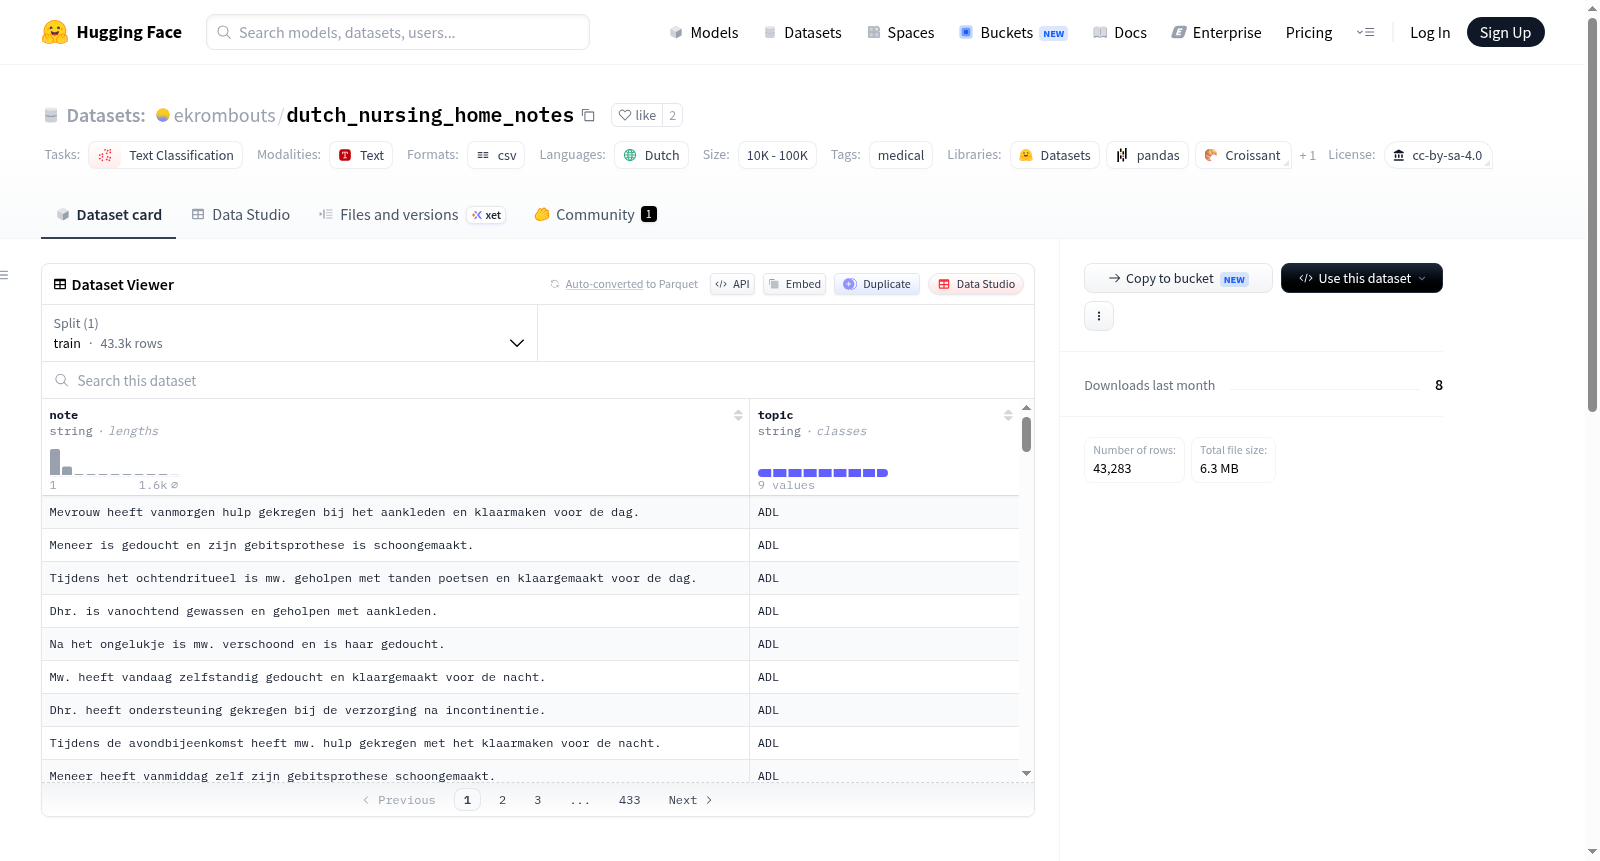
  • topic: 分类为 ADL, eten_drinken, sociaal, huid, medisch_logistiek, nachten, onrust, symptomen, mobiliteit。

伦理考虑

尽管数据是合成的,但它旨在反映真实的护理之家场景。伦理考虑包括:

  • 偏见: 数据生成过程可能引入训练模型或提示设计中的偏见。
  • 隐私: 尽管数据是合成的,但它模拟了敏感的现实世界信息。使用时应谨慎,以避免任何滥用或误用。
  • 局限性: 该数据集可能未涵盖护理之家护理的所有方面,不应作为医疗环境中决策的唯一资源。
搜集汇总
数据集介绍
ekrombouts/dutch_nursing_home_notes 数据集图片
构建方式
该数据集名为dutch_nursing_home_notes,旨在为临床自然语言处理研究提供模拟真实养老院护理记录的合成医疗数据。其构建过程依托于生成式人工智能技术,具体采用OpenAI的GPT-3.5模型,通过经验丰富的老年医学专家精心设计的提示词(prompts)驱动,生成高度逼真且去标识化的文本记录。数据生成脚本公开于GitHub仓库,确保了流程的可复现性与透明度。最终数据集以CSV格式呈现,包含‘report’(护理报告文本)与‘topic’(护理主题标签)两列,其中主题涵盖日常生活活动(ADL)、饮食、社交、皮肤护理、医疗后勤、夜间护理、躁动、症状及活动能力等九大类别,系统性地模拟了养老护理场景中的多元维度。
特点
该数据集的核心特点在于其合成属性与专业导向性的有机结合。作为合成数据,它有效规避了真实患者隐私泄露的风险,同时通过老年医学专家的参与,确保了内容在临床语境下的真实性与相关性。数据规模介于1万至10万条之间,类别标签的精细划分使研究者能够针对特定护理主题进行细粒度分析。此外,数据集明确标注了伦理考量,指出虽为合成但可能继承模型偏见,且不可作为医疗决策的唯一依据,体现了对数据使用边界的审慎态度。这种平衡了真实感与安全性的设计,使其成为医疗自然语言处理领域模型训练与算法验证的宝贵资源。
使用方法
该数据集主要面向文本分类任务,适用于荷兰语(nl)的临床自然语言处理实验。研究者可直接加载数据集,利用‘report’字段作为输入文本,‘topic’字段作为分类标签,训练或评估机器学习模型在护理主题识别上的性能。鉴于其合成性质,建议将其作为概念验证或模型预训练的基准数据集使用,而非直接部署于真实临床环境。使用时需注意潜在的模型偏见,并遵循CC-BY-SA-4.0许可协议进行引用与分发。推荐结合官方提供的生成脚本深入理解数据分布,以优化下游任务中的迁移学习策略。
背景与挑战
背景概述
在临床自然语言处理领域,护理机构中的非结构化文本数据蕴含着丰富的信息,但受限于隐私法规和数据获取难度,真实医疗记录的公开可用性极低。为应对这一瓶颈,ekrombouts等人于近期构建了名为dutch_nursing_home_notes的合成数据集,由经验丰富的老年医学专家设计提示词,借助OpenAI的GPT-3.5模型生成。该数据集聚焦于荷兰语养老院护理记录,涵盖日常生活活动、饮食、社交、皮肤护理、医疗后勤、夜间护理、躁动、症状及行动能力等九大主题,旨在模仿真实场景下的客户笔记,为机器学习与数据分析实验提供安全、匿名的替代资源。其发布遵循CC-BY-SA-4.0许可,推动了低资源语言在临床文本分类研究中的发展。
当前挑战
该数据集面临的核心挑战包括:首先,领域问题层面,养老院护理记录的多标签分类与语义理解任务因文本的非结构化、口语化及专业术语混杂而极具难度,现有模型在区分细微主题(如‘不安’与‘症状’)时易产生混淆,且荷兰语医疗NLP资源匮乏,限制了模型泛化能力。其次,构建过程中,合成数据虽规避了隐私风险,但生成模型可能继承训练数据中的社会偏见,导致某些群体或护理场景的失真表征;同时,由单一老年医学专家设计的提示词可能引入主观倾向,无法覆盖所有护理情境的多样性,从而影响数据集的真实性与代表性。
常用场景
经典使用场景
在临床自然语言处理领域,荷兰养老院护理笔记数据集为多标签文本分类任务提供了理想的实验平台。该数据集将护理报告细分为日常生活活动、饮食摄入、社交互动、皮肤状况、医疗后勤、夜间护理、躁动行为、症状管理和活动能力等九个主题类别,使研究者能够训练模型自动识别和归类养老院护理记录中的关键信息维度。这种精细化的分类体系不仅支持对护理文本的语义解析,还为构建医疗文档自动标注系统奠定了数据基础。
解决学术问题
该数据集有效解决了医疗领域标注数据稀缺且隐私保护严格的学术困境。通过生成式AI技术合成的护理记录,既规避了真实患者数据的隐私泄露风险,又保留了临床文本的语言特征和领域特异性。研究者得以在无伦理审查障碍的条件下,探索小样本学习、领域自适应和医疗文本预训练模型等前沿课题,推动了临床自然语言处理在养老护理这一细分场景的方法论创新。
衍生相关工作
该数据集衍生了一系列经典研究,包括基于荷兰语医疗文本的领域预训练语言模型开发、跨机构护理记录语义对齐的迁移学习框架,以及结合知识图谱的护理事件推理系统。GenCareAI生成框架本身也成为合成医疗数据领域的标杆工作,其提示工程设计方法被后续研究广泛借鉴。此外,该数据集还支撑了多语言临床文本分类的基准测试,推动了非英语医疗自然语言处理技术的国际化发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

