遇见数据集

SoLID/shellcode_i_a32

收藏
Hugging Face2022-11-17 更新2024-03-04 收录
官方服务:

资源简介:

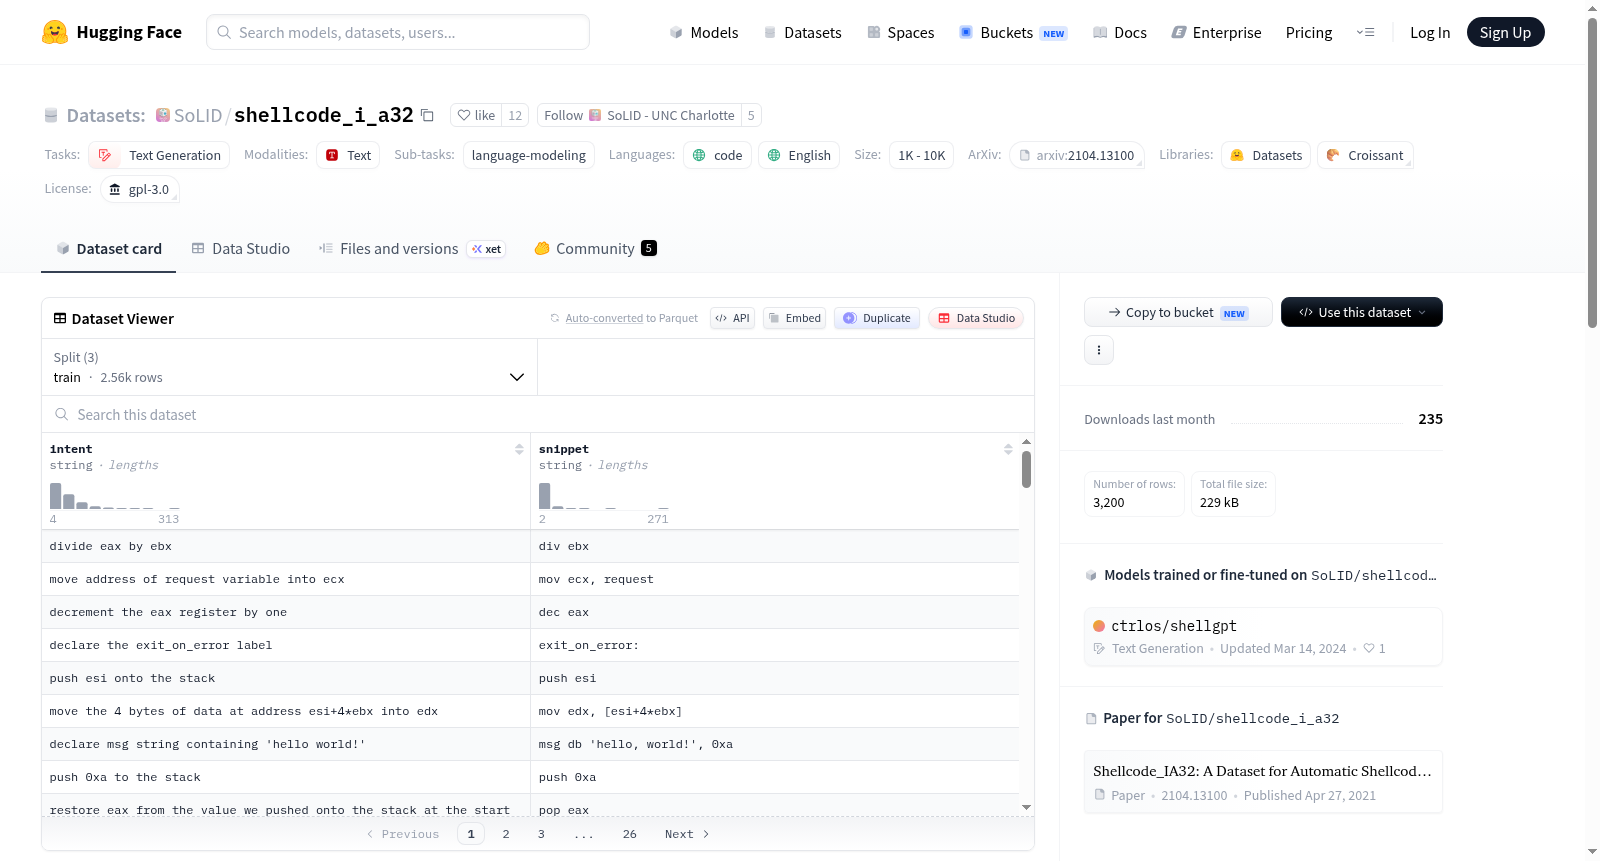
Shellcode_IA32数据集包含了20年来从多种来源收集的shellcode,是目前最大的汇编语言shellcode集合。该数据集包含3200个IA-32架构(x86 Intel Architecture的32位版本)的汇编指令示例,主要来源于公开的安全漏洞利用,如exploit-db和shell-storm。此外,数据集还包括从教程和书籍中收集的汇编程序示例,以理解不同作者和汇编专家如何注释代码,并处理自然语言的歧义。数据集中10%的指令来自书籍和指南,其余来自真实的shellcode。数据集的主要用途是用于自动生成shellcode的研究,特别是在自然语言处理与编程结合的领域。

The Shellcode_IA32 dataset, comprising shellcode collected from multiple sources over the past two decades, is the largest assembly language shellcode corpus to date. This dataset includes 3,200 assembly instruction examples for the IA-32 architecture (the 32-bit variant of the x86 Intel Architecture), primarily sourced from publicly disclosed security exploit materials such as exploit-db and shell-storm. Additionally, the dataset contains assembly program examples collected from tutorials and books, designed to facilitate the study of how different authors and assembly experts annotate code and handle natural language ambiguities. Ten percent of the instructions in this dataset are sourced from books and guides, while the remaining portion comes from real-world shellcode. The primary use case of this dataset is research on automated shellcode generation, particularly in the interdisciplinary field combining natural language processing and programming.

提供机构:
SoLID
原始信息汇总

Shellcode_IA32 数据集概述

数据集基本信息

  • 名称: Shellcode_IA32
  • 描述: 包含20年来的shellcode数据,是目前最大的汇编语言shellcode集合。
  • 语言: 代码(汇编语言)、英语
  • 许可证: GPL-3.0
  • 多语言性: 翻译
  • 大小类别: 未知
  • 来源: 原始数据
  • 任务类别: 文本生成
  • 任务ID: 语言建模
  • Paperswithcode ID: shellcode-ia32

数据集内容

  • 组成: 包含3,200个IA-32架构的汇编语言指令示例,来源于公开的安全漏洞利用。
  • 数据来源: 收集自exploit-db和shell-storm。
  • 数据增强: 通过添加来自流行教程和书籍的汇编程序示例,以理解不同作者和汇编专家的注释方式。
  • 数据结构: 每行数据代表一个“代码片段-意图”对,其中“代码片段”是遵循NASM语法的汇编代码行或组合,“意图”是英语注释。

应用场景

  • 重点: 专注于Linux操作系统,最常用的安全关键网络服务操作系统。
  • 工具: 使用Netwide Assembler (NASM) 编写的Linux汇编指令。

相关研究

搜集汇总
数据集介绍
SoLID/shellcode_i_a32 数据集图片
构建方式
在信息安全领域,shellcode作为漏洞利用的核心载荷,其自动生成技术具有重要的研究价值。Shellcode_IA32数据集汇聚了跨越二十年的公开shellcode资源,从exploit-db和shell-storm等权威来源采集了3200条IA-32架构下的汇编指令示例。为增强数据集的多样性与代表性,研究团队还从流行教程与专业书籍中补充了约10%的汇编程序样本,以捕捉不同作者在注释风格上的差异,从而应对自然语言在特定上下文中的歧义性。每条数据由遵循NASM语法的汇编代码片段及其对应的英文意图注释构成,形成代码-语义的配对结构。
特点
该数据集最显著的特征在于其专注于Linux平台下的IA-32架构,这一选择基于Linux作为安全关键网络服务主流操作系统的现实考量。数据集中的汇编指令均采用Netwide Assembler(NASM)语法编写,确保了代码格式的统一性与实用性。尤为重要的是,数据集中90%的样本源自真实的shellcode,而非人工构造的示例,这使得模型能够学习到真实攻击场景中的编码模式与惯用表达。此外,数据集包含了长达二十年的时间跨度,覆盖了不同时期的安全技术演进,为研究shellcode的演变规律提供了宝贵素材。
使用方法
该数据集主要面向文本生成与语言建模任务,尤其适用于神经机器翻译(NMT)方法的探索。研究者可将汇编代码片段视为源语言,将英文意图注释视为目标语言,训练模型实现从自然语言描述到汇编指令的自动转换。在使用时,建议按照标准NMT流程对数据进行预处理,包括分词、词汇表构建与序列长度截断。数据集已在HuggingFace平台发布,可通过datasets库直接加载,同时也在DESSERT Lab的GitHub仓库中提供备份。配套论文中详细描述了基线实验的设置与评估指标,为后续研究提供了可复现的基准参考。
背景与挑战
背景概述
Shellcode_IA32数据集由意大利那不勒斯费德里科二世大学DESSERT实验室的研究人员Pietro Liguori等人于2021年创建,旨在填补自动生成shellcode这一安全关键任务中数据资源的空白。该数据集汇集了来自exploit-db和shell-storm等公开来源的IA-32架构汇编指令,并辅以经典教程与书籍中的代码示例,形成了目前规模最大的可公开获取的汇编级shellcode集合。其核心研究问题在于探索如何利用神经机器翻译模型,从自然语言注释自动生成用于软件漏洞利用的载荷代码。这一工作不仅为自然语言处理与软件安全领域的交叉研究提供了基础数据支撑,还推动了自动化漏洞利用技术的发展,对相关领域产生了显著影响。
当前挑战
该数据集面临的核心挑战在于解决从自然语言到汇编指令的语义映射难题,即如何准确理解安全领域特定的自然语言描述并生成功能正确的shellcode。此外,数据构建过程中也遭遇了多重困难:首先,真实shellcode来源多样且注释风格迥异,需要人工专家进行清洗和标准化;其次,从教程和书籍中补充的指令仅占10%,需确保其与真实漏洞利用场景的兼容性;最后,数据集聚焦于Linux平台和NASM语法,限制了其在跨平台或不同汇编器环境下的泛化能力,这些挑战共同制约了模型在自动shellcode生成任务上的性能表现。
常用场景
经典使用场景
在自然语言处理与程序合成交叉领域,Shellcode_IA32数据集被广泛用于研究从自然语言注释到汇编指令序列的自动生成任务。该数据集汇集了来自exploit-db和shell-storm等公共漏洞库的3200条IA-32架构汇编片段,每条样本均包含对应的英文意图描述。其经典使用场景是作为神经机器翻译模型的训练语料,旨在将人类可读的安全攻击意图转化为机器可执行的shellcode,为代码生成领域提供了首个聚焦于安全载荷的标准化基准。
衍生相关工作
该数据集衍生了一系列基于序列到序列模型的shellcode生成研究,其中Liguori等人在2021年ACL NLP4Prog会议上发表的论文首次建立了基于注意力机制的翻译基线。后续工作进一步探索了Transformer架构、预训练语言模型(如CodeBERT)在该任务上的应用,并针对汇编代码的语法约束提出了结构化解码策略。此外,Shellcode_IA32还催生了多模态代码理解与生成方向的研究,启发学者将自然语言注释、汇编指令与运行时行为进行联合建模,推动了程序合成与软件安全交叉领域的持续发展。
数据集最近研究
最新研究方向
在网络安全与自然语言处理交叉领域,Shellcode_IA32数据集的出现标志着自动化漏洞利用技术迈入新阶段。该数据集整合了二十年间的真实shellcode样本与汇编语言教学资源,构建了包含3200条指令-意图对的平行语料库,聚焦于Linux平台下IA-32架构的NASM语法汇编代码。当前前沿研究方向集中于利用神经机器翻译模型实现从自然语言注释到可执行shellcode的端到端生成,这一突破性进展有望显著降低安全分析人员的手动编码负担,加速漏洞验证与渗透测试流程。伴随深度学习在程序合成领域的持续突破,该数据集为研究代码语义理解、汇编语言生成以及对抗性样本构造提供了标准化基准,其影响力已延伸至自动化逆向工程与智能入侵检测系统的研发,成为连接传统漏洞利用技术与现代AI安全防御体系的关键枢纽。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务