
mstz/muskV2
收藏官方服务:
资源简介:
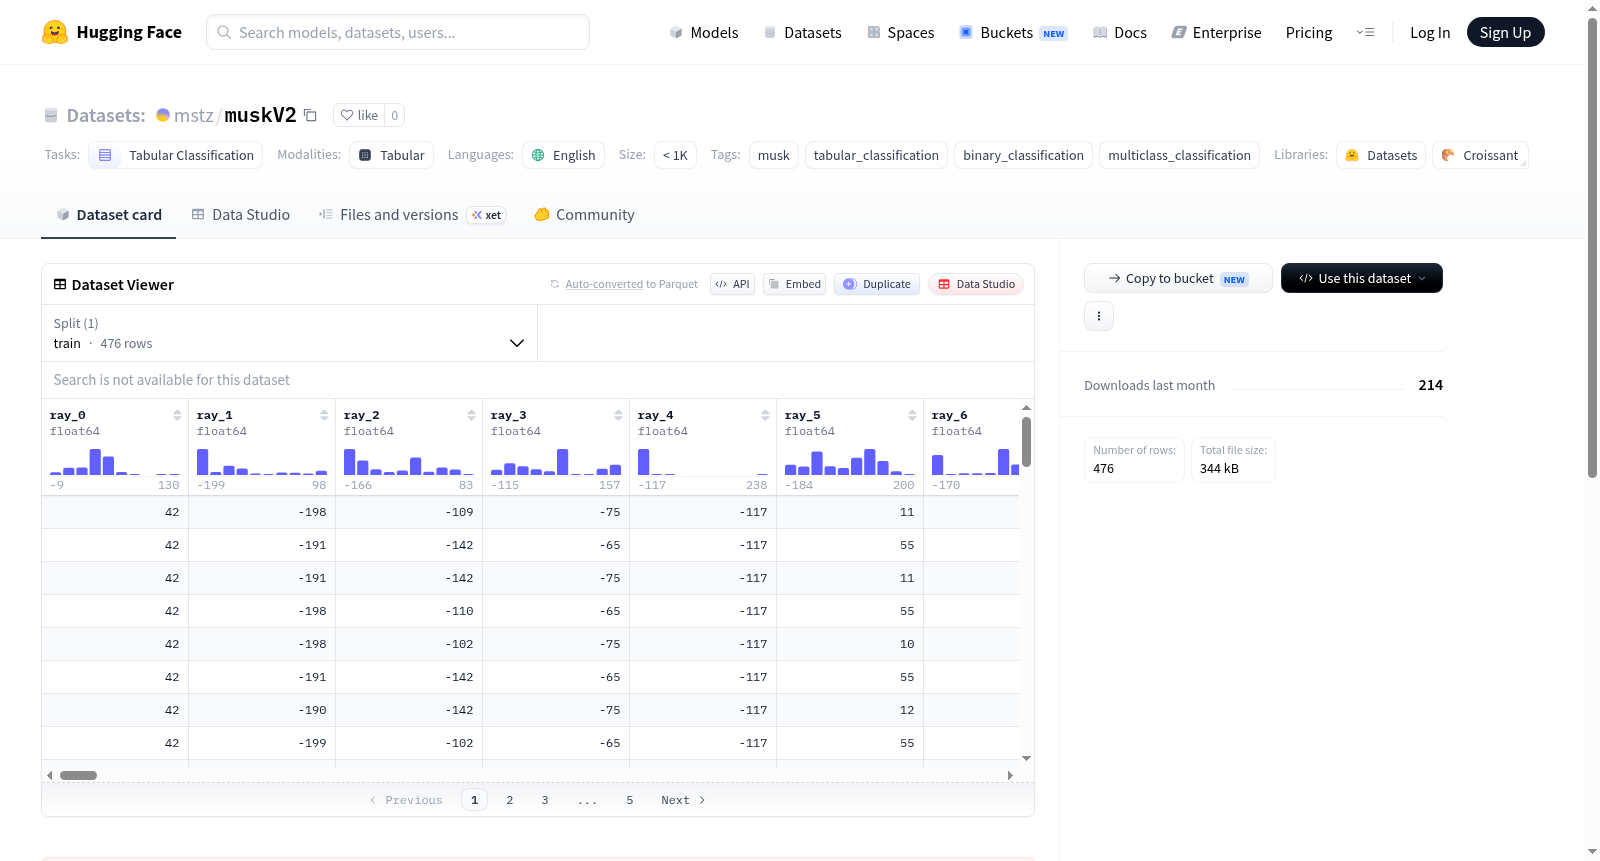
Musk数据集来自UCI ML仓库,包含个人特征及其收入阈值信息。该数据集主要用于二元分类任务,即判断分子是否为麝香。
Musk数据集来自UCI ML仓库,包含个人特征及其收入阈值信息。该数据集主要用于二元分类任务,即判断分子是否为麝香。
提供机构:
mstz原始信息汇总
数据集概述
基本信息
- 名称: Musk
- 语言: 英语
- 标签:
- musk
- tabular_classification
- binary_classification
- multiclass_classification
- 美观名称: Musk
- 大小范围: 100<n<1K
- 任务类别: tabular-classification
- 配置: musk
详细描述
- 来源: 来自UCI ML repository的Musk dataset。
配置与任务
| 配置 | 任务 | 描述 |
|---|---|---|
| musk | Binary classification | 判断分子是否为麝香 |
使用示例
python from datasets import load_dataset
dataset = load_dataset("mstz/muskV2")["train"]
搜集汇总
数据集介绍
构建方式
Musk数据集源自UCI机器学习库,旨在解决分子分类问题,特别是判断某分子是否具有麝香特性。该数据集通过收集分子的多种物理化学特征构建而成,每个样本包含166维特征向量,这些特征描述了分子在不同构象下的属性。数据集包含659个样本,其中约97个为正类(麝香分子),其余为负类,构成一个典型的二分类任务。构建过程注重特征的高维性和样本的稀疏性,为评估分类算法在复杂化学数据上的性能提供了基准。
特点
该数据集的核心特点在于其高维特征空间与样本量之间的不平衡,166个特征相对于659个样本而言维度较高,容易引发维数灾难问题,因此对特征选择和降维技术具有挑战性。此外,数据集的标签分布不均衡,正类样本仅占约14.7%,这要求模型在处理类别不平衡时具备鲁棒性。Musk数据集还支持多分类扩展,尽管默认配置为二分类,但其结构允许探索更复杂的分类场景。这些特性使其成为测试机器学习算法在化学信息学领域适用性的经典案例。
使用方法
使用Musk数据集时,可通过Hugging Face的datasets库直接加载,调用load_dataset('mstz/muskV2')获取训练集。数据以表格形式组织,每行对应一个样本的166维特征及标签。用户可将其直接用于二分类模型训练,例如逻辑回归、支持向量机或随机森林。由于特征维度较高,建议先进行标准化或降维处理,如主成分分析。数据集还支持交叉验证和超参数调优,以评估模型在类别不平衡条件下的泛化能力。加载后的数据可通过['train']键访问,便于集成到Python工作流中。
背景与挑战
背景概述
麝香(Musk)分子识别在药物化学与香料工业中具有重要价值,其核心在于从海量分子结构中准确区分出具有麝香气味的化合物。muskV2数据集源自UCI机器学习库,由研究人员基于分子构象特征构建,旨在解决二元分类问题——判断一个分子是否为麝香。该数据集创建于20世纪90年代,是早期分子信息学领域的经典基准之一,其影响力体现在推动了机器学习方法在化学信息学中的应用,为后续分子活性预测研究奠定了数据基础。数据集包含数百个样本,每个样本由166维分子特征描述,反映了当时计算化学与模式识别交叉领域的前沿探索。
当前挑战
该数据集面临的挑战首先源于领域问题的复杂性:分子构象与气味感知之间的非线性关系难以通过简单特征捕捉,且麝香类别在样本中分布不均,导致模型易偏向多数类。其次,构建过程中存在显著困难:原始分子结构需通过物理化学实验或量子力学计算转化为特征向量,这一过程不仅耗时且受限于计算资源;此外,不同分子构象的多样性增加了标注的模糊性,同一分子在不同构象下可能呈现不同气味属性,使得人工标注标准难以统一,进而影响数据质量与模型泛化能力。
常用场景
经典使用场景
Musk数据集作为化学信息学与机器学习交叉领域的经典基准,其核心应用场景在于分子性质预测,特别是针对麝香类分子的二元分类任务。该数据集通过整合分子结构特征与物理化学描述符,为研究人员提供了一个标准化的平台,用以评估和比较不同分类算法在化学空间中的泛化能力。在药物发现与材料科学领域,研究者常利用该数据集验证模型对复杂分子构效关系的捕捉能力,从而筛选出具有特定生物活性的候选化合物。
衍生相关工作
围绕该数据集衍生出一系列标志性工作,包括基于支持向量机(SVM)的分子活性分类框架、融合图神经网络(GNN)的分子指纹学习方法,以及利用集成策略提升预测稳定性的随机森林模型。后续研究进一步拓展了其应用边界,如结合迁移学习实现跨数据集的知识迁移,或引入对抗训练增强模型对噪声分子特征的鲁棒性。这些工作不仅深化了对分子空间结构-活性关系的理解,也催化了化学信息学与深度学习技术的深度融合。
数据集最近研究
最新研究方向
在当前化学信息学与机器学习交叉的前沿领域,MuskV2数据集作为分子构象分类的经典基准,持续推动着分子活性预测与构效关系研究的发展。该数据集聚焦于区分分子是否具有麝香气味特性,这一任务与药物发现中关键的性质预测问题紧密相关,尤其是在虚拟筛选和先导化合物优化阶段。近期研究趋势显示,该数据集被广泛用于评估图神经网络和注意力机制在分子表征学习中的泛化能力,同时结合可解释性分析方法探索分子结构与生物活性之间的内在关联。随着深度学习在化学空间探索中的深入应用,MuskV2数据集的二元分类挑战已成为检验模型对高维、稀疏特征处理能力的试金石,其研究意义在于为自动化分子设计提供更可靠的预测工具,并推动计算化学与人工智能的深度融合。
以上内容由遇见数据集搜集并总结生成


