qwen3.8-27b-apple-silicon-concurrency
收藏资源简介:
该数据集记录了在 Apple Silicon Mac(M系列,128 GB 统一内存)上使用三种服务引擎(oMLX、SGLang-MLX、Ollama)并发服务 Qwen3.8-27B 模型的基准测试结果。数据包括不同并发数(1、4、8、16)下,处理约1.5k token 提示词并生成64 token 输出时的聚合吞吐量(tok/s),以及16并发下生成256 token 输出的吞吐量。此外,还包含原生 MTP 投机解码(单流)的加速数据(bf16 9→26 tok/s,8-bit 36,4-bit 62)。所有测试请求均成功完成,无错误。该数据集适用于评估大语言模型在 Apple Silicon 上的并发推理性能、比较不同推理引擎的效率,以及研究连续批处理、投机解码等优化技术。
This dataset records benchmark results of serving the Qwen3.8-27B model concurrently using three serving engines (oMLX, SGLang-MLX, Ollama) on Apple Silicon Mac (M-series, 128 GB unified memory). Data includes aggregated throughput (tok/s) for processing ~1.5k token prompts and generating 64 token outputs under different concurrency levels (1, 4, 8, 16), as well as throughput for generating 256 token outputs at 16 concurrency. Additionally, it includes acceleration data for native MTP speculative decoding (single stream) (bf16 9→26 tok/s, 8-bit 36, 4-bit 62). All test requests were completed successfully with no errors. This dataset is suitable for evaluating concurrent inference performance of large language models on Apple Silicon, comparing the efficiency of different inference engines, and studying optimization techniques such as continuous batching and speculative decoding.
数据集概述
名称: Qwen3.8-27B concurrent serving on Apple Silicon
许可证: Apache-2.0
标签: apple-silicon、mlx、sglang、ollama、qwen3.8、benchmark、inference、concurrency、speculative-decoding
简介: 该数据集提供了在单个 Apple Silicon Mac(M系列,128 GB统一内存)上实现16个并发Qwen3.8-27B请求的研究成果,涵盖三种服务引擎的基准测试、补丁及复现配方,其中包含使SGLang原生MLX后端首次服务于该模型的关键补丁。
核心结果
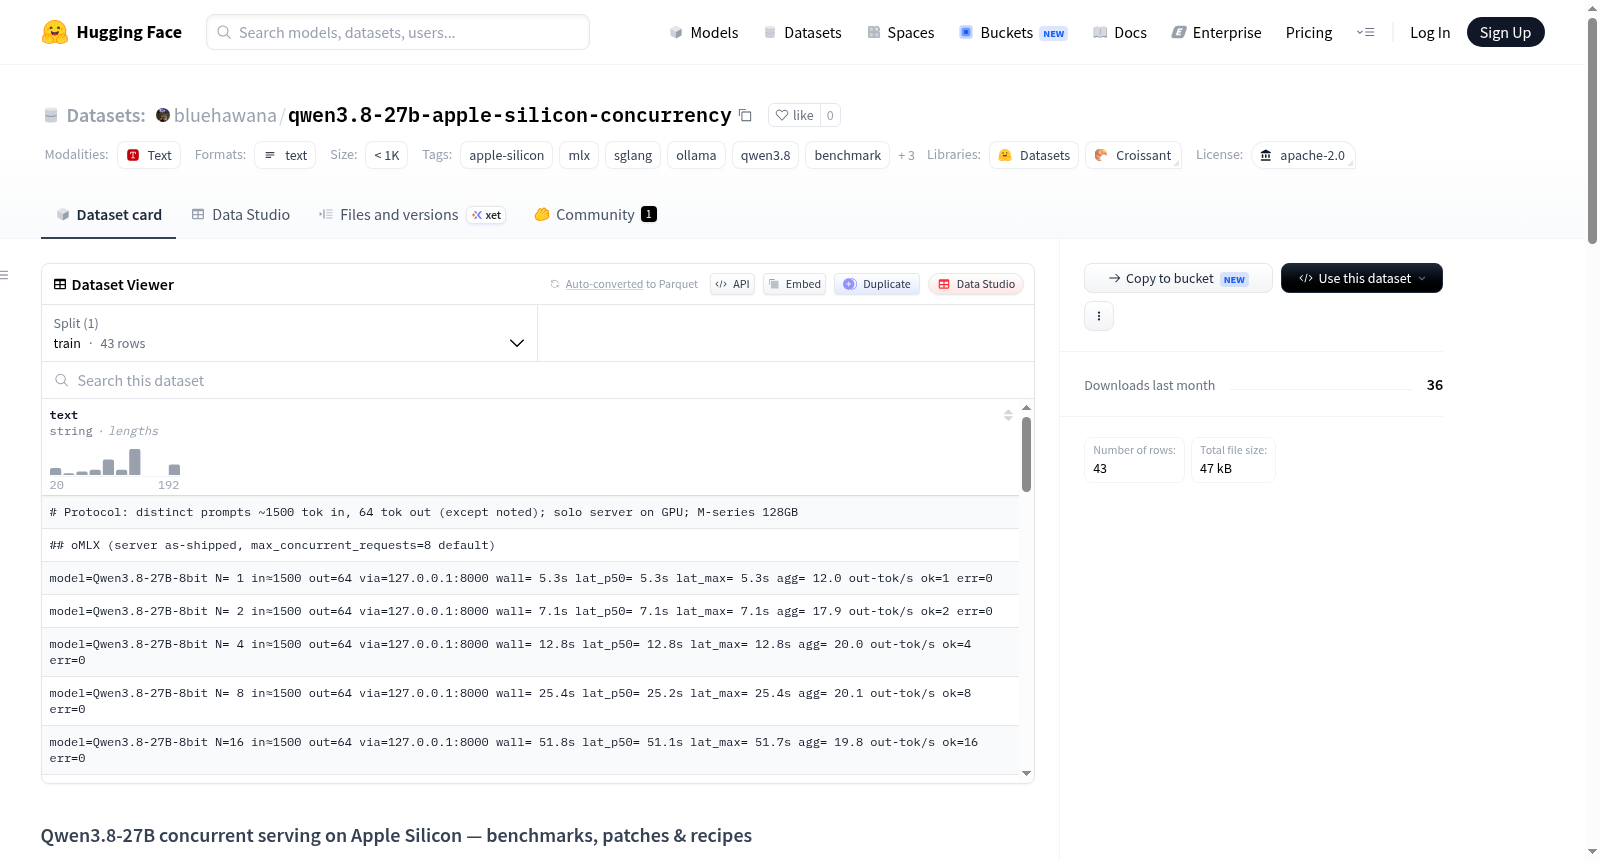
在独立GPU、不同长度提示词(约1.5k token)和64 token输出条件下,各引擎的聚合吞吐量(tok/s)如下:
| 并发数 | oMLX(MLX 8-bit) | SGLang-MLX(补丁后) | Ollama 0.32(GGUF Q8_0) |
|---|---|---|---|
| 1 | 12.0 | 10.3 | 6.8 |
| 4 | 20.0 | 19.8 | 14.3 |
| 8 | 20.1 | 21.6 | 13.8 |
| 16 | 19.8 | 21.0 | 13.6 |
| 16 × 256 token 输出 | 35.7 | 47.4 | 16.8 |
所有测试均100%成功,零错误。结果证明27B稠密模型可在单台Mac上真正服务16个并发客户端。
关键发现
- 限制模型内并发,队列化其余请求(
--max-running-requests/max_concurrent_requests/OLLAMA_NUM_PARALLEL)——这是从CUDA服务栈迁移到Metal的关键思想。 - 短输出负载受预填充阶段限制,在N=4时趋于平台期;长输出场景下连续批处理可显著提升吞吐量(最高达单流解码速率的4.5倍)。
- SGLang的radix-cache调度器在处理解码密集型负载时胜出(N=16时比oMLX高33%);oMLX在单用户延迟上表现最佳;Ollama最简单且完全稳定,但速度慢1.5–3倍。
- GPU争用是首要的假阴性来源——当第二个30GB模型驻留时,相同硬件在N=6时“崩溃”并最终触发Metal内存不足。多数“Mac无法并发服务”的报告均源于此,建议一次仅运行一个模型服务器。
文件内容
| 文件 | 内容 |
|---|---|
BENCHMARKS.md |
三引擎阶梯测试及完整分析 |
RESEARCH.md |
社区调研(vllm-mlx、mlx-lm批处理、HN/X发现) |
OLLAMA.md |
使用Ollama运行及并发服务指南 |
OMLX.md |
使用oMLX运行及并发服务指南(1-4用户最佳) |
MTP.md |
oMLX原生MTP推测解码:bf16 9→26 tok/s、8-bit 36、4-bit 62(单流)+ Claude Code启动器修复 |
mtp-20260818.txt |
MTP基准测试原始输出 |
ladder-20260816.txt |
阶梯测试原始输出 |
sglang-mlx-qwen38.patch |
4文件补丁:SGLang-MLX服务Qwen3.8-27B(hybrid-GDN缓存、VLM检查点纯文本、2个批量加载设备缺陷) |
PATCH-NOTES.md |
每个补丁的存在原因及崩溃签名 |
bench_concurrency.py |
仅依赖标准库的基准测试工具 |
复现SGLang路径
bash git clone https://github.com/bluehawana/Qwen3.827B-SGLang-mpbm5max cd Qwen3.827B-SGLang-mpbm5max ./build-sglang-metal.sh # 需要Xcode Metal工具链;自动应用补丁 MAX_CONC=16 ./sglang-metal/serve-sglang-metal.sh
关键启动参数:SGLANG_USE_MLX=1、--json-model-override-args {"language_model_only": true}(以纯文本模式运行VLM检查点,无对应CLI标志)、--mamba-radix-cache-strategy no_buffer(hybrid-GDN默认路径仅支持CUDA),外加附带补丁。
相关链接
- 基础模型:https://huggingface.co/Qwen/Qwen3.8-27B (Apache-2.0)
- MLX量化版:https://huggingface.co/mlx-community/Qwen3.8-27B-8bit
- GGUF版本:https://huggingface.co/AtomicChat/Qwen3.8-27B-GGUF
- 运行方式(Ollama):
ollama run bluehawana/qwen3.8-27b-q8 - 快速单流(MTP推测解码,oMLX):
bluehawana/Qwen3.8-27B-{4bit,8bit,bf16}-MTP-MLX,详见MTP.md