遇见数据集

mohit-raghavendra/self-instruct-wikipedia

收藏
Hugging Face2023-12-24 更新2024-03-04 收录
官方服务:

资源简介:

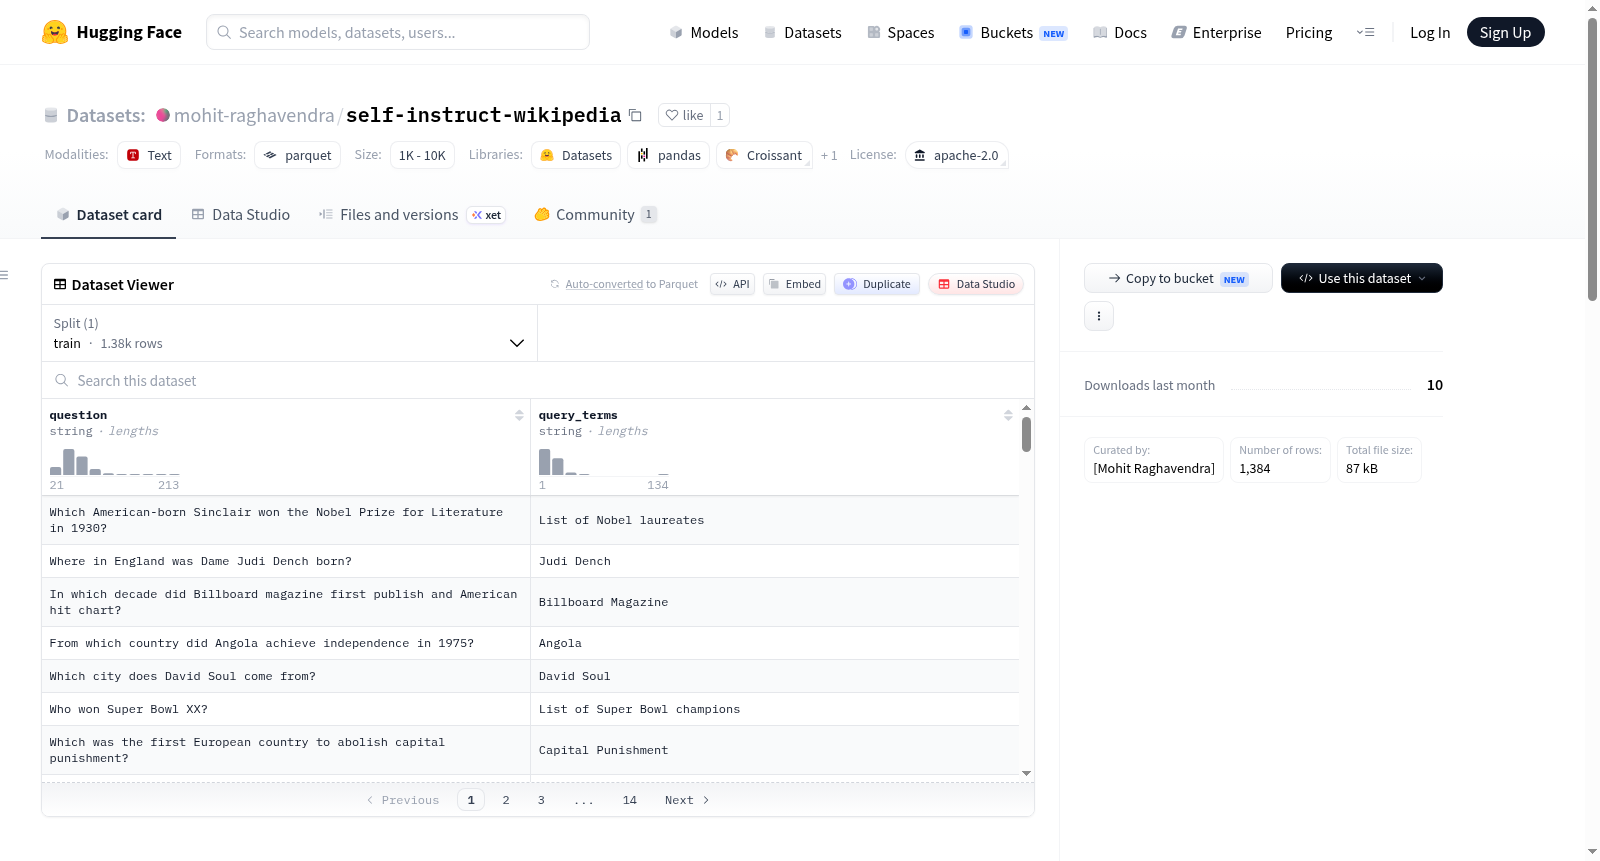
这是一个由人类和大型语言模型(LLM)共同注释的Wikipedia搜索术语数据集。数据集包含了来自TriviaQA数据集的问题,以及可能在回答这些问题时需要在Wikipedia中搜索的术语。注释过程采用了自指导格式,其中一小部分注释由人类完成,并作为k-shot示例输入到Gemini-Pro模型中,以注释数据集的其余部分。

这是一个由人类和大型语言模型(LLM)共同注释的Wikipedia搜索术语数据集。数据集包含了来自TriviaQA数据集的问题,以及可能在回答这些问题时需要在Wikipedia中搜索的术语。注释过程采用了自指导格式,其中一小部分注释由人类完成,并作为k-shot示例输入到Gemini-Pro模型中,以注释数据集的其余部分。

提供机构:
mohit-raghavendra
原始信息汇总

数据集卡片

数据集详情

数据集描述

  • 数据集名称: 未明确提及,但基于内容可推测为与TriviaQA相关的搜索词标注数据集。
  • 数据来源: TriviaQA数据集的一个子样本,具体为TriviaQA数据集训练集的前1%。
  • 数据集大小: 116267字节
  • 样本数量: 1384个样本
  • 下载大小: 82027字节
  • 特征:
    • question: 问题,数据类型为字符串。
    • query_terms: 搜索词,数据类型为字符串。
  • 数据分割:
    • train: 训练集,包含1384个样本,大小为116267字节。

数据集创建

数据收集和处理

  • 数据子样本: 从TriviaQA数据集的训练集中提取的前1%样本。
  • 数据加载代码: python datasets.load_dataset("trivia_qa", "rc.nocontext", split="train[:1%]")

标注

  • 初始标注: 前30个样本由作者手动标注。

  • 模型标注: 使用Gemini-Pro模型,基于前30个样本作为k-shot示例(k=10),标注剩余数据集。

  • 系统消息: python SYSTEM_MESSAGE = f"""There exists a wikipedia summarizer that can return a summary for a topic. Your job is to act as an aid to a question answering tool. Whenever you are asked about a question related to general knowledge, instead of using your internal knowledge (which can be faulty or out of date), format a Wikipedia search query string that can help answer the question.

    Wikipedia Entries are usually about a simple entity or event, so keep the query short, and about the entity being asked about. Also, dont use your knowledge to ask about the answer. Instead form queries about the entity in the question. This will help you get the right wikipedia entries for questions when you dont know the answer """

使用场景

  • 应用: 用于微调一个代理,根据给定的问题,找到在Wikipedia中搜索的相关词条。

数据集作者

  • 作者: Mohit Raghavendra
搜集汇总
数据集介绍
mohit-raghavendra/self-instruct-wikipedia 数据集图片
构建方式
该数据集名为 self-instruct-wikipedia,其构建基于 Trivia QA 数据集的子样本,具体选取了训练集中前 1% 的数据。构建过程采用人机协同的标注策略:首先由作者人工标注前 30 个样本作为少量示例,随后利用这些示例以 k-shot(k=10)方式引导 Gemini-Pro 模型,通过自指令(self-instruct)格式对剩余数据进行自动标注。模型被赋予系统指令,要求其为给定问题生成简洁的 Wikipedia 搜索查询词,而非依赖内部知识直接回答,从而确保查询聚焦于问题所涉及的实体。
使用方法
该数据集主要用于微调语言模型,使其能够根据用户提出的问题,自主生成合适的 Wikipedia 搜索查询词。使用时,可将数据集加载为 Hugging Face Dataset 格式,利用 train 分片进行训练。模型通过监督学习掌握从问题到搜索词的映射关系,从而在推理阶段为未知问题生成检索关键词。这一方法可集成到检索增强生成(RAG)流水线中,作为查询生成模块,提升问答系统对时效性知识的获取能力。
背景与挑战
背景概述
在自然语言处理领域,知识密集型问答任务长期面临检索与推理的鸿沟,即模型需在庞杂的百科知识库中精准定位信息源以支撑答案生成。由Mohit Raghavendra于近期创建的self-instruct-wikipedia数据集,正是为解决这一痛点而设计。该数据集基于TriviaQA的1%训练子集,通过自指令范式融合人类与LLM(Gemini-Pro)的协作标注,为每个问题生成对应的维基百科检索词。研究者以30条人工标注为种子,采用10-shot示例引导模型完成剩余标注,旨在构建一个可微调智能体以优化搜索查询的基准资源。该工作虽规模有限(1384条样本),却开创性地将指令微调与检索策略结合,为缩小开放域问答中语言模型与检索系统间的协同差距提供了新范式。
当前挑战
该数据集的核心挑战首先在于领域问题的复杂性:现有问答系统常因检索词不精确而引入噪声,导致生成答案偏离事实,而人工设计高效查询规则又难以覆盖知识多样性。self-instruct-wikipedia试图通过生成式模型自动优化查询,但面临搜索词与问题语义对齐的难题——例如多义词或隐含实体需避免歧义。其次,构建过程中存在显著挑战:人工标注仅30条,其代表性不足可能引入偏差,且Gemini-Pro模型在剩余样本上的自指令生成易受示例选择影响,导致部分查询冗余或缺失关键实体。此外,数据集仅采样TriviaQA的1%数据,规模局限性使模型泛化性存疑,而缺乏多语言或跨领域覆盖更限制了其在现实场景中的鲁棒性。
常用场景
经典使用场景
在信息检索与问答系统的交叉领域中,self-instruct-wikipedia数据集被广泛用于训练智能代理,使其能够根据给定的自然语言问题,自主生成精准的维基百科搜索词。该数据集源自TriviaQA的子集,并经过人类与大型语言模型(Gemini-Pro)的协同标注,为模型提供了从问题到搜索查询的映射范例。其经典使用场景聚焦于提升代理在开放域问答中的信息获取能力,通过将复杂问题简化为实体或事件的检索关键词,从而有效规避模型依赖内部知识可能产生的幻觉与过时信息。
解决学术问题
该数据集旨在解决开放域问答系统中一个核心学术难题:如何弥合自然语言提问与结构化知识检索之间的语义鸿沟。传统方法往往依赖预定义的知识库或全文索引,难以灵活应对多样化的表达方式。self-instruct-wikipedia通过提供问题-搜索词对的微调数据,使模型学会将抽象疑问转化为具体、高效的维基百科查询语句。这一范式不仅提升了问答系统在未知事实场景下的鲁棒性,也为检索增强生成(RAG)领域提供了可复用的基准数据,推动了知识驱动型对话代理的发展。
实际应用
在实际应用中,该数据集赋能了智能客服、教育辅导及研究辅助等场景下的知识检索系统。例如,部署于企业级问答平台的代理可借助此数据集的训练范式,在用户询问“某历史事件发生的时间”时,自动提取“事件名称”作为维基百科搜索词,进而获取准确摘要。这种机制显著降低了人工编写搜索策略的成本,并提高了实时信息更新的效率。此外,在学术文献综述工具中,该数据集帮助模型将研究问题映射至学科条目,加速了跨领域知识的整合过程。
数据集最近研究
最新研究方向
当前,大语言模型在开放域问答任务中面临知识时效性与幻觉问题的双重挑战,而基于检索增强生成(RAG)的范式正成为突破瓶颈的核心路径。mohit-raghavendra/self-instruct-wikipedia数据集应运而生,其创新性地将人类专家注释与自指令生成技术相结合,从TriviaQA数据集中提取问题并映射至维基百科搜索词,构建起连接自然语言查询与结构化知识库的桥梁。这一方向精准回应了业界对可解释、可溯源问答系统的迫切需求,通过将模型内部知识调用转化为显式的检索行为,有效缓解了知识边界模糊与信息过时问题。该数据集不仅为智能体微调提供了高质量的训练样本,更推动了‘提问-检索-推理’双阶段架构的标准化进程,在知识密集型任务中展现出显著的应用潜力,为构建更可信、更鲁棒的知识驱动型AI系统奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务