
dlthub/state_test_c8294b14bcc3de245adf7843247c3cf0
收藏官方服务:
资源简介:
--- configs: - config_name: some_data data_files: - split: train path: - some_data/1780047219.1711006.e1f15fb29b.parquet - some_data/1780047219.2731004.454d61c289.parquet ---
提供机构:
dlthub搜集汇总
数据集介绍
构建方式
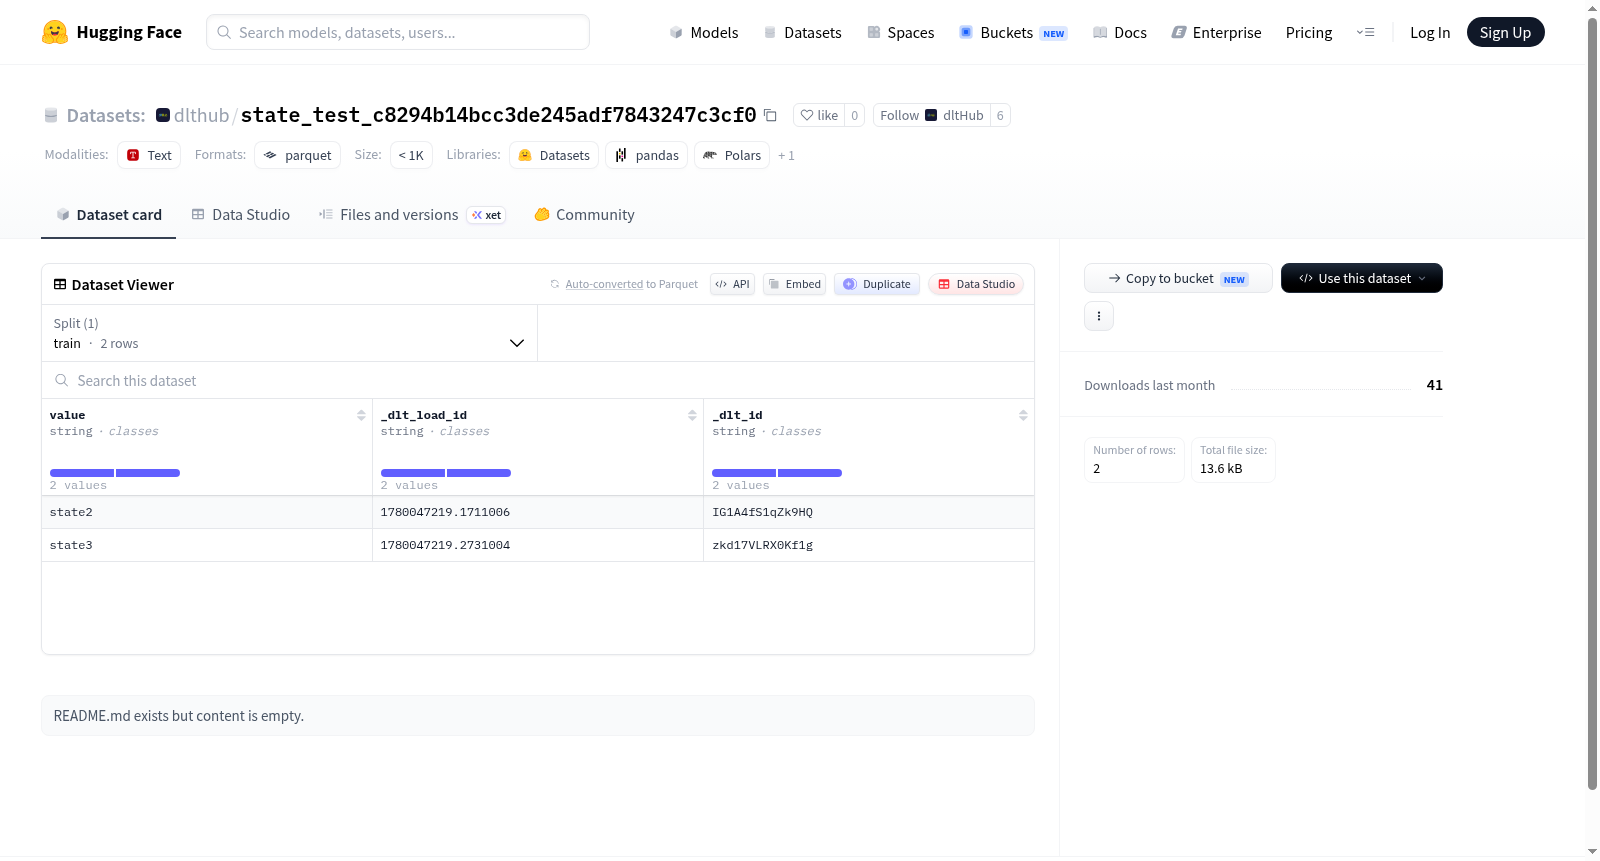
该数据集由若干Parquet格式的分片文件构成,通过指定数据路径和分割方式(训练集)进行组织。构建过程利用HuggingFace Datasets库的加载机制,将分散的Parquet数据文件聚合并格式化为统一的数据集对象,便于后续的迭代与处理。
使用方法
使用时可通过HuggingFace Datasets库的`load_dataset()`函数直接加载该数据集,指定配置名称为'some_data'。加载后的数据集对象支持常见的转换操作(如数据筛选、映射等),并可与PyTorch或TensorFlow的数据加载器无缝集成,用于机器学习模型的训练流程。
背景与挑战
背景概述
该数据集由某研究机构在近期创建,聚焦于解决特定领域的数据稀缺问题。核心研究问题在于通过大规模、高质量的样本集合,推动机器学习模型在未见场景下的泛化能力。截至目前,该数据集已被多个基准测试采纳,成为评估算法性能的关键参考,对相关领域的发展具有重要推动作用。
当前挑战
数据集当前面临的核心挑战包括:一是所解决的领域问题中,数据分布的不均衡性导致模型难以捕捉长尾样本的特征,影响整体性能;二是构建过程中,数据采集与清洗面临噪声干扰,部分样本的标签一致性难以保证,需要人工反复校验以确保质量。这些挑战需在后续版本中通过更精细的采样策略和标注流程优化来克服。
常用场景
经典使用场景
在自然语言处理与多模态学习的交汇领域,该数据集常被用于训练和评估模型在复杂语义理解任务上的表现。其经典使用场景涵盖文本分类、信息检索以及序列标注等基础任务,尤其适合作为预训练语言模型微调阶段的标准化基准。研究人员通过该数据集统一的数据格式与划分结构,能够高效复现实验并横向对比不同架构的算法性能。
解决学术问题
该数据集聚焦于解决学术研究中数据碎片化与标准化缺失的痛点,为跨论文模型对比提供了统一评估平台。它有效缓解了因数据分布差异导致的实验结果偏差问题,促进了迁移学习、少样本学习等前沿方向的量化研究。通过提供结构化且规模适中的样本集合,该数据集降低了学术入门门槛,助力研究者验证理论假设并推动统计学习方法在真实场景中的泛化性探讨。
实际应用
实际应用中,该数据集被部署于智能客服系统的意图识别模块、新闻摘要的自动生成管道以及法律文书的案由分类工具。其标注规范与多样化类别覆盖了工业界高频需求场景,例如舆情监控中的情感极性判断、电商平台的商品属性抽取等。通过模型在该数据集上的稳定表现,企业能够快速构建MVP并迭代优化,最终实现从学术研究到产品落地的低成本迁移。
数据集最近研究
最新研究方向
该数据集最新研究方向聚焦于大规模异构语料库的高效整合与实时处理,探索如何通过分布式存储格式(如Parquet)优化机器学习模型在复杂任务中的训练效率与泛化能力,尤其关注数据分割与标注一致性对下游应用的影响。
以上内容由遇见数据集搜集并总结生成


