allaimovies
收藏资源简介:
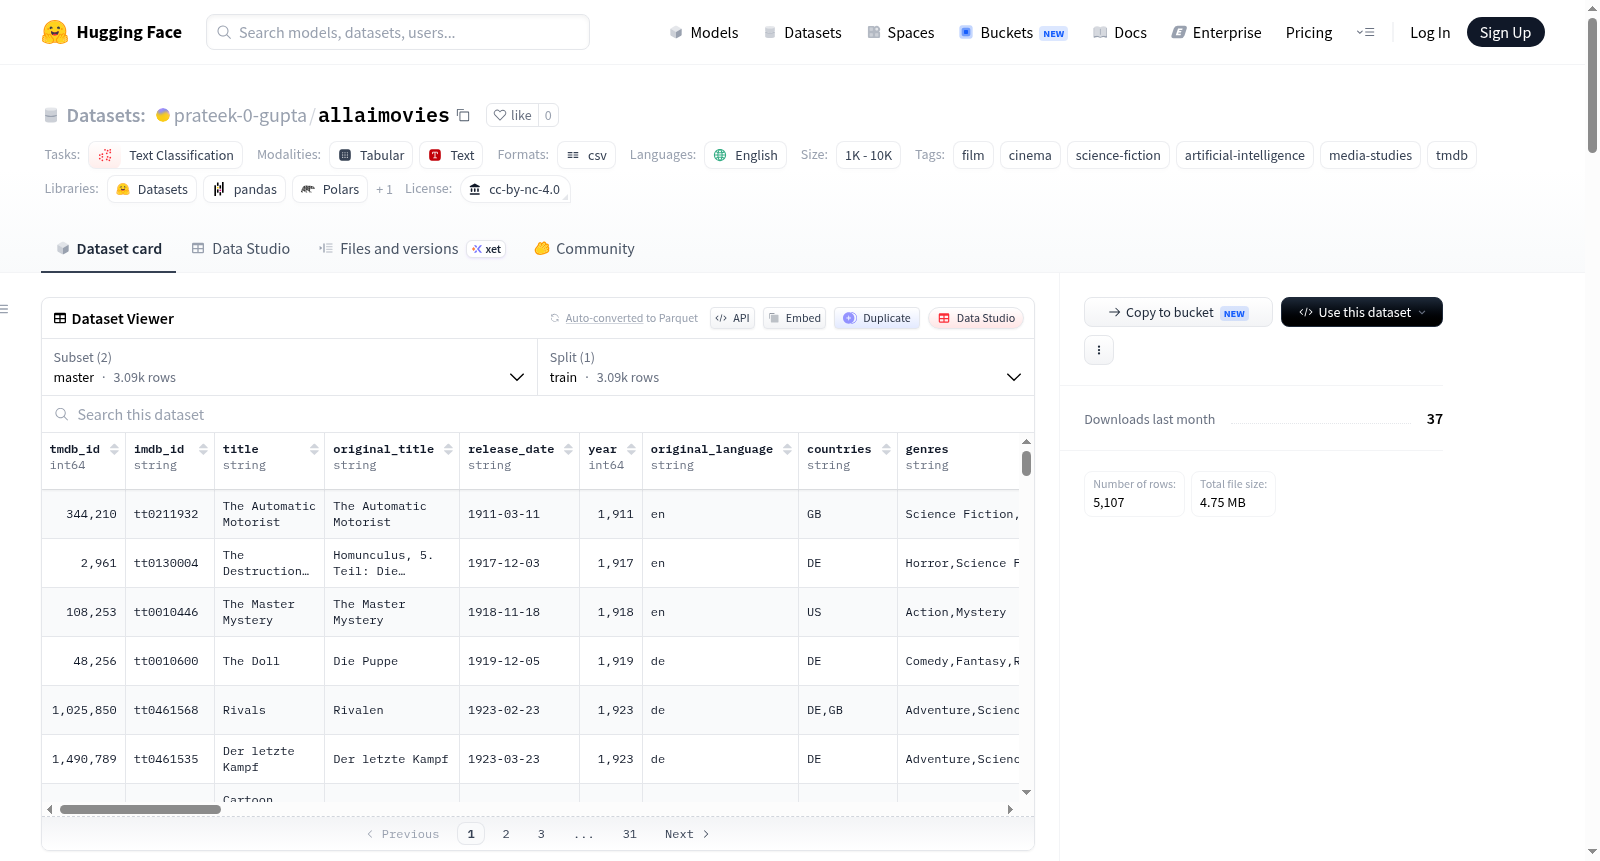
该数据集名为“allaimovies”,收录了1911年至2026年间所有在TMDB上被标记为科幻片且包含人工智能角色的电影。数据集包含两个配置:`master`(共3092部电影,包括所有候选影片)和`core`(共2015部电影,仅限经编码确认存在AI且其角色为“中心”或“辅助”的影片)。每部电影提供以下字段:身份信息(TMDB ID、IMDb ID、标题、发行日期、年份、原始语言、国家、类型、片长、列表来源)、接收情况(TMDB评分、IMDb评分、预算、收入、回报率)、人员信息(导演、编剧、制片人、主要演员)、AI编码(是否出现AI、AI角色类型、框架(受益/威胁/混合/中立)、框架评分、具身形式、是否背叛创造者、AI是否具有感知能力、编码置信度及理由)、AI角色汇总(角色数量、主要角色性别、女性比例、反派比例、纯语音角色比例)以及文本信息(TMDB剧情概要及字幕/剧本状态)。该数据集可用于研究科幻电影中人工智能形象的演变,支持文本分类、电影分析、媒体研究等任务。数据来源包括TMDB API和IMDb非商业数据集,AI编码由GPT-5.4-mini模型根据固定规则生成,未经人工验证。数据集采用CC BY-NC 4.0许可协议。
The dataset, named "allaimovies", includes all movies labeled as science fiction and containing AI characters on TMDB from 1911 to 2026. It has two configurations: `master` (3092 movies, including all candidates) and `core` (2015 movies, only those with confirmed AI presence where the AI role is "central" or "supporting"). Each movie provides the following fields: identity information (TMDB ID, IMDb ID, title, release date, year, original language, country, genre, runtime, list source), reception (TMDB rating, IMDb rating, budget, revenue, return on investment), personnel (director, writer, producer, main cast), AI coding (whether AI appears, AI role type, framework (beneficial/threatening/mixed/neutral), framework score, embodiment form, whether it betrays the creator, whether AI has sentience, coding confidence and rationale), AI role summary (number of roles, main role gender, female proportion, villain proportion, pure voice role proportion), and textual information (TMDB plot summary and subtitle/script status). This dataset can be used to study the evolution of AI portrayals in sci-fi films, supporting tasks such as text classification, film analysis, and media studies. Data sources include the TMDB API and IMDb non-commercial datasets. AI coding was generated by the GPT-5.4-mini model according to fixed rules and has not been manually verified. The dataset is licensed under CC BY-NC 4.0.
allaimovies 数据集概述
数据集简介
本数据集收录了1911年至2026年间TMDB(The Movie Database)上所有出现人工智能元素的科幻电影,每部电影一条记录,包含对AI角色的编码(如AI是带来益处还是威胁、是否具象化、是否背叛创造者、是否具有感知能力等),以及电影的票房、口碑、演职员等信息。该数据集旨在检验一篇关于电影中AI形象演变的论文中的观点。
数据集配置
| 配置名 | 行数 | 说明 |
|---|---|---|
master |
3,092 | 所有候选电影(通过AI关键词、剧情简介扫描或手动添加进入列表),无论是否确认存在AI |
core |
2,015 | 分析总体:经编码确认存在AI,且AI角色为“核心”或“配角”的电影 |
不在core中的1,077部电影包括纪录片、AI制作的电影、将“机器人”作为隐喻使用的电影,以及部分因剧情简介未提及AI而漏判的电影,它们被保留以便复核。
数据字段
| 分组 | 字段 |
|---|---|
| 身份信息 | tmdb_id、imdb_id、title、original_title、release_date、year、original_language、countries、genres、runtime_min、list_source(keyword/overview/manual) |
| 口碑与票房 | tmdb_vote_average、tmdb_vote_count、tmdb_popularity、imdb_rating、imdb_votes、budget_usd、revenue_usd、return_ratio |
| 人员 | directors、writers、producers、top_cast |
| AI编码 | ai_present、ai_role(central/supporting/incidental/none)、frame(benefit/threat/mixed/neutral)、frame_score(-2至+2)、embodiment、creator_betrayal、ai_sentient、coding_confidence、coding_rationale |
| AI角色 | ai_characters、n_ai_characters、ai_lead_gender、ai_female_share、ai_antagonist_share、ai_voice_only_share |
| 文本资料 | subtitle_status、subtitle_source、script_source、script_confidence |
| 剧情简介 | overview(TMDB剧情摘要,也是编码的输入文本) |
核心数据集概览
AI框架(frame)分布
| 框架 | 数量 | 占比 |
|---|---|---|
| 益处(benefit) | 516 | 26% |
| 威胁(threat) | 598 | 30% |
| 混合(mixed) | 664 | 33% |
| 中性(neutral) | 237 | 12% |
AI具象形态(embodiment)分布
| 形态 | 数量 | 占比 |
|---|---|---|
| 人形机器人 | 712 | 35% |
| 无形(无实体) | 448 | 22% |
| 非人形机器人 | 306 | 15% |
| 多种形态 | 196 | 10% |
| 生化人 | 146 | 7% |
| 未知 | 145 | 7% |
| 虚拟人类 | 62 | 3% |
是否背叛创造者(creator_betrayal)分布
| 选项 | 数量 | 占比 |
|---|---|---|
| 是 | 444 | 22% |
| 否 | 794 | 39% |
| 不明确 | 777 | 39% |
数据构建方法
- 解析约130个与AI相关的TMDB关键词(如人工智能、机器人、人形机器人、生化人、有感知的机器、超级计算机等),逐年调用discover接口查找科幻电影,再扩展到其他类型中含AI关键词的电影,以及标题或简介中提及AI术语的科幻电影。
- 从TMDB和IMDb评分表中补充IMDb ID、评分、预算、票房、时长、国家、类型、演职人员等信息。2,343部电影有IMDb ID,268部同时有预算和票房数据,1,986部有IMDb评分。
- 每部电影的剧情简介由GPT模型依据固定评估标准进行编码,2,015部核心电影中有496部(25%)为高置信度编码。
- 从演员表中标注AI角色(汇总信息在本数据集中)。
- 为924部电影找到字幕、45部找到剧本,但仅公开状态列。
注意事项(局限)
- 编码基于剧情简介,若某电影简介未提及AI则会被编码为
none。 - 语料来自TMDB,近年来的低成本电影和AI生成电影占比偏高,进行时间趋势分析时应限定最低投票数。
ai_lead_gender为“未知”主要集中在不知名的近期电影,性别分析时应排除。- 模型编码尚未与人类编码者进行一致性验证。
数据来源与许可
- 电影身份信息、简介、类型、国家、时长、预算、票房、人气、投票数及演职员信息来自TMDB API,TMDB数据仅限非商业用途。
- IMDb评分和投票数来自IMDb非商业数据集,仅限个人和非商业用途。
- AI编码由GPT模型根据固定评估标准生成,属于模型标注而非人工标注,未经人工验证,置信度字段为模型自身判断。
- 研究中使用的字幕和剧本受版权保护,未包含在本数据集中。
本数据集(编译表格和标注)以CC BY-NC 4.0许可发布,原始数据仍受TMDB和IMDb条款约束。