
遇见数据集

QuyDD/Tre_em_dan_toc

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

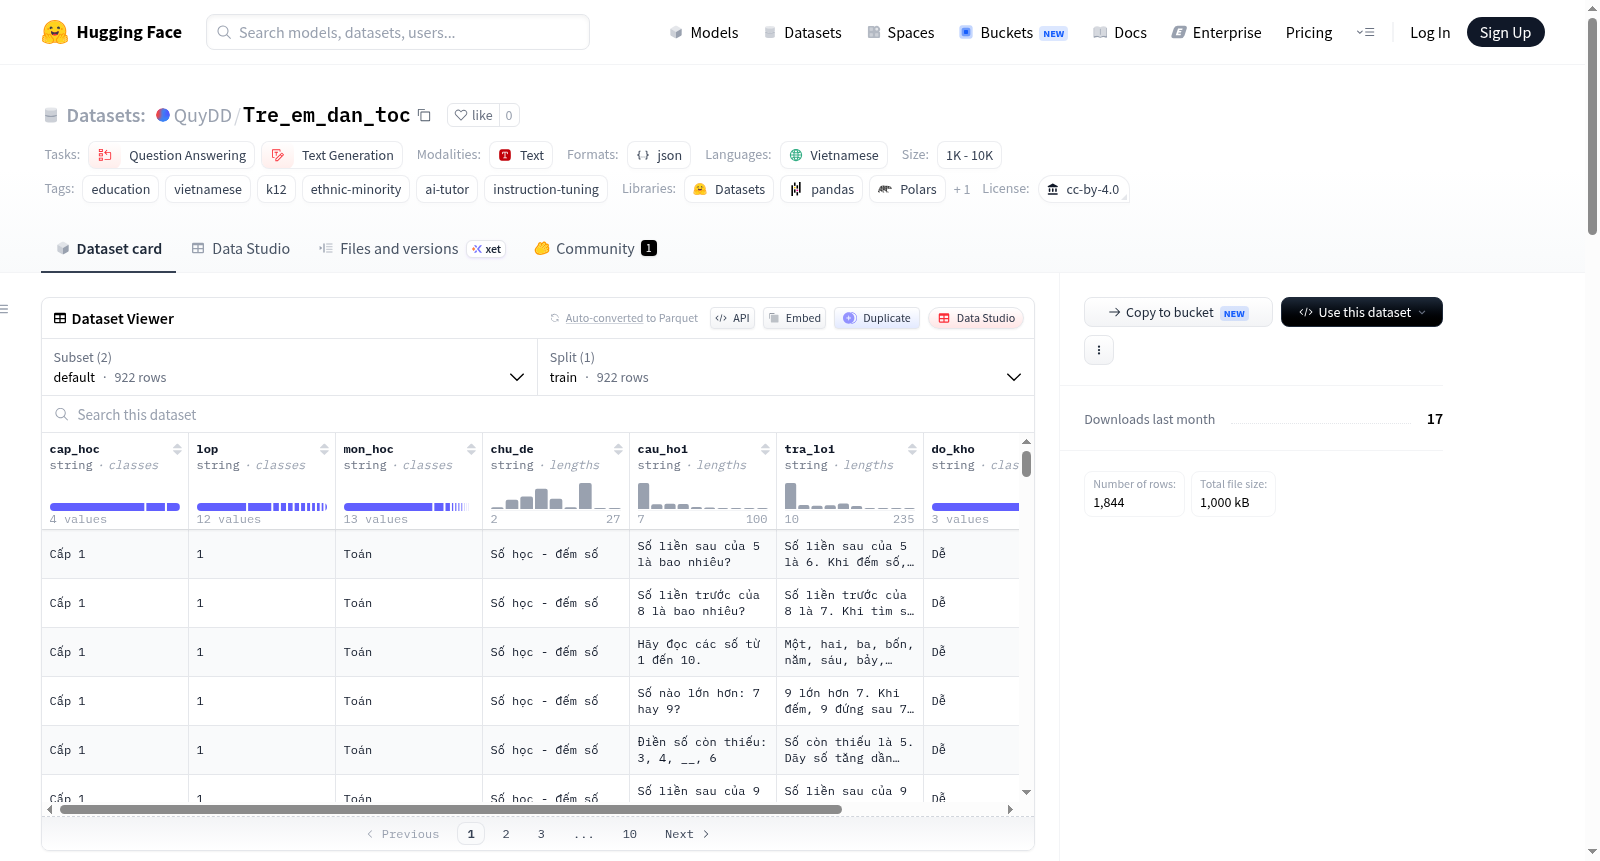
该数据集是一个越南语问答数据集,专门用于训练AI导师,以支持越南1至12年级的学生,特别关注少数民族儿童。数据集包含922条记录,涵盖从小学到高中的多个学科,如数学、语文、科学、历史等。数据提供两种配置:default配置包含原始字段,如年级、学科、主题、问题、答案、难度和问题类型;instruction配置则采用指令调优格式,包括系统提示、指令、输入、输出和元数据,适用于大型语言模型的微调。数据集旨在通过教育问答帮助提升AI在教育辅助领域的应用,尤其针对资源有限的少数民族学生。

This dataset is a Vietnamese question-answering dataset designed for training AI tutors to support students from grades 1 to 12 in Vietnam, with a special focus on ethnic minority children. It contains 922 records covering various subjects from elementary to high school, such as Mathematics, Vietnamese, Science, History, etc. The dataset offers two configurations: the default configuration includes raw fields like education level, grade, subject, topic, question, answer, difficulty, and question type; the instruction configuration uses an instruction-tuning format with system prompts, instructions, inputs, outputs, and metadata, suitable for fine-tuning large language models. The dataset aims to enhance AI applications in educational assistance through educational Q&A, particularly for ethnic minority students with limited resources.
提供机构:
QuyDD
搜集汇总
数据集介绍
QuyDD/Tre_em_dan_toc 数据集图片
构建方式
该数据集专为越南少数民族K1-12年级学生设计,旨在构建智能化的AI家教问答系统。数据集共包含922条记录,采用双配置结构:default配置以JSONL格式存储原始数据,涵盖学段、年级、科目、主题、问题、答案、难度和问题类型等字段;instruction配置则将数据转化为指令微调格式,包含系统提示、指令、输入、输出及元数据字段,便于大型语言模型的微调训练。数据覆盖三个学段,涉及数学、语文、科学、历史等多门学科,问题类型涵盖知识型、计算型和应用型。
使用方法
使用者可通过HuggingFace的datasets库便捷加载数据集,支持两种配置模式的灵活调用。加载default配置可获得原始问答数据,适用于数据分析或传统模型训练;加载instruction配置则直接获得指令微调格式的数据,可直接用于大语言模型的监督微调。每一条instruction数据都包含了完整的对话上下文:系统角色设定、用户问题、补充上下文信息以及标准答案示例,元数据字段还提供了问题的难度、类型等额外信息,便于进行针对性的筛选和评估。
背景与挑战
背景概述
在人工智能教育领域,面向特定语言与文化的智能辅导系统开发日益受到关注。越南少数民族儿童K1-12 AI辅导问答数据集(Tre_em_dan_toc)由研究人员QuyDD于近年创建,核心研究问题是如何构建一个涵盖1至12年级、专为越南少数民族学生设计的AI导师问答资源。该数据集包含922条记录,覆盖数学、语文等九门学科,并以低资源语言越南语呈现,旨在弥合教育技术中的语言与地域鸿沟。其影响力体现在为低资源语言场景下的指令微调与教育问答系统提供了基础数据支撑,推动了多语种AI教育公平化进程。
当前挑战
该数据集面临的核心挑战包括两方面。在领域问题层面,越南少数民族学生常因语言与文化差异面临教育资源匮乏,如何让AI导师准确理解山区儿童的非标准越南语表达并生成符合其认知水平的解答,是技术难点。在构建过程中,数据采集需从分散的K12教材中提炼标准化问答对,且仅922条的小规模样本限制了模型泛化能力;同时,需人为设计涵盖低年级至高年级的多学科内容,平衡难度标签(易/中/难)与问题类型(知识/计算/应用)的分布,确保教育场景的覆盖度与实用性。
常用场景
经典使用场景
该数据集专为越南少数民族K1-12年级学生设计,用于构建AI辅导系统的问答对。其经典使用场景在于通过两种配置——原始数据格式(default)和指令微调格式(instruction)——来训练大语言模型。研究者可利用包含年级、学科、主题、问题、答案、难度及问题类型等字段的原始数据,或直接使用已封装好系统指令、用户输入和期望输出的指令格式,进行模型微调,从而生成能够针对越南基础教育各学科(如数学、语文、科学等)提供个性化辅导的智能助教。
解决学术问题
该数据集针对越南少数民族学生在K1-12教育阶段缺乏个性化辅导资源的现实挑战,为学术研究提供了标准化的问答训练语料。它解决了低资源语言(越南语)在教育领域的大模型微调数据匮乏问题,推动了多语言、多文化背景下的教育技术研究。该数据集的发布促进了面向特定学生群体(如少数民族儿童)的适应性教育系统的开发,对于探索如何利用AI缩小教育差距、提升教育公平性具有重要的学术意义和深远影响。
实际应用
在实际应用中,该数据集可用于训练部署在移动应用或网页端的越南语AI家教助手。例如,学生提出数学计算题或语文理解题,模型能根据年级和难度生成分步讲解的答复。它还能集成到学校的学习管理系统中,辅助教师回答常见问题,或为课后作业提供智能反馈。针对偏远地区师资不足的情况,该数据集训练的模型可作为低成本的教育补充工具,为少数民族学生提供随时可用的学习支持,有效缓解教育资源不均的问题。
数据集最近研究
最新研究方向
在人工智能教育领域,Tre_em_dan_toc数据集专注于构建面向越南少数民族K1-12学生的AI家教系统,通过提供922条高质量问答对,涵盖从小学到高中的多学科内容,并采用指令微调格式以适配大语言模型的训练。该数据集紧密结合边缘化群体教育公平的前沿议题,支持多难度等级与多样化题型(如知识理解、计算与应用),为开发个性化、低资源环境下的智能辅导工具奠定基础。其独特之处在于强调少数民族儿童的语言与文化包容性,推动了AI技术在教育普惠化中的实际落地,对东南亚地区乃至全球教育科技的热点研究方向——即通过小样本数据与指令微调实现低成本高效能的虚拟家教——具有重要示范意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

