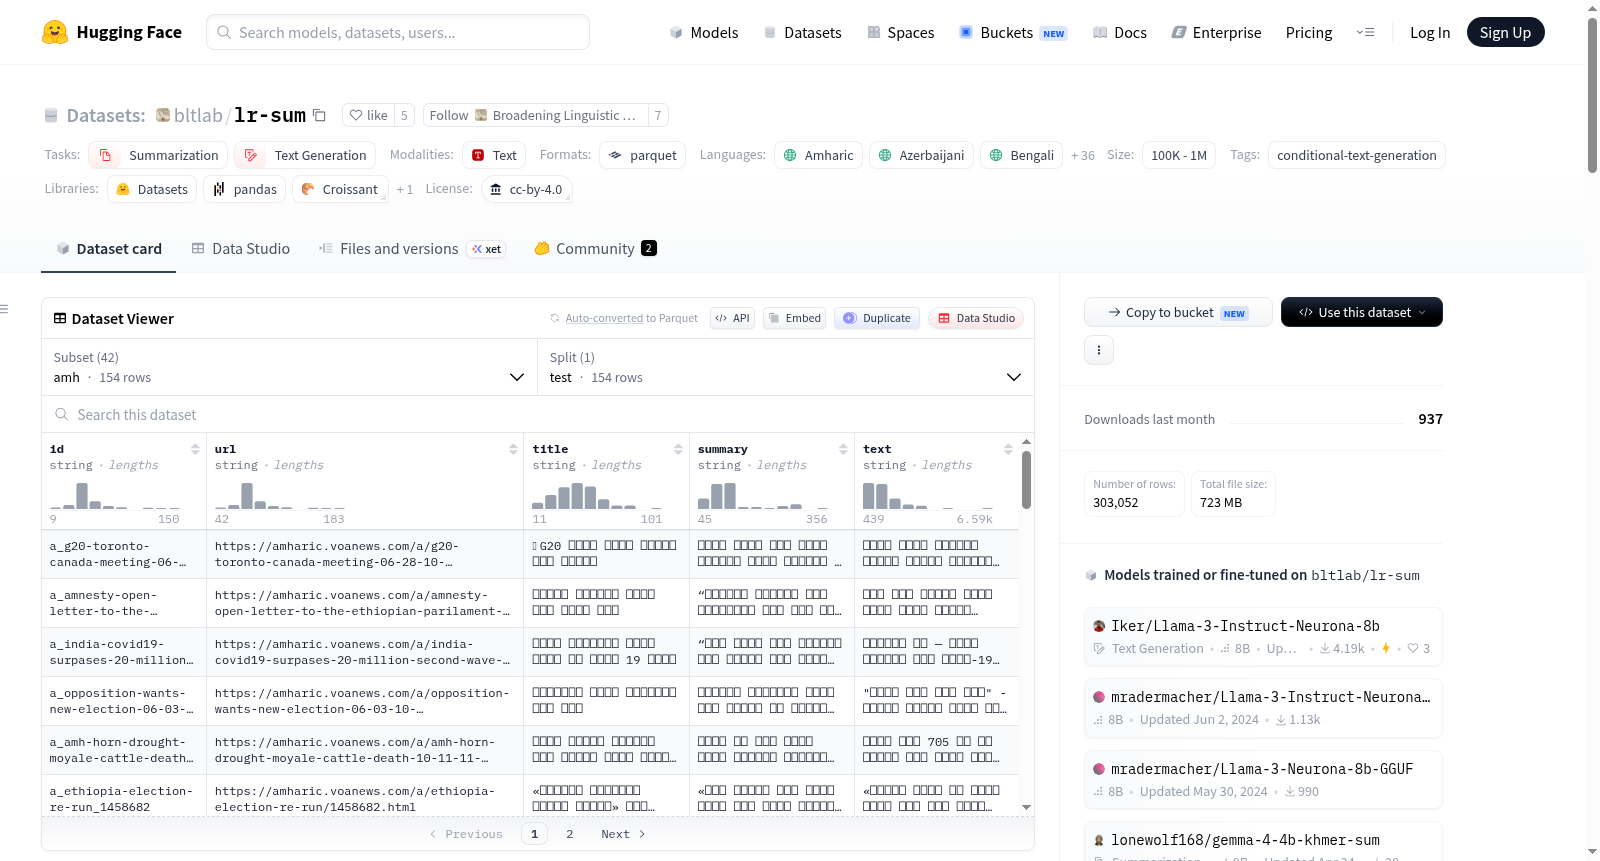
bltlab/lr-sum
收藏资源简介:
LR-Sum是一个专注于较少资源语言的自动摘要数据集,包含39种语言的人类撰写的摘要。数据集基于Multilingual Open Text语料库,源数据来自Voice of America网站的公共领域新闻稿。数据集采用CC BY 4.0许可,旨在促进较少资源语言的自动摘要研究。数据集结构包括文章的唯一ID、URL、标题、摘要和全文。数据集的创建目的是为了支持较少资源语言的自动摘要研究,源数据由Voice of America提供,摘要是从新闻文章的元数据中提取的。数据集的使用建议包括用于训练文本生成模型和自动摘要的自动评估,但也指出了数据集仅限于新闻稿文本,可能不适用于领域外的摘要任务。
LR-Sum is an automatic summarization dataset dedicated to low-resource languages, containing human-written summaries across 39 distinct languages. It is built upon the Multilingual Open Text corpus, with its source data derived from public-domain press releases hosted on the Voice of America website. The dataset is released under the CC BY 4.0 license, with the core objective of advancing automatic summarization research for low-resource languages. Structurally, the dataset includes fields such as unique article IDs, URLs, titles, summaries, and full article texts. The dataset was developed to support research on automatic summarization for low-resource languages: its source materials are provided by Voice of America, and its summaries are extracted from the metadata of the corresponding news articles. Recommended use cases include training text generation models and conducting automatic evaluation for automatic summarization tasks. It is also emphasized that the dataset is limited to press release texts and may not be suitable for out-of-domain summarization tasks.
数据集卡片 for LR-Sum
数据集详情
数据集描述
LR-Sum 是一个自动摘要数据集,专注于较少资源语言,采用 CC-BY 4.0 许可证。该数据集旨在促进较少资源语言的自动摘要研究。LR-Sum 包含 39 种语言的人工编写摘要,其中许多是较少资源语言。数据来源于 Multilingual Open Text 语料库,源数据是 Voice of America (VOA) 网站收集的公共领域新闻稿。
- 语言(NLP): 阿尔巴尼亚语, 阿姆哈拉语, 亚美尼亚语, 阿塞拜疆语, 孟加拉语, 波斯尼亚语, 缅甸语, 中文, 英语, 法语, 格鲁吉亚语, 希腊语, 海地克里奥尔语, 豪萨语, 印度尼西亚语, 高棉语, 基尼亚卢旺达语, 韩语, 库尔德语, 老挝语, 马其顿语, 北恩德贝勒语, 普什图语, 波斯语, 葡萄牙语, 俄语, 塞尔维亚语, 绍纳语, 索马里语, 西班牙语, 斯瓦希里语, 泰语, 藏语, 提格里尼亚语, 土耳其语, 乌克兰语, 乌尔都语, 乌兹别克语, 越南语
- 许可证: CC-BY 4.0
数据集结构
每个字段是一个字符串: json { "id": "文章唯一ID", "url": "新闻文章的URL", "title": "新闻文章的标题", "summary": "文章的摘要", "text": "新闻文章的全文(不包括标题)" }
数据集创建
数据收集和处理
数据来源于 Voice of America (VOA),详细的数据收集和处理过程参见相关论文。
注释过程
摘要来源于新闻文章的元数据,详细注释过程参见相关论文。
个人和敏感信息
敏感个人信息仅限于已在 VOA 新闻文章中发布的信息。
偏见、风险和限制
数据集内容为新闻稿,具体偏见、风险和限制参见 VOA 的使命和价值观。
推荐
尽管数据集采用宽松许可证,主要面向研究发布。建议用户在使用该数据集训练的模型投入生产环境前进行彻底测试和评估。
引用
如使用此数据集,请使用以下 BibTeX 引用:
bibtex @inproceedings{palen-michel-lignos-2023-lr, title = "{LR}-Sum: Summarization for Less-Resourced Languages", author = "Palen-Michel, Chester and Lignos, Constantine", editor = "Rogers, Anna and Boyd-Graber, Jordan and Okazaki, Naoaki", booktitle = "Findings of the Association for Computational Linguistics: ACL 2023", month = jul, year = "2023", address = "Toronto, Canada", publisher = "Association for Computational Linguistics", url = "https://aclanthology.org/2023.findings-acl.427", doi = "10.18653/v1/2023.findings-acl.427", pages = "6829--6844", abstract = "We introduce LR-Sum, a new permissively-licensed dataset created with the goal of enabling further research in automatic summarization for less-resourced languages.LR-Sum contains human-written summaries for 40 languages, many of which are less-resourced. We describe our process for extracting and filtering the dataset from the Multilingual Open Text corpus (Palen-Michel et al., 2022).The source data is public domain newswire collected from from Voice of America websites, and LR-Sum is released under a Creative Commons license (CC BY 4.0), making it one of the most openly-licensed multilingual summarization datasets. We describe abstractive and extractive summarization experiments to establish baselines and discuss the limitations of this dataset.", }