
cemig-ceia/normas_tecnicas_distribuicao_markdown
收藏官方服务:
资源简介:
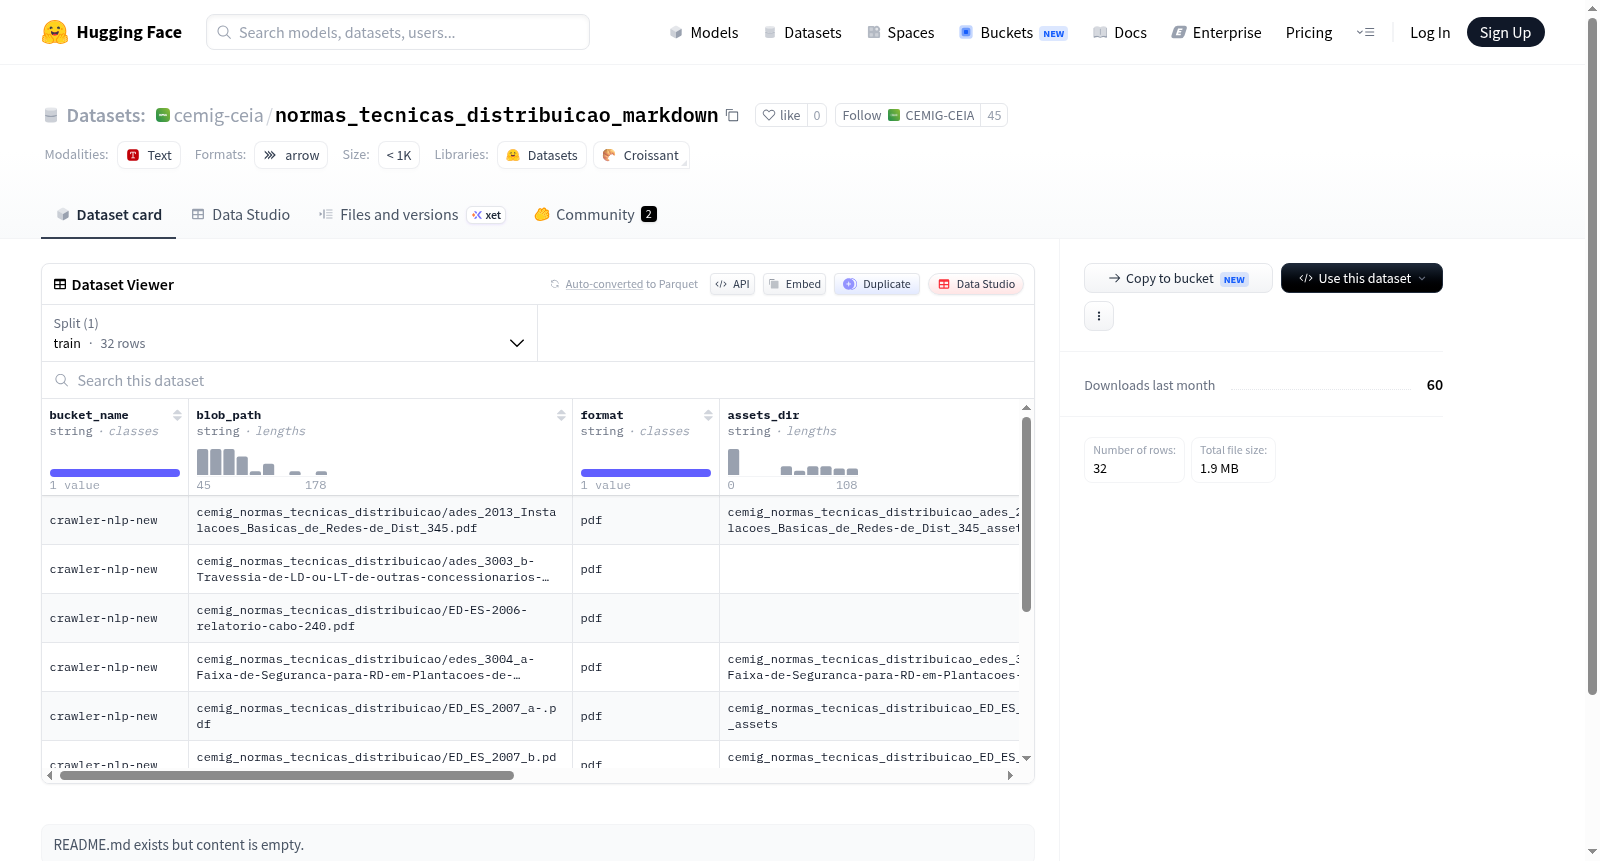
该数据集是一个小型多模态数据集,包含32个训练示例,总大小约为5.2MB。数据特征包括bucket_name、blob_path、format、assets_dir、source_file、image_paths(图像路径序列)和text(文本内容),适用于图像与文本关联的任务,如图像标注或视觉语言模型训练。数据以训练集形式提供,下载大小约为1.9MB。
This dataset is a small multimodal dataset containing 32 training examples with a total size of approximately 5.2MB. The features include bucket_name, blob_path, format, assets_dir, source_file, image_paths (a sequence of image paths), and text (text content), suitable for tasks involving image-text associations, such as image captioning or visual language model training. The data is provided in a training split, with a download size of about 1.9MB.
提供机构:
cemig-ceia搜集汇总
数据集介绍
构建方式
在电力能源与基础设施管理领域,技术标准的精准解析与数字化存储至关重要。该数据集以巴西配电技术标准为原始素材,通过系统化的数据采集与处理流程构建而成。原始文件经过格式转换与内容提取,最终以Markdown格式呈现,确保文本结构的可读性与可维护性。每条记录包含桶名称、存储路径、文件格式、资源目录、源文件路径、关联图像路径列表以及纯文本内容等字段,形成了多模态的结构化数据集合。训练集共包含32条样本,数据量约5.2 MB,涵盖从原始文档到标准化文本的全链路转换结果。
特点
此数据集具备显著的领域专精性与多模态整合特征。其内容聚焦于特定国家的配电技术规范,面向专业应用场景设计,具有明确的行业边界。数据集中同时存储了文本与图像路径,支持图文联合分析与文档还原任务,呈现出模态融合的特性。此外,每条数据记录了完整的文件溯源信息,包括源文件与资产目录,极大提升了数据的可追溯性与可复现性。所有样本已被统一转换为Markdown格式,使得文档结构更加规范,便于后续的自然语言处理或检索增强生成任务使用。
使用方法
该数据集适用于配电技术标准的知识提取、文档匹配及多模态检索等下游任务。用户可依据bucket_name与blob_path字段定位具体文件,利用source_file信息回溯原始文档,实现数据溯源。image_paths字段提供了关联图像的存储路径,适合进行图文联合建模。纯文本字段text中包含了已清洗的结构化内容,可直接用于训练语言模型或构建检索系统。推荐使用HuggingFace的datasets库加载数据,采用train-*格式的文件路径即可完成数据读取,支持批量处理与管道集成,降低工程部署门槛。
背景与挑战
背景概述
该数据集名为“normas_tecnicas_distribuicao_markdown”,于近期构建,旨在为巴西电力配电技术标准文档提供结构化的数据资源。数据集由相关研究机构或团队创建,聚焦于将分散的配电领域规范性文件转化为机器可读的Markdown格式。其核心研究问题在于如何有效整合与标准化非结构化文本,以支持自动化信息检索与知识图谱构建。该数据集虽规模有限(仅32条训练样本),但为电力行业自然语言处理研究提供了专业领域基础资源,有望推动技术文档的智能化处理与合规性分析。
当前挑战
该数据集面临的主要挑战包括:首先,领域问题层面,配电技术标准文档存在术语复杂、格式多样且跨地区差异显著的特点,传统模型难以准确解析其中的条款关系与约束条件,导致自动化理解困难。其次,构建过程中,原始文档多为PDF或扫描件,需经光学字符识别与人工校对,数据集仅含少量样本,无法覆盖所有标准变体,且文本与图像路径(image_paths)并存,增加了多模态对齐与处理的复杂性。此外,数据分布不均衡,验证集缺失,限制了模型泛化能力的评估。
常用场景
经典使用场景
在电力能源领域,配电系统标准文档的数字化是提升运维效率与安全性的关键。该数据集汇聚了巴西配电技术规范(Normas Técnicas de Distribuição)的Markdown格式文本及其关联图像,为自然语言处理与多模态信息检索提供了珍稀语料。研究者可借助此集,训练模型以精准解析配电系统中的设备安装、线路布局与安全准则,支持从非结构化文档中抽取结构化知识,进而赋能智能问答与自动化合规审查系统,推动配电领域知识的标准化与可计算化。
实际应用
在实际工程中,该数据集是构建配电领域智能助手的关键基石。电力公司可基于此训练生成式语言模型,自动应答一线技术人员关于安装规范、故障处理流程的查询,显著缩短决策时间。同时,该数据集支持开发自动化文档审核工具,对照最新标准实时校验施工方案合规性,降低人为疏漏风险。此外,结合图像信息,可训练模型实现图纸与文本的协同检索,提升配电系统全生命周期管理中的信息获取效率。
衍生相关工作
基于该数据集,研究者已孵化出多项创新工作。例如,有工作利用其多模态特性,提出了面向配电规范的图像-文本对比学习框架,实现了跨模态检索的精度突破。另一些研究则聚焦于文档结构解析,通过层次化注意力网络将规范条款转化为可执行规则图。此外,该数据集还催生了面向低资源场景的小样本学习方案,仅以32条训练样例即验证了配电领域术语迁移的有效性,为小规模专业语料库的应用探索了新路径。
以上内容由遇见数据集搜集并总结生成


