vla0-real-world-dataset-v3
收藏资源简介:
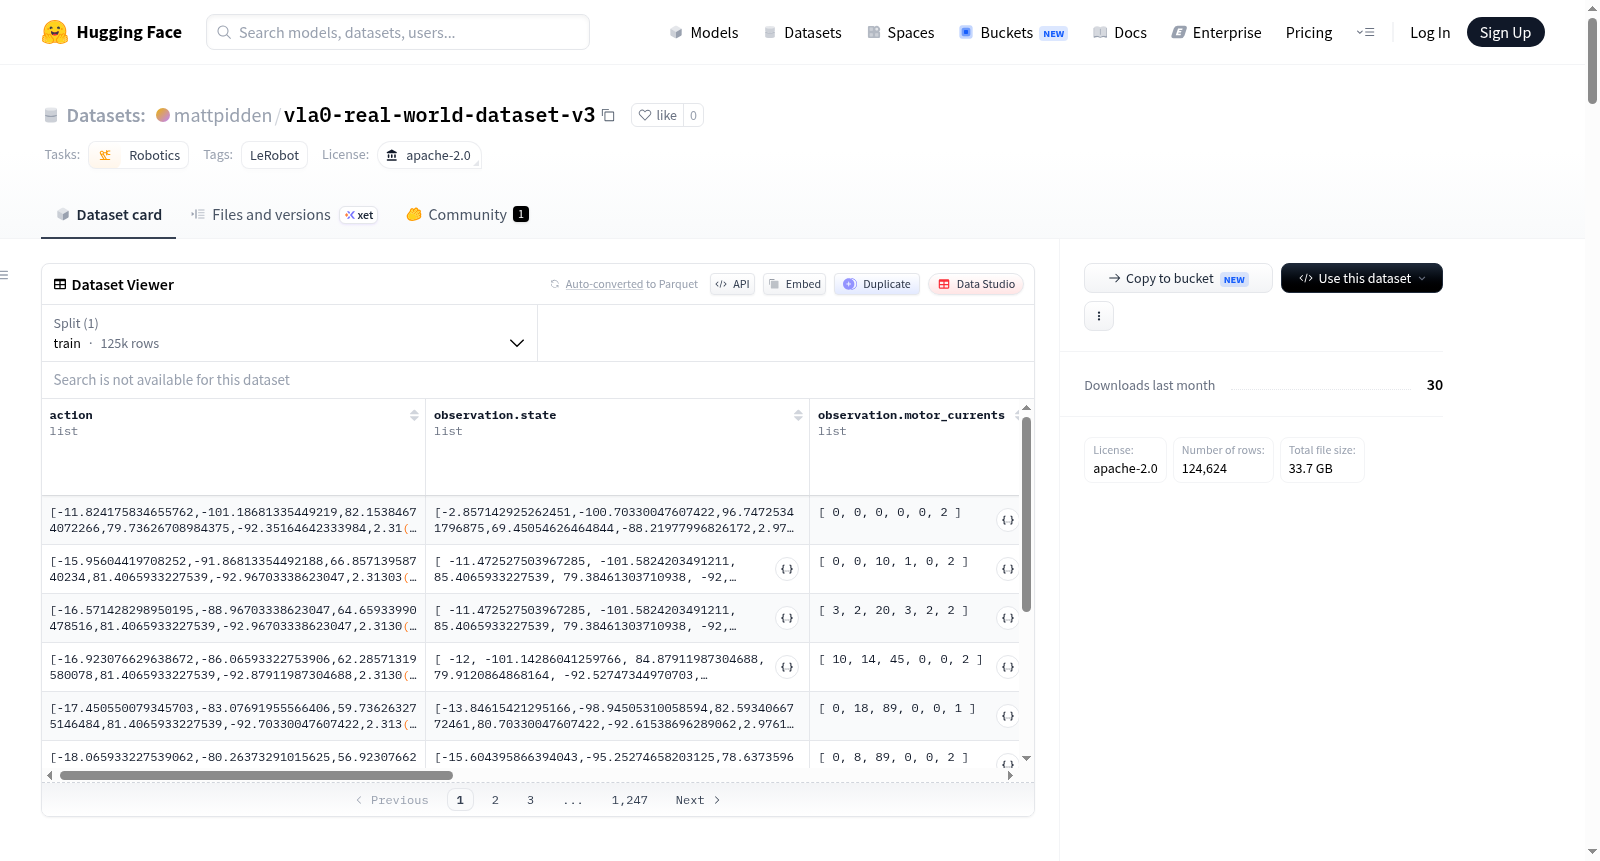
该数据集是使用LeRobot框架创建的真实世界机器人数据集,旨在支持机器人学习和视觉语言动作(VLA)任务。数据采集自so_follower机器人平台,以30 FPS帧率记录,包含400个episode,总计124,624帧,覆盖4个不同任务。数据集结构丰富,主要特征包括:动作指令(6维浮点数组,表示肩部平移、肩部抬升、肘部弯曲、腕部弯曲、腕部旋转和夹爪位置);观测状态(6维关节位置);来自五个摄像头视角(腕部、上方、右侧、左侧、中间)的彩色图像观测,每帧图像分辨率为480x640,3通道,以AV1编码视频格式存储;电机电流和速度(各6维整数数组);以及来自中间摄像头的深度图(480x640,uint16类型)。此外,还包含时间戳、帧索引、episode索引、全局索引和任务索引等元数据。数据以Parquet文件格式分块存储,总数据文件大小约100 MB,视频文件大小约200 MB。该数据集适用于机器人控制策略学习、模仿学习、强化学习以及多模态感知与动作生成等研究。
This dataset is a real-world robot dataset created using the LeRobot framework, designed to support robot learning and Vision-Language-Action (VLA) tasks. Data is collected from a robot platform named so_follower, recorded at 30 FPS, containing 400 episodes with a total of 124,624 frames, covering 4 different tasks. The dataset has a rich structure, with key features including: action commands (6-dimensional float arrays representing shoulder translation, shoulder lift, elbow bend, wrist bend, wrist rotation, and gripper position); observation states (6-dimensional joint positions); color image observations from five camera perspectives (wrist, overhead, right, left, center), each frame with a resolution of 480x640, 3 channels, stored in AV1-encoded video format; motor currents and speeds (each as 6-dimensional integer arrays); and depth maps from the center camera (480x640, uint16 type). Additionally, it includes metadata such as timestamps, frame indices, episode indices, global indices, and task indices. Data is stored in chunked Parquet file format, with a total data file size of approximately 100 MB and video file size of about 200 MB. This dataset is suitable for research in robot control policy learning, imitation learning, reinforcement learning, and multimodal perception and action generation.
- 数据集名称: vla0-real-world-dataset-v3
- 许可证: Apache-2.0
- 任务类别: 机器人学 (Robotics)
- 标签: LeRobot
- 创建工具: 使用 LeRobot 创建
- 数据文件: 位于
data/*/*.parquet,包含 400 个片段 (episodes),共 124,624 帧 (frames),数据文件大小约 100 MB,视频文件大小约 200 MB - 帧率 (FPS): 30
- 机器人类型: so_follower
- 任务总数: 4 个任务 (tasks)
- 数据集划分: 训练集 (train) 包含第 0 到第 399 个片段 (共 400 个)
特征 (Features)
该数据集包含以下特征,每个特征均以 30 FPS 记录:
动作 (Action) 与观测状态 (Observation.State)
- 维度: 6 维
- 数据类型: float32
- 名称: shoulder_pan.pos, shoulder_lift.pos, elbow_flex.pos, wrist_flex.pos, wrist_roll.pos, gripper.pos
观测图像 (Observation.Images)
共包含 5 个摄像头视角,均为视频格式,分辨率为 480x640,3 个通道 (RGB),使用 AV1 编码,yuv420p 像素格式,帧率 30 FPS:
- wrist (手腕)
- above (上方)
- right (右侧)
- left (左侧)
- middle (中间)
观测电机信号 (Observation.Motor)
- 电机电流 (motor_currents): int32,6 维,包含 shoulder_pan.current, shoulder_lift.current, elbow_flex.current, wrist_flex.current, wrist_roll.current, gripper.current
- 电机速度 (motor_velocities): int32,6 维,包含 shoulder_pan.velocity, shoulder_lift.velocity, elbow_flex.velocity, wrist_flex.velocity, wrist_roll.velocity, gripper.velocity
观测深度图 (Observation.Depths)
- middle: 深度图像,uint16 类型,分辨率为 480x640
元数据 (Metadata)
- timestamp: float32,形状 [1]
- frame_index: int64,形状 [1]
- episode_index: int64,形状 [1]
- index: int64,形状 [1]
- task_index: int64,形状 [1]
数据路径结构
- 数据路径:
data/chunk-{chunk_index:03d}/file-{file_index:03d}.parquet - 视频路径:
videos/{video_key}/chunk-{chunk_index:03d}/file-{file_index:03d}.mp4 - 分块大小 (chunks_size): 1000