JingweiNi/ocr2_hardest_questions_10k_k2_think_low_vllm_direct_seed20260527_qwen35_fp8_step10k_annotated
收藏资源简介:
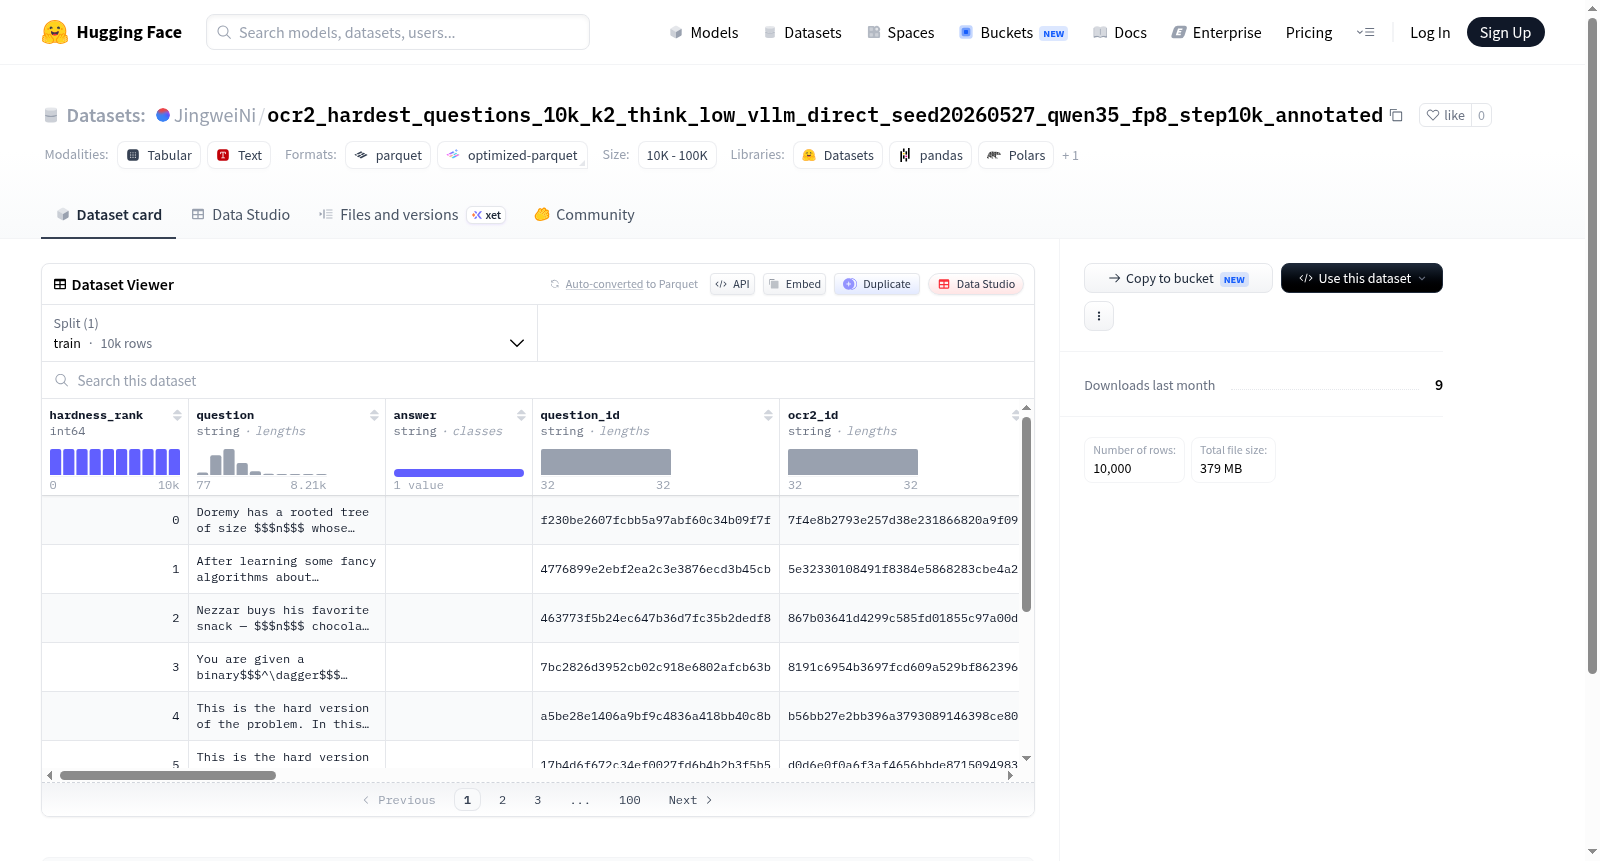
该数据集包含10,000个训练样本,主要用于问答或文本分析任务。特征包括:问题(question)、答案(answer)、问题ID(question_id)、语言分类(language_split)、来源数据集(source_dataset)、难度等级(difficulty)和难度分数(difficulty_score)、通过率(pass_rate)、输入ID序列(input_ids)、回复文本(reply)、样本索引(sample_idx)以及验证信息(verified)等。数据包含多语言划分和来源平台信息,适用于自然语言处理模型训练与评估。
This dataset contains 10,000 training samples, primarily designed for question-answering or text analysis tasks. Features include: question, answer, question_id, language classification (language_split), source dataset (source_dataset), difficulty level (difficulty) and difficulty score (difficulty_score), pass rate (pass_rate), input ID sequences (input_ids), reply text (reply), sample index (sample_idx), and verification information (verified). The data includes multilingual splits and source platform details, suitable for natural language processing model training and evaluation.