
遇见数据集

overthelex/ukrainian-court-decisions

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

这是一个乌克兰法院判决数据集,用于案件判决预测任务。数据来源于乌克兰国家法院判决注册表(ЄДРСР),包含乌克兰语的民事和商业法院判决,时间跨度为2003年至2025年。数据集共150,000个样本,平衡分为三个类别:approved(完全支持)、dismissed(驳回)和partial(部分支持)。输入为法院判决的事实部分(ВСТАНОВИВ),任务是根据事实预测判决结果。数据集经过预处理,确保事实部分长度在200到10,000字符之间,整体文本长度在500到200,000字符之间。数据分为训练集(120,000样本)、验证集(15,000样本)和测试集(15,000样本),支持多种配置(如default、full_scale、hybrid_war、pre_war等),适用于法律自然语言处理研究,特别是判决预测和时间概念漂移分析。

A dataset of Ukrainian court decisions for case outcome prediction, extracted from the State Court Decisions Registry (ЄДРСР). It contains Ukrainian-language civil and commercial court decisions from 2003 to 2025. The dataset includes 150,000 samples, balanced across three classes: approved (claim fully satisfied), dismissed (claim dismissed), and partial (claim partially satisfied). The input is the facts section (ВСТАНОВИВ) of court decisions, and the task is to predict the judgment outcome based on the facts. Data is preprocessed with a minimum of 200 characters and a maximum of 10,000 characters for the facts section, and full text length between 500 and 200,000 characters. It is split into train (120,000 samples), validation (15,000 samples), and test (15,000 samples) sets, with multiple configurations (e.g., default, full_scale, hybrid_war, pre_war) for legal NLP research, particularly judgment prediction and temporal concept drift analysis.
提供机构:
overthelex
搜集汇总
数据集介绍
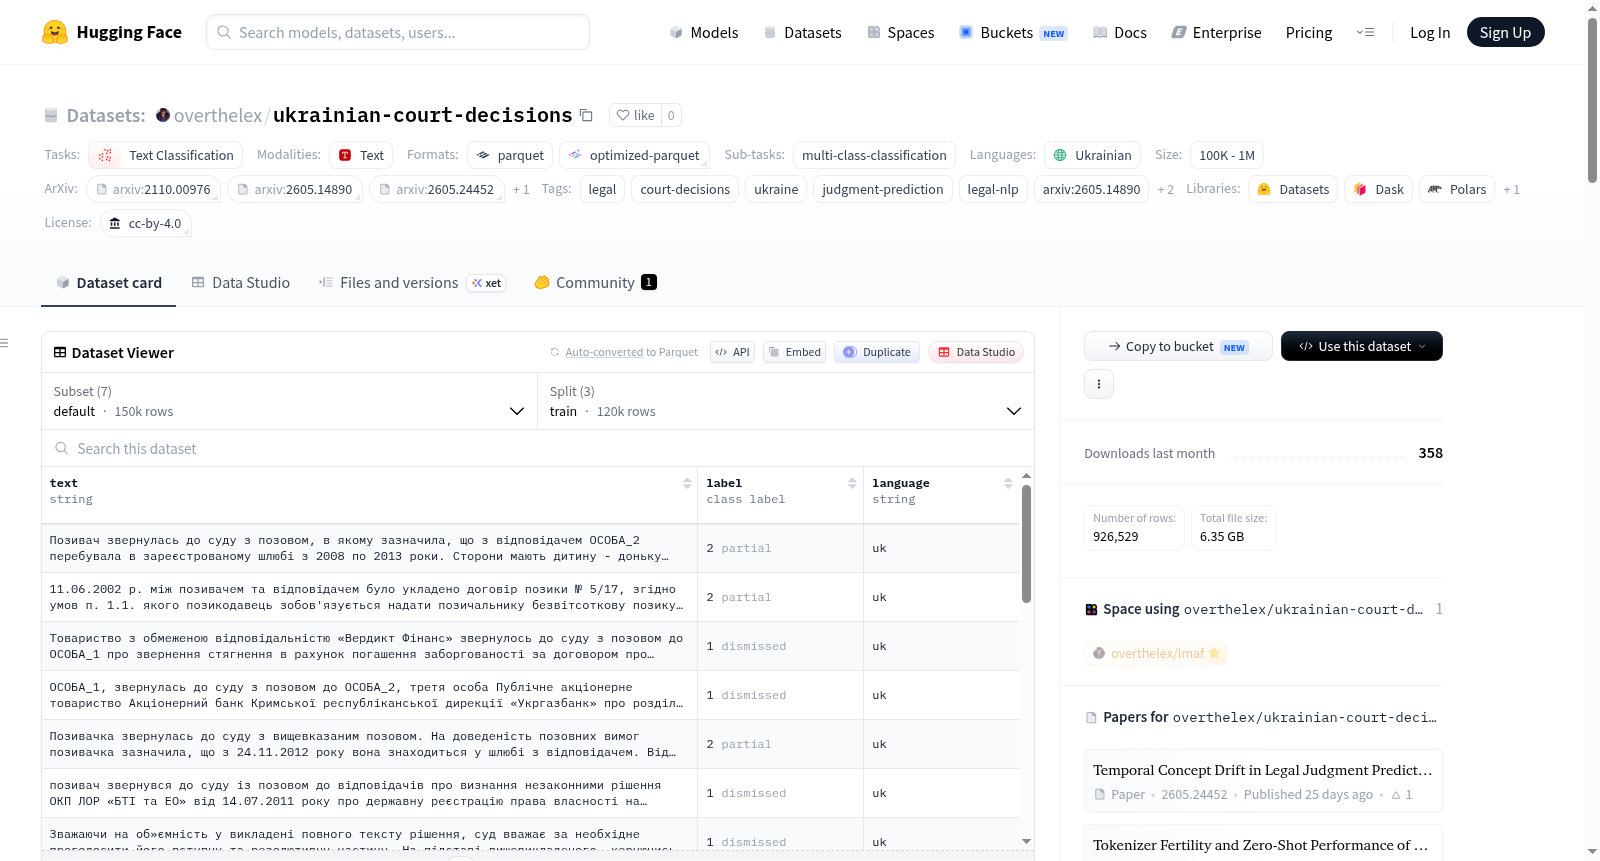
overthelex/ukrainian-court-decisions 数据集图片
构建方式
该数据集源自乌克兰国家法院判决登记处(ЄДРСР),聚焦于民事与商事法院自2003年至2025年间发布的实质判决文书。构建时严格遵循法律文书的结构规范,仅抽取“ВСТАНОВИВ”(事实查明)部分作为输入文本,而排除法院的推理与裁决段落,以避免任务因包含直接答案而失去挑战性。裁判结果标签则通过规则匹配从“ВИРІШИВ”(主文)部分自动提取,依据关键动词将案件归为完全支持、驳回或部分支持三类。在初步提取的802,189份判决中,经过字符长度筛选与质量校验,最终保留596,538份有效样本,并从中随机采样150,000条以80/10/10的比例划分为训练、验证与测试集,确保了类别间的完美平衡。
使用方法
使用方式极为便捷,兼容主流深度学习框架。用户可直接通过HuggingFace Datasets库以一行代码加载默认配置,例如`load_dataset('overthelex/ukrainian-court-decisions')`,即获得训练、验证与测试分割。若需研究时间效应或轻量级基准测试,可选用pre_war或lextreme系列配置,后者在保证分布代表性的前提下显著缩减验证与测试规模至999条。数据集提供的`text`字段为乌克兰语案件事实,`label`字段为预设的字符串型或数值型裁判结果,可直接输入给分类模型。同时,该数据集已集成至LexTreme基准,支持通过`load_dataset('joelniklaus/lextreme', 'ukrainian_court_decisions_judgment')`调用,便于在统一框架下对比不同法律NLP任务的表现。
背景与挑战
背景概述
乌克兰法院判决预测数据集(ukrainian-court-decisions)由研究人员Volodymyr Ovcharov于2026年前后创建,源自乌克兰国家法院判决登记处(ЄДРСР),涵盖了2003年至2025年间民事和商事法院的实质性判决。该数据集聚焦于法律自然语言处理中的判决结果预测任务,通过提取判决书中的事实部分(ВСТАНОВИВ)作为输入,将案件结果分类为完全支持、驳回或部分支持三类。其构建遵循了Niklaus等人(2021)的方法论,剔除了包含答案的裁决部分,以确保任务的非平凡性。数据集包含15万条均衡样本,在时间跨度、文本长度和类别平衡上具有显著优势,为乌克兰法律文本的机器理解提供了标准化基准,推动了法律人工智能在非英语司法体系中的发展。
当前挑战
该数据集面临多重挑战。在领域问题层面,法律判决预测需应对文本语义的复杂性和司法解释的模糊性,尤其是乌克兰法律体系在战争前后可能发生的时间概念漂移,使得基于历史数据的模型难以适应动态法律环境。在构建过程中,从80余万份原始判决中精确提取事实部分并排除推理和裁决内容,依赖基于关键词的规则匹配,可能引入噪声;同时,数据集仅覆盖民事和商事法院,缺乏刑事和行政案件的多样性,限制了模型的泛化能力。此外,乌克兰语作为低资源语言,其词法丰富性对预训练模型的标记器效力和零样本性能构成了严峻考验。
常用场景
经典使用场景
Ukrainian Court Decisions数据集的核心应用场景在于对乌克兰民商事法院裁决的事实部分进行多类别判决结果预测。该数据集严格依照Niklaus等人提出的方法论,仅提取裁决文书中“ВСТАНОВИВ”部分作为输入,而将法院的法律推理与主文排除在外,从而避免了任务因包含答案而失去挑战性。数据分为三类标签:完全支持诉讼请求、驳回诉讼请求与部分支持诉讼请求,为司法判决预测研究提供了结构清晰、规模达15万样本的基准资源。
解决学术问题
该数据集致力于解决法律自然语言处理领域中判决结果预测的多个核心学术难题。它通过提供经严格标注的乌克兰语法律文本,为多类别判决分类任务建立了量化评估基准,使得研究者能够客观衡量不同模型在法律文本上的预测能力。更重要的是,数据集通过划分出战前、混合战争等时期版本,首次揭示了时间概念漂移对判决预测模型性能的深远影响,推动了司法人工智能对动态法律环境适配性研究的深入。
实际应用
在实际应用中,该数据集赋能法律科技领域多项落地场景。基于其构建的判决预测模型可辅助律师与当事人评估案件走向,优化诉讼策略与风险预判。司法机关能借助这些模型实现案件分流管理,提升司法资源配置效率。此外,通过分析判决与案件事实之间的隐含关联,该数据集支持开发法律文书辅助生成系统,帮助法院自动草拟裁判说理部分,从而减轻法官工作负荷,提升司法系统整体运转效能。
数据集最近研究
最新研究方向
在乌克兰法律文本的自然语言处理前沿,ukrainian-court-decisions数据集正驱动着三大核心探索。其一聚焦于基础模型在乌克兰法律文本上的分词效能与零样本迁移能力,通过比较不同tokenizer的文本表示效率,揭示了跨语言法律AI的深层适应性挑战。其二深入法律裁判预测中的时间概念漂移现象,利用跨越二十年(2003-2025)的判决数据,分析神经网络基线在不同历史时期(战前、混合战争时期)的预测稳定性与范式迁移,这一研究为动荡环境下司法AI的鲁棒性提供了关键实证。其三则迈向法律知识图谱的自动化构建,从超过1亿份乌克兰判决中提取百亿级法律引用网络,结合拓扑分析与本体驱动聚类,实现了大规模、细粒度的法律文献关联分析,为乌克兰乃至全球法律智能的跨案例推理与判例检索奠定了坚实基础。这些工作不仅拓展了多语言法律NLP的理论边界,更在战时司法连续性、智能司法辅助等现实场景中彰显出深远的社会价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

