
遇见数据集

eu-tax-edge-cases

收藏
Hugging Face2026-08-02 更新2026-08-03 收录
官方服务:

资源简介:

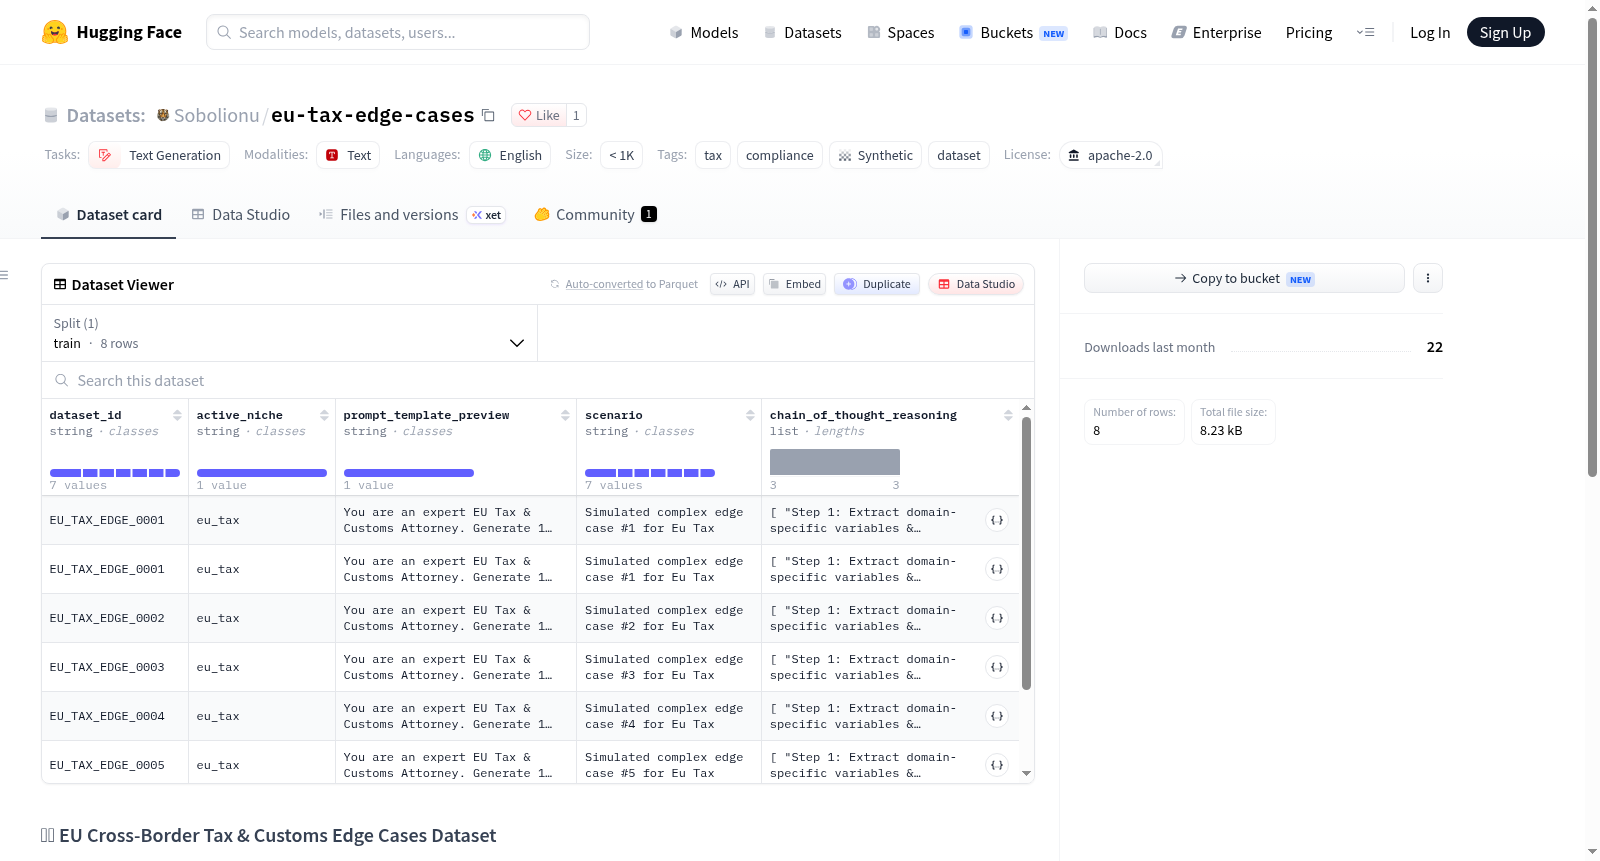
该数据集为欧盟跨境税务与海关边缘案例数据集,专注于欧盟增值税跨境规则、海关阈值、三角贸易边缘案例和数字服务税逻辑。数据集格式为清洁 JSON,包含经过验证的税务合规样本。完整数据集需付费购买(€499.00),本仓库仅提供 1 行预览样本用于评估。数据集适用于大语言模型微调、检索增强生成(RAG)系统基础构建以及合规代理训练等任务。

This dataset focuses on EU cross-border tax and customs edge cases, including EU VAT cross-border rules, customs thresholds, triangular trade edge cases, and digital services tax logic. The dataset is in clean JSON format and contains verified tax compliance samples. The full dataset requires purchase (€499.00); this repository provides only 1 preview row for evaluation. It is suitable for tasks such as fine-tuning large language models, building retrieval-augmented generation (RAG) systems, and training compliance agents.

创建时间:
2026-08-02
原始信息汇总

数据集概述

基本信息

  • 数据集名称:EU Cross-Border Tax & Customs Edge Cases(欧盟跨境税务与海关边缘案例)
  • 许可证:Apache 2.0
  • 任务类型:文本生成(text-generation)
  • 语言:英语
  • 标签:税务(tax)、合规(compliance)、合成数据(synthetic)、数据集(dataset)

内容范围

该数据集涵盖以下领域:

  • 欧盟增值税跨境规则(EU VAT cross-border rules)
  • 海关门槛(customs thresholds)
  • 三角贸易边缘案例(triangular trade edge cases)
  • 数字服务税逻辑(digital service tax logic)

文件格式与规模

  • 格式:干净的JSON格式(verified_tax_dataset_final.json
  • 预览样本:仓库中包含 1行预览样本dataset_teaser_sample.json),仅供评估用途

适用场景

该数据集可用于以下场景:

  • 大语言模型(LLM)微调
  • 检索增强生成(RAG)系统知识落地
  • 合规代理(compliance agent)训练

商业许可

完整版本的数据集需购买商业许可,售价 €499.00,可通过 Hydra Datasets 购买页面 获取。完整数据集面向AI模型微调、自动化合规引擎或法律审计等用途。
搜集汇总
数据集介绍
eu-tax-edge-cases 数据集图片
构建方式
鉴于欧盟跨境税务与海关规则体系高度复杂且场景多变,该数据集聚焦于增值税跨境机制、关税起征点、三角贸易特殊情形及数字服务税逻辑等关键领域,通过系统化采集与专家校验流程构建而成。具体而言,数据以干净JSON格式组织,核心文件为经过验证的税务数据集,覆盖多类边缘案例,并提供一个单行预览样本供评估使用。构建过程强调案例的准确性与代表性,确保每一条记录均反映真实合规场景中的典型挑战,从而为模型训练提供可靠基础。
特点
该数据集以欧盟跨境税务与海关边缘案例为核心特色,涵盖增值税规则、关税阈值、三角贸易及数字服务税等细分领域,具有高度的领域专业性与场景多样性。其数据格式为整洁的JSON结构,便于直接解析与集成,且经过验证流程,保证了内容的一致性与可靠性。数据集规模虽以预览样本形式展示,但完整版本面向商业授权,适用于需要深度税务逻辑的AI应用场景,体现了合成数据在合规领域的实用价值。
使用方法
使用者可将该数据集用于大语言模型的微调、检索增强生成系统的知识 grounding 以及合规代理的训练任务。具体操作时,首先获取完整商业授权版本,随后加载JSON格式的税务数据集,将其作为训练语料或外部知识库接入模型流程。对于初步评估,可利用仓库中提供的单行预览样本进行格式与内容检查。注意,完整数据集需通过指定商业许可渠道购买,预览样本仅用于评估目的,不可用于商业部署。
背景与挑战
背景概述
随着欧盟跨境贸易的日益频繁,增值税(VAT)与关税合规问题成为企业合规与法律审计的核心难题。eu-tax-edge-cases数据集应运而生,由HydraDatasets团队于近年构建,旨在为AI模型提供高质量的合成税务边缘案例。该数据集聚焦于欧盟跨境增值税规则、关税阈值、三角贸易及数字服务税等复杂场景,为LLM微调、RAG系统及合规代理训练提供结构化基础,推动了税务科技与法律人工智能的交叉研究。
当前挑战
该数据集所应对的领域问题在于欧盟跨境税务与海关合规的高度复杂性与动态性,传统规则引擎难以覆盖大量边缘案例。构建过程中的挑战包括:合成数据需精确反映欧盟各国税法差异与动态更新,确保逻辑一致性与法律准确性;边缘案例的生成需兼顾多样性与现实可行性;同时,数据稀缺与隐私限制使得真实交易数据难以获取,进一步加剧了数据集构建的难度。
常用场景
经典使用场景
在欧盟跨境增值税与关税合规领域,该数据集最经典的使用场景是作为检索增强生成系统的知识底座,为语言模型注入欧盟增值税跨境规则、关税起征点、三角贸易边界情形以及数字服务税逻辑等结构化专业知识。通过对该数据集的监督微调,模型能够在处理跨境交易描述时精准识别适用税率、判定纳税义务发生地,并依据欧盟增值税指令与海关法规输出合规结论,从而将通用语言模型转化为具备税务合规推理能力的专用模型。
解决学术问题
该数据集直面税务人工智能研究中长期存在的三重困境:跨境增值税规则的语义歧义消解、多法域监管框架下的合规推理链构建、以及高质量标注税务语料的严重匮乏。其通过提供经过验证的边界情形样本,为法律信息抽取、规则推理与合规判定等任务建立了可复现的基准,使研究者得以系统评估模型在真实税务场景中的鲁棒性与泛化能力,对计算法学与税务信息学的交叉研究具有奠基性意义。
衍生相关工作
围绕该数据集,后续研究衍生出若干经典工作:基于其结构构建的欧盟税务知识图谱实现了规则间的语义关联与推理路径可视化;以其为评估基准的合规智能体在多项税务问答任务中取得了超越通用模型的表现;结合检索增强生成框架的税务问答系统则展示了结构化税务数据与生成式模型融合的潜力。这些工作共同推动了税务人工智能从规则查询向推理决策的范式演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


