
chanind/pile-uncopyrighted-pythia-1024-abbrv-2B
收藏官方服务:
资源简介:
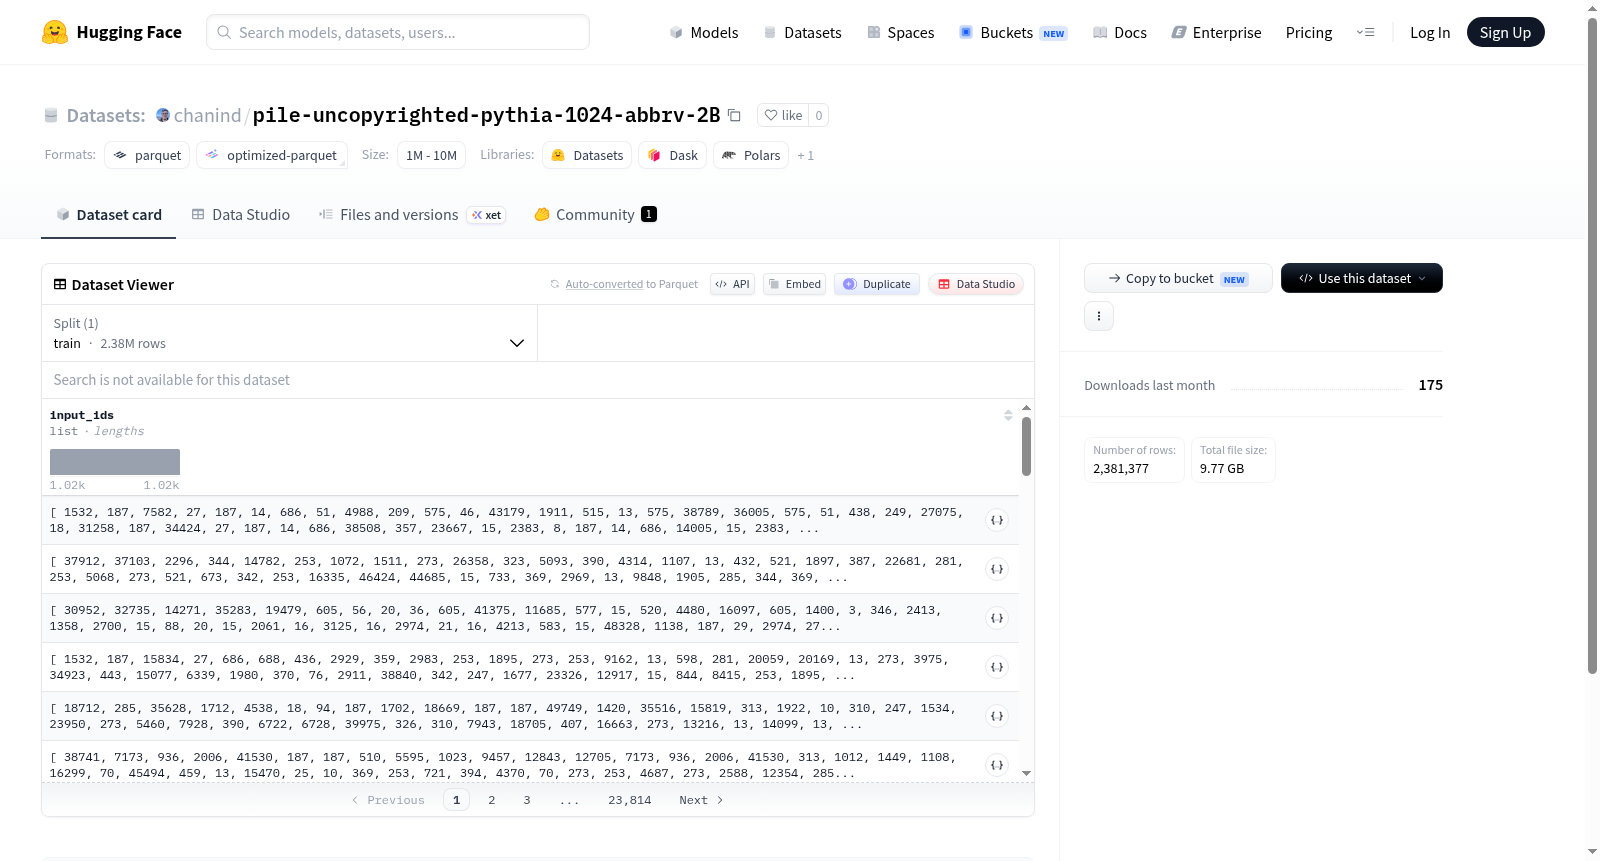
该数据集是一个包含2,381,377个训练示例的大规模文本预处理数据集,主要用于自然语言处理任务。数据集特征为int32类型的input_ids列表,表示经过分词和编码后的文本序列。数据仅包含训练分割,总大小约为9.76GB,下载大小约为9.77GB。数据集可能用于模型预训练或微调,但具体来源、领域或应用目标未在README中明确说明。
This dataset is a large-scale preprocessed text dataset containing 2,381,377 training examples, primarily designed for natural language processing tasks. The dataset feature is input_ids as a list of int32 type, representing tokenized and encoded text sequences. It includes only a train split, with a total size of approximately 9.76 GB and a download size of approximately 9.77 GB. The dataset may be used for model pre-training or fine-tuning, but specific sources, domains, or application objectives are not explicitly stated in the README.
提供机构:
chanind搜集汇总
数据集介绍
构建方式
该数据集构建自经过版权过滤后的The Pile语料库,通过采用Pythia模型的数据处理流程进一步精简,最终筛选出序列长度为1024 token的高质量文本片段,并经过缩写处理形成本版本。数据以分片形式存储于Parquet格式文件中,便于分布式加载与高效读取。
特点
数据集特点在于其规模适中且聚焦于无版权内容,共计238万余条样本,总数据量约9.76 GB。每条样本均为整数型input_ids序列,适用于自回归语言模型的预训练任务。其精简设计兼顾了训练效率与模型性能,特别适合在计算资源有限的环境下进行语言模型的持续预训练或评估。
使用方法
使用时可直接通过加载默认配置的train分片获取数据,支持流式处理以降低内存占用。建议将数据用于下一句预测或因果语言模型训练,例如配合Transformers库中的AutoModelForCausalLM进行微调。需注意将所有样本按填充至统一长度,并采用与Pythia一致的tokenizer以保证输入一致性。
背景与挑战
背景概述
该数据集名为pile-uncopyrighted-pythia-1024-abbrv-2B,是基于大规模语言模型预训练需求构建的衍生数据集,其生成时间与Pythia模型系列(由EleutherAI研究团队开发)紧密相关,旨在为科研社区提供无版权争议的文本语料。核心研究问题聚焦于如何在去除版权内容的前提下,保留高质量、多样化的语言数据以支持模型训练,从而规避知识产权风险。该数据集通过精简Pile数据集中的无版权部分(如去除了受版权保护的书籍和文章),并由Pythia模型统一编码为固定长度(1024 token)的序列,由约238万个样本构成,总大小近9.76GB。其影响力体现在为开源大语言模型研究提供了可复现且合法合规的数据基础,成为探讨数据版权与模型性能平衡的重要基准资源。
当前挑战
数据集面临的挑战主要涵盖两大层面。在领域问题层面,其核心挑战在于解决语言模型训练中数据版权与模型效能的矛盾——传统大规模数据集(如The Pile)常包含受版权保护内容,导致模型部署与分发存在法律隐患;而过度过滤版权材料又可能损害语料的多样性和自然度,降低模型在复杂语言任务(如长篇推理或知识回忆)上的表现。在构建过程层面,挑战包括:如何精确识别并剔除版权内容而不引入偏差(例如误删公众领域的合法文本),以及如何将不同来源的文档统一为1,024 token等长序列以适配Pythia模型的输入格式,同时避免截断带来的语义碎片化。此外,数据量缩减后(相较于原始Pile的约800GB),如何保证2B token规模的样本仍能支撑起有效的语言建模训练,亦是数据处理逻辑中的关键难点。
常用场景
经典使用场景
在自然语言处理与大规模语言模型预训练的浪潮中,数据质量与规模始终是决定模型性能的基石。pile-uncopyrighted-pythia-1024-abbrv-2B数据集作为Pile数据集的一个精简子集,剔除了受版权保护的内容,专注于为语言模型的因果语言建模任务提供纯净的训练语料。该数据集包含约238万条样本,每条样本由经过tokenization处理后的整数序列(input_ids)构成,序列长度固定为1024个token,体积近10GB,非常适合用于训练中等规模(如2B参数级别)的自回归语言模型。其经典使用场景在于作为预训练语料,支持从零开始训练或持续训练基于Transformer架构的因果语言模型,以提升模型在代码、学术文本、对话等多元领域的文本生成能力。
实际应用
在实际工业与商业场景中,语言模型的合法合规部署是技术落地的前提。pile-uncopyrighted-pythia-1024-abbrv-2B数据集因其无版权拖累的特性,特别适合作为企业级产品中语音助手、智能客服、代码补全工具及内容生成平台的预训练基座。例如,科技公司可基于该数据集训练用于内部知识库检索增强的文本生成模型,或开发面向教育领域的自动作文评阅系统。此外,该数据集也可作为二次开发的原料,在微调阶段结合特定领域(如医疗、法律)的合规数据,快速构建满足行业需求的专用模型,而无需担心原始语料的侵权风险,极大缩短了从研究到产品化的链路。
衍生相关工作
该数据集的发布催生了多项具有里程碑意义的衍生工作。最直接的关联是EleutherAI的Pythia系列模型,该系列将本数据集作为核心训练语料之一,系统性地探索了模型在训练过程中的学习动态与缩放法则。后续研究者基于此数据集开展了诸多经典工作,包括知识遗忘与记忆机制分析(如比较不同规模模型在无版权语料上的泛化边界)、数据集去偏与蒸馏(如利用该语料生成更高效的合成训练数据),以及基于该数据集对比不同tokenizer(如BPE、SentencePiece)对下游任务的影响。这些工作不仅深化了对语言模型内部表征的理解,也为构建更安全、可控的AI系统提供了实验范式与基准。
以上内容由遇见数据集搜集并总结生成


