
GazeVaLM
收藏资源简介:
GazeVaLM是由西北大学团队构建的首个多观察者眼动追踪基准数据集,旨在评估AI生成胸片的临床真实性。该数据集包含16位放射科专家对30张真实和30张合成胸片的960条眼动记录,涵盖原始凝视样本、注视热图、扫描路径等丰富标注。数据通过严格四阶段流程生成,包括基于RoentGen扩散模型的合成图像生成、眼动实验设计、数据处理及多模态大模型评估。该数据集为医学图像感知研究提供了独特资源,可支持临床决策分析、人机交互比较以及生成图像真实性评估等前沿领域。
GazeVaLM is the first multi-observer eye-tracking benchmark dataset developed by a team from Northwestern University, designed to evaluate the clinical authenticity of AI-generated chest radiographs. This dataset contains 960 eye-tracking records from 16 radiologists who reviewed 30 real and 30 synthetic chest radiographs, with rich annotations covering raw gaze samples, fixation heatmaps, scanpaths, and more. The dataset is generated through a rigorous four-stage workflow, including synthetic image generation based on the RoentGen diffusion model, eye-tracking experiment design, data processing, and multimodal large model evaluation. This dataset provides a unique resource for medical image perception research, supporting cutting-edge areas such as clinical decision analysis, human-computer interaction comparison, and authenticity assessment of generated images.
GazeVaLM 数据集概述
数据集基本信息
- 数据集名称: GazeVaLM
- 存储库地址: https://huggingface.co/datasets/davidcwong/GazeVaLM
- 数据内容: 包含针对60张X光刺激图像(涵盖真实与AI生成图像)的凝视分析结果、专家评估数据以及大型语言模型(LLM)的输出数据。
数据文件结构与内容
1. 凝视分析结果 (Task1/ 与 Task2/)
每个任务目录下包含以下数据:
- 专家结果文件:
expert_results.csv- 列信息:
File Name: X光图像的文件名。- 所有编号列: 以观察者ID命名的列标题。
- 列信息:
- 每张图像的子文件夹 (例如
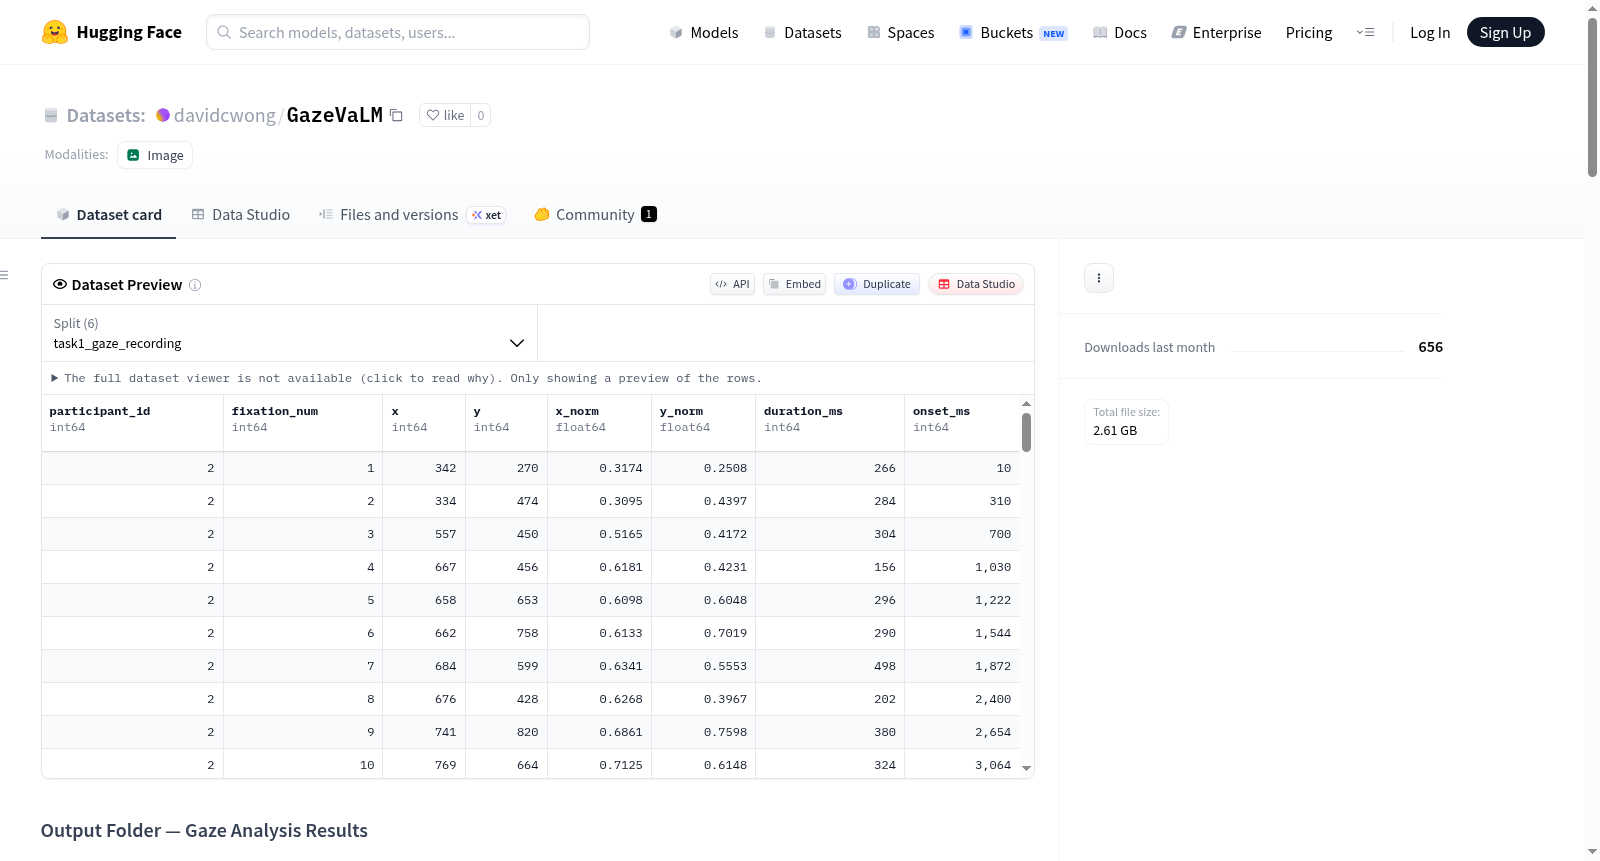
real_s55758034/,fake_s57321224/): 每个子文件夹包含7个文件:density_map.npy: 1080×1080 float32数组,所有观察者聚合的时长加权高斯热图,归一化至[0, 1]。density_map.png: 叠加在X光片上的相同热图(jet配色,白色背景)。density_map_black.png: 纯黑背景上的相同热图。fixation_map.npy: 1080×1080 float32数组,每像素原始注视点计数(无平滑处理)。fixation_map.png: 叠加在X光片上的注视点计数图(hot配色)。scanpaths.csv: 每位观察者的注视点表格。- 列信息:
participant_id: 观察者ID。fixation_num: 试验内的注视点顺序(从1开始)。x,y: 图像像素空间中的注视点位置(0–1079)。x_norm,y_norm: 相对于1080×1080图像的归一化位置(0–1)。duration_ms: 注视点持续时间(毫秒)。onset_ms: 从图像出现开始的注视点起始时间(毫秒)。
- 列信息:
scanpath_overlay.png: 绘制在X光片上的所有观察者扫描路径,每条路径使用不同颜色(最多16位观察者,无图例)。
2. 网格汇总图 (Grids/)
包含9张汇总图(200 DPI,白色背景),按诊断类别(正常、肺不张、肺炎、心脏肥大、胸腔积液)组织:
grid_Task1_real_density.png: 任务1 · 真实X光片 · 显著性叠加图。grid_Task1_real_scanpath.png: 任务1 · 真实X光片 · 扫描路径叠加图。grid_Task1_fake_density.png: 任务1 · AI生成图像 · 显著性叠加图。grid_Task1_fake_scanpath.png: 任务1 · AI生成图像 · 扫描路径叠加图。grid_Task2_real_density.png: 任务2 · 真实X光片 · 显著性叠加图。grid_Task2_real_scanpath.png: 任务2 · 真实X光片 · 扫描路径叠加图。grid_Task2_fake_density.png: 任务2 · AI生成图像 · 显著性叠加图。grid_Task2_fake_scanpath.png: 任务2 · AI生成图像 · 扫描路径叠加图。grid_combined.png: 单一复合图 — 涵盖所有8种组合的每个类别示例。
3. 大型语言模型数据 (LLM/)
包含5个CSV文件:
- 基准真值文件:
ground_truth.csv- 列信息:
ShuffledImageIndex: 图像在实验中出现的序列位置。RealImgName: X光图像的文件名。Real_Generated: 根据图像是真实或生成,取值为Real或Generated。
- 列信息:
- 已解析数据文件:
Task1_parsed.csv与Task2_parsed.csv- 列信息:
ShuffledImageIndex: 根据ground_truth.csv的图像索引号。LLM: 大型语言模型的名称。task: 分配给LLM的任务。findings: LLM发现的数组。impression: LLM撰写的印象。confidence: LLM对其回答的信心度(1到4分)。findings_text: LLM的发现结果字符串。
- 列信息:
- 未解析数据文件:
Task1_unparsed.csv与Task2_unparsed.csv- 列信息:
ShuffledImageIndex: 根据ground_truth.csv的图像索引号。LLM: 大型语言模型的名称。JSON: 来自LLM的原始JSON响应。
- 列信息:
数据配置
数据集的Hugging Face配置 (sample) 定义了以下数据文件分割:
task1_gaze_recording:Task1/fake_s58630288/scanpaths.csvtask2_gaze_recording:Task2/fake_s58630288/scanpaths.csvTask1_expert:Task1/expert_results.csvTask2_expert:Task2/expert_results.csvllm_task1:LLM/Task1_parsed.csvllm_task2:LLM/Task2_parsed.csv
- 1GazeVaLM: A Multi-Observer Eye-Tracking Benchmark for Evaluating Clinical Realism in AI-Generated X-Rays西北大学; 巴黎第十三大学; 芝加哥洛约拉大学; 杜佩奇医疗集团; 埃默里大学 · 2026年


