
oaimli/PeerSum
收藏官方服务:
资源简介:
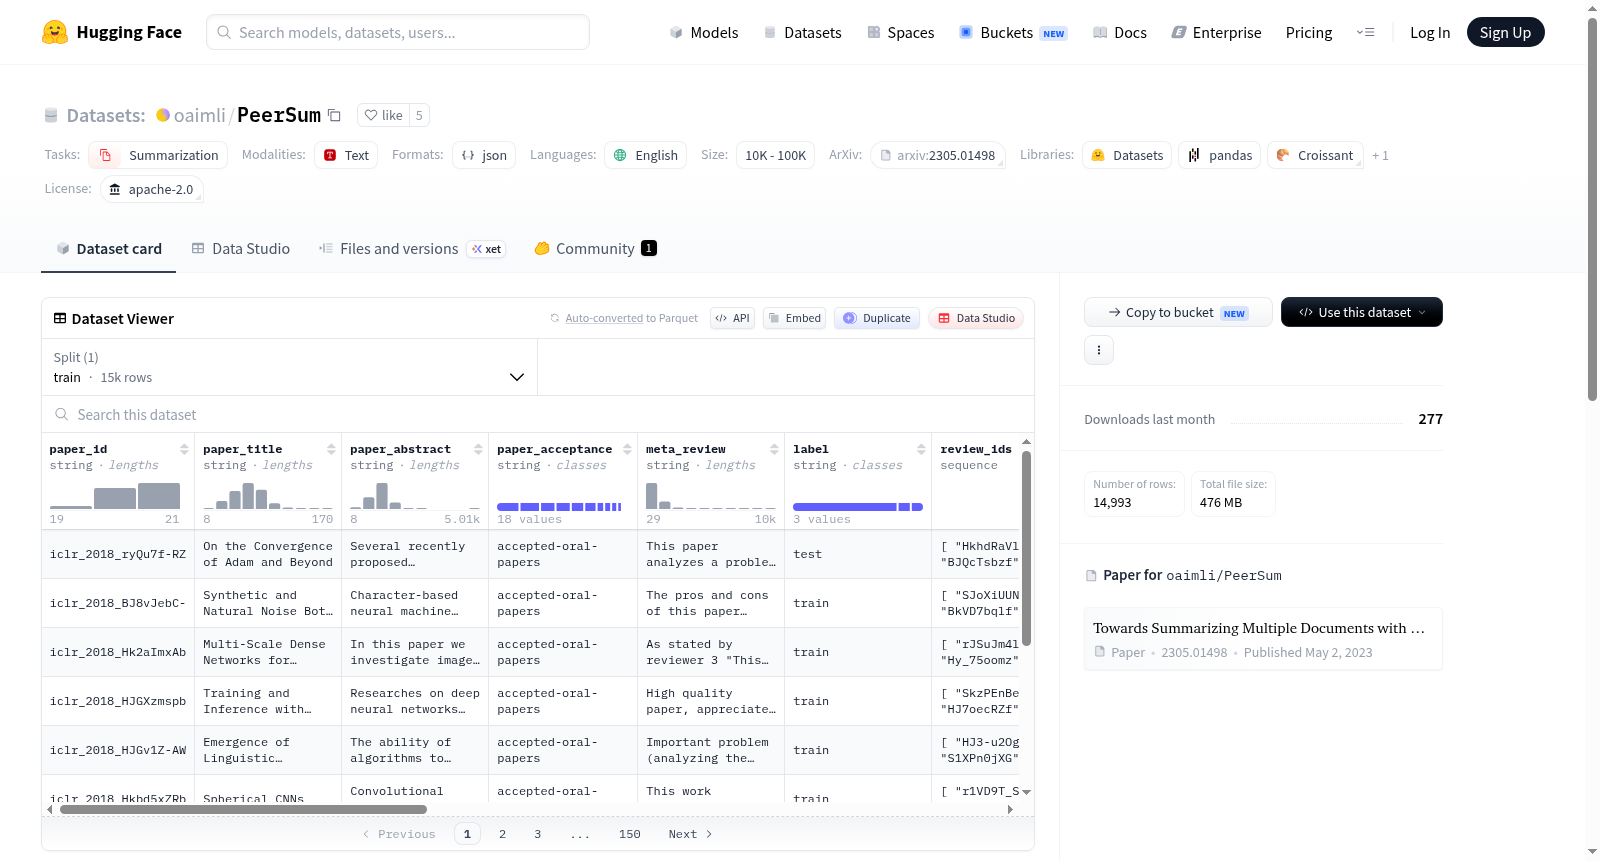
PeerSum是一个用于多文档摘要的同行评审领域数据集。每个样本包含以下信息:论文ID(链接到原始数据)、论文标题、论文摘要、论文接受情况、元评审、评审ID列表、评审作者列表、评审内容列表、评审评分列表、评审置信度列表、评审回复对象列表以及标签(训练、验证、测试)。原始数据包含更多信息,可用于其他同行评审分析。
PeerSum是一个用于多文档摘要的同行评审领域数据集。每个样本包含以下信息:论文ID(链接到原始数据)、论文标题、论文摘要、论文接受情况、元评审、评审ID列表、评审作者列表、评审内容列表、评审评分列表、评审置信度列表、评审回复对象列表以及标签(训练、验证、测试)。原始数据包含更多信息,可用于其他同行评审分析。
提供机构:
oaimli原始信息汇总
数据集概述
数据集名称
- PeerSum
数据集用途
- 多文档摘要生成
数据集领域
- 同行评审
数据集语言
- 英语
数据集大小
- 10K<n<100K
数据集内容结构
paper_id: 字符串(原始数据链接)paper_title: 字符串paper_abstract: 字符串paper_acceptance: 字符串meta_review: 字符串review_ids: 字符串列表review_writers: 字符串列表review_contents: 字符串列表review_ratings: 整数列表review_confidences: 整数列表review_reply_tos: 字符串列表label: 字符串(train, val, test)
数据集下载方式
- 通过Huggingface的datasets库下载
- 原始数据可从Google Drive下载
搜集汇总
数据集介绍
构建方式
PeerSum数据集专为同行评审领域的多文档摘要任务而设计,其构建基于学术论文评审流程中的对话结构。数据源自公开的同行评审记录,通过系统化收集论文元数据、评审意见、作者回复及最终元评审等内容,形成结构化的样本。每个样本包含论文标题、摘要、接受状态、元评审文本,以及多位评审者的评语、评分、置信度和回复关系等字段,并依据标准划分训练、验证和测试子集,以支持元评审生成的监督学习。
特点
该数据集的核心特点在于其独特的对话式多文档结构,能够捕捉评审过程中评审者与作者之间的交互逻辑,为生成综合性元评审提供丰富的上下文信息。包含超过一万个样本,覆盖多种评审维度如评分与置信度,且每个样本关联多个评审文档,体现了真实学术评审的复杂性和多样性。此外,数据遵循Apache-2.0许可,便于研究社区广泛使用与扩展。
使用方法
使用PeerSum时,可通过HuggingFace的datasets库便捷加载,利用load_dataset函数获取全部数据,再基于'label'字段过滤训练、验证和测试集。每个样本以字典形式提供,键包括paper_id、meta_review等,可直接用于多文档摘要模型的输入与评估。原始数据还提供额外信息,适合进行更深入的评审分析,用户可从Google Drive下载以扩展应用场景。
背景与挑战
背景概述
在学术出版领域,同行评审是保障科研质量的核心环节,然而随着论文数量的激增,审稿意见的整合与元综述的生成变得日益繁重。PeerSum数据集由oaimli团队于EMNLP 2023上提出,旨在解决多文档摘要中对话结构建模的难题,特别聚焦于同行评审场景下的元综述自动生成。该数据集汇集了超过1万篇学术论文的评审对话、元综述及元数据,涵盖接收与拒稿两种决策类型,为研究如何从多篇评审意见中提取关键信息并生成凝练的总结提供了标准化基准。其发布填补了学术评审领域高质量多文档摘要数据集的空白,推动了自然语言处理技术在科研辅助工具中的实际应用,对提升评审效率与透明度具有重要价值。
当前挑战
PeerSum数据集面临的核心挑战源于同行评审文本的独特复杂性。首先,评审意见常包含技术细节、主观评价与反驳争论,多篇评审之间可能存在观点冲突或重叠,模型需在保留关键分歧的同时实现信息压缩,这对摘要的忠实性与一致性提出了严苛要求。其次,评审对话具有隐式的交互结构,如回复链与评分关联,传统多文档摘要方法难以有效捕捉此类非连续对话流。在数据集构建过程中,从不同会议平台收集原始数据时需处理格式异构、隐私脱敏及标注噪声等问题,例如评审内容中缩写与领域术语的规范化,以及元综述与评审意见之间语义对齐的标注一致性维护。这些挑战共同限制了现有模型在该任务上的表现,亟需发展更适应对话式多文档结构的摘要技术。
常用场景
经典使用场景
PeerSum数据集专为多文档摘要任务而设计,尤其聚焦于同行评审领域的元综述生成。其经典使用场景在于,模型需要综合多篇评审意见、论文标题与摘要等异构文本,自动生成结构化的元综述。这一过程模拟了学术会议中领域主席整合多位评审人观点、形成最终决策摘要的认知流程,因而成为检验模型在复杂对话式文档中提取核心信息能力的理想基准。
实际应用
在实际应用中,PeerSum可赋能学术出版平台与会议管理系统,辅助领域主席高效生成元综述草稿,从而缩短审稿周期并减轻人工负担。此外,该数据集还可用于构建智能科研辅助工具,例如自动总结论文投稿的优劣势、识别评审意见中的矛盾点,或为作者提供针对性的修改建议,最终促进学术交流的透明化与效率化。
衍生相关工作
基于PeerSum,研究者已衍生出多项经典工作,包括引入对话结构感知的图神经网络进行元综述生成,以及利用预训练语言模型在评审对话中建模局部与全局语义关联。此外,该数据集还催生了针对评审质量分析、评分预测与置信度校准的交叉研究,其原始数据中的丰富元信息更被用于探索评审偏见检测与多任务学习框架,进一步拓展了学术文本挖掘的边界。
以上内容由遇见数据集搜集并总结生成


