遇见数据集

fifi777/text2dv_code

收藏
Hugging Face2023-03-08 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: id dtype: int64 - name: content sequence: string - name: preprocessing_code sequence: string - name: visualization_code sequence: string - name: model dtype: string - name: running_info struct: - name: error dtype: bool - name: error_msg dtype: string - name: library sequence: string - name: meet_expectation dtype: bool - name: time dtype: float64 - name: token struct: - name: completion_tokens dtype: int64 - name: prompt_tokens dtype: int64 - name: total_tokens dtype: int64 - name: prompt_info struct: - name: dataset dtype: string - name: plot_type dtype: string - name: promote dtype: string - name: __index_level_0__ dtype: int64 splits: - name: python num_bytes: 372637 num_examples: 200 download_size: 0 dataset_size: 372637 --- # Dataset Card for "text2dv_code" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
fifi777
原始信息汇总

数据集概述

数据集名称

  • 名称: text2dv_code

数据集特征

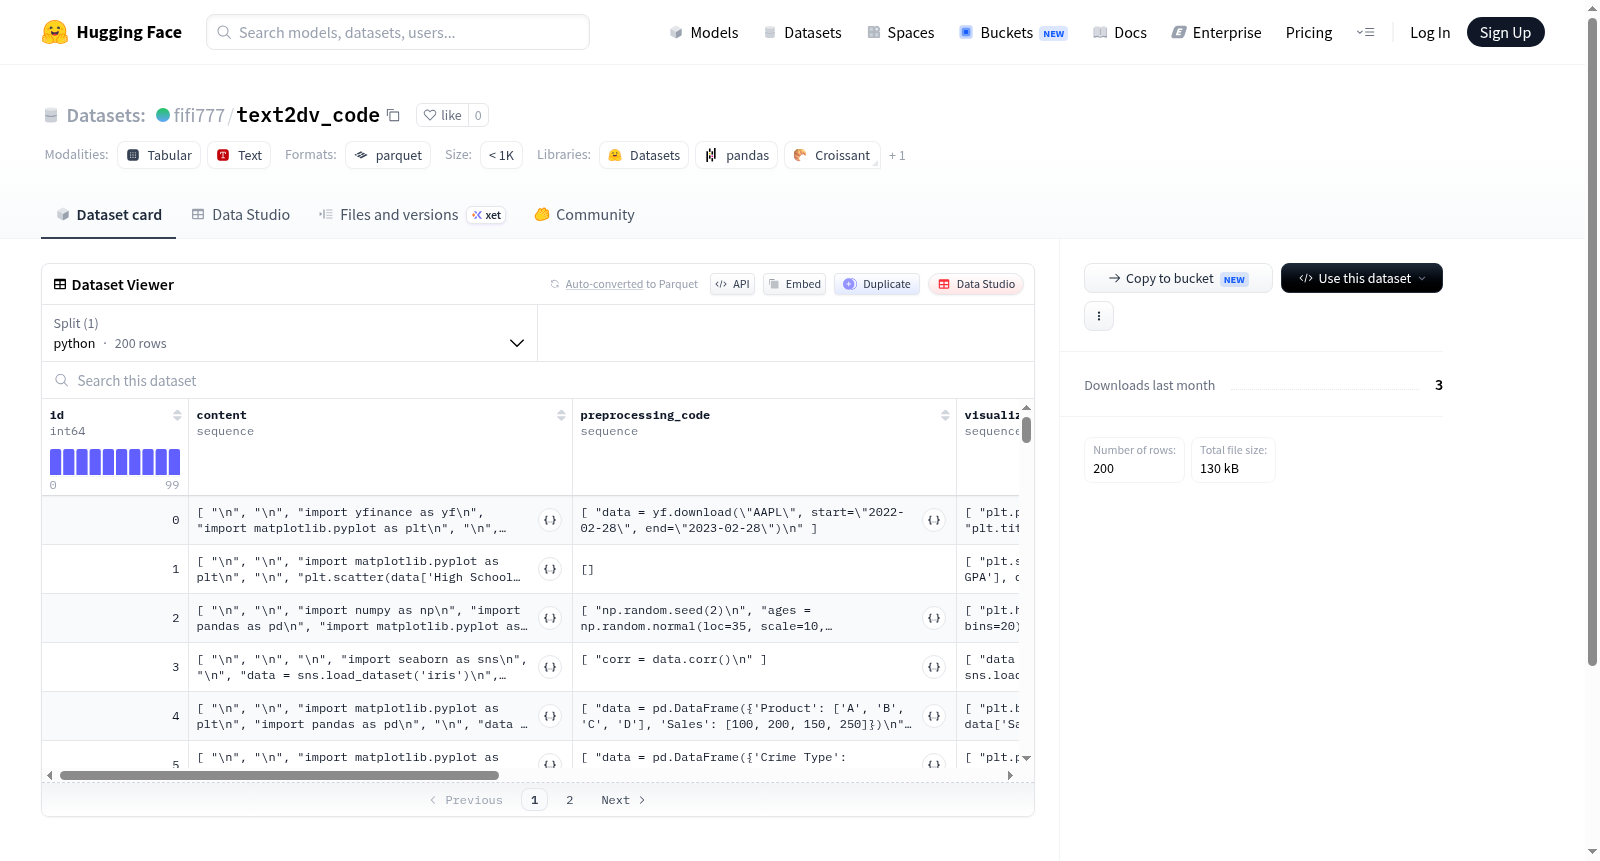
  • id: 整数类型 (int64)
  • content: 字符串序列
  • preprocessing_code: 字符串序列
  • visualization_code: 字符串序列
  • model: 字符串类型
  • running_info: 结构体,包含以下字段:
    • error: 布尔类型 (bool)
    • error_msg: 字符串类型 (string)
    • library: 字符串序列
    • meet_expectation: 布尔类型 (bool)
    • time: 浮点数类型 (float64)
    • token: 结构体,包含以下字段:
      • completion_tokens: 整数类型 (int64)
      • prompt_tokens: 整数类型 (int64)
      • total_tokens: 整数类型 (int64)
  • prompt_info: 结构体,包含以下字段:
    • dataset: 字符串类型 (string)
    • plot_type: 字符串类型 (string)
    • promote: 字符串类型 (string)
  • index_level_0: 整数类型 (int64)

数据集分割

  • python: 数据大小为372637字节,包含200个示例。

数据集大小

  • 下载大小: 0字节
  • 数据集大小: 372637字节
搜集汇总
数据集介绍
fifi777/text2dv_code 数据集图片
构建方式
在数据驱动的可视化研究领域,text2dv_code数据集应运而生,旨在弥合自然语言描述与三维可视化代码生成之间的鸿沟。该数据集通过系统化采集与结构化整理构建而成,共收录200条高质量样本。每条样本包含唯一标识符、多段文本内容、预处理代码与可视化代码序列,以及模型信息与运行状态记录。运行信息字段详细记录了执行过程中的错误标志、错误消息、依赖库、预期匹配度、执行耗时及令牌消耗量,从而确保每条数据都具备完整的技术可溯源性。提示信息字段则保存了原始数据集来源、图表类型与用户提示词,为后续的代码生成任务提供了丰富的上下文支撑。
特点
该数据集的核心特色在于其多维度的结构化设计。不同于传统仅包含文本-代码对的数据集,text2dv_code同时收录了预处理与可视化两个阶段的代码序列,能够完整反映从数据清洗到图形渲染的全流程。运行信息中的错误标志与错误消息字段,使得研究者可以针对性地分析代码生成的失败模式。令牌消耗量的细粒度记录,则为评估大语言模型的计算效率提供了宝贵的基准数据。此外,提示信息中明确的图表类型与数据集来源,支持对特定可视化场景进行定向的模型微调与评估。
使用方法
text2dv_code数据集的使用灵活而高效。研究者可直接加载Python分区的全部200条样本,利用content字段作为输入文本,以preprocessing_code和visualization_code作为目标输出,构建端到端的代码生成模型。运行信息中的meet_expectation字段可作为质量筛选的依据,仅保留符合预期的样本用于训练。令牌消耗量数据支持对模型推理成本进行量化分析。提示信息中的plot_type字段允许按图表类别划分数据子集,实现针对条形图、散点图等特定可视化类型的专项训练。数据集以标准HuggingFace格式存储,可通过datasets库的load_dataset函数一键加载,无缝集成至现有机器学习流水线。
背景与挑战
背景概述
在数据可视化领域,自然语言到数据可视化的自动转换(Text-to-Data Visualization)是一项前沿研究课题,旨在降低用户从文本描述生成图表的技术门槛。fifi777/text2dv_code数据集由研究人员于近期构建,聚焦于将自然语言指令转化为可执行的预处理与可视化代码。该数据集包含200个样本,每个样本涵盖内容描述、预处理代码、可视化代码、模型信息及运行结果反馈,核心研究问题在于评估大语言模型在代码生成任务中的准确性与鲁棒性。作为该领域的基准资源,它填补了中文环境下文本驱动可视化代码生成的数据空白,对推动自动化数据叙事与交互式分析工具的发展具有重要影响。
当前挑战
当前数据集面临的主要挑战包括:一、领域问题层面,文本到可视化的转换需解决自然语言歧义性与图表类型多样性之间的映射难题,现有模型在理解复杂语义(如多维度筛选、聚合运算)时易产生错误代码;二、构建过程中,数据标注依赖人工对模型生成代码的验证,200个样本的规模限制了泛化能力,同时运行环境差异(如库版本兼容性)导致错误率统计存在偏差。此外,如何确保生成的代码符合用户预期(meet_expectation字段)仍是评估难点,需更精细的指标来量化代码的功能正确性与视觉呈现一致性。
常用场景
经典使用场景
在数据可视化与自然语言处理交叉领域,fifi777/text2dv_code数据集为文本到二维可视化代码生成任务提供了标准化的数据支撑。该数据集包含200条精心标注的样本,每条样本由自然语言描述的内容文本、对应的数据预处理代码、可视化渲染代码以及运行结果元信息构成。研究者可借助该数据集训练模型,使其能够将用户以自然语言表达的可视化需求(如“绘制某年度各产品销售额的柱状图”)自动转化为可直接执行的Python代码,从而弥合人类直觉表达与机器指令执行之间的鸿沟。
衍生相关工作
基于该数据集,研究者已衍生出多项经典工作。例如,利用其结构化元信息设计奖励函数,通过强化学习优化模型在可视化代码生成中的执行成功率;或是将其作为多模态对齐研究的基准,对比不同大语言模型在代码与自然语言映射上的表现差异。此外,该数据集还启发了针对可视化代码错误诊断与修复的专项研究,通过分析running_info中的错误信息,训练模型具备自我纠错能力。
数据集最近研究
最新研究方向
在自然语言处理与数据可视化交叉领域,text2dv_code数据集聚焦于文本到动态可视化代码生成的自动化任务,为前沿的代码智能与多模态生成研究提供了关键支撑。该数据集收录了包含预处理与可视化代码、运行状态及模型信息的结构化样本,其设计紧密关联当前大语言模型在代码生成中的鲁棒性与可执行性挑战,尤其是在处理复杂可视化需求时对错误信息与执行时间的精细化建模。这一方向呼应了生成式AI在数据叙事与交互式分析中的热点应用,通过系统化评估模型生成代码的准确性与效率,推动从静态图表到动态可视化的范式演进,为智能数据分析工具的开发奠定了实证基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务