Nemotron-Personas-Belgium
收藏资源简介:
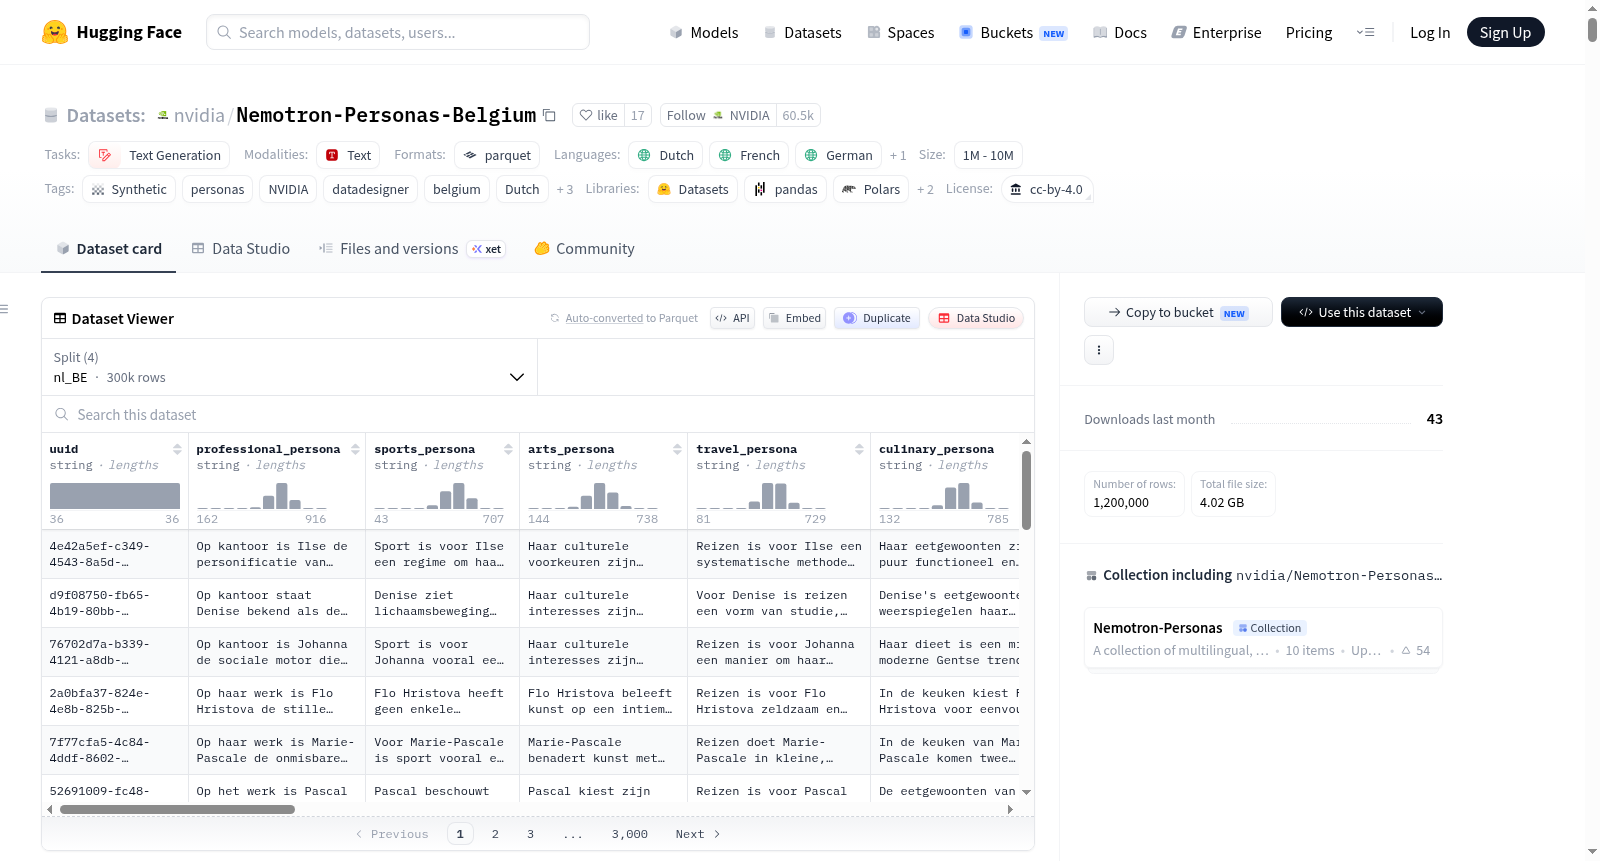
Nemotron-Personas-Belgium是一个开源的合成生成人物角色数据集,采用CC BY 4.0许可协议。该数据集旨在反映比利时人口的多样性和丰富性,其生成过程严格基于比利时真实的人口统计学、地理学和语言学分布。数据集是Nemotron-Personas系列的一部分,也是Nemotron-Personas-USA的变体,是首个此类开放的比利时数据集。核心特征是多语言性:每个人物角色都完整地提供了荷兰语、法语、德语和英语四个版本的描述,并对应四个独立的数据分片(nl_BE, fr_BE, de_BE, en_BE),每个分片包含30万条样本,总计约120万条样本,数据规模在100万到1000万条之间。每条数据记录包含22个特征字段,涵盖唯一标识符、多个特定领域的角色描述(如专业、体育、艺术、旅行、烹饪)、综合角色描述、文化背景、技能与专长、兴趣与爱好、职业目标与抱负,以及详细的人口统计学和地理信息(包括性别、年龄、婚姻状况、家庭类型、教育水平、职业、行业、所在市镇、地区和国籍)。数据集由Pleias、NVIDIA和KU Leuven合作开发,使用企业级复合AI系统NeMo Data Designer生成,结合了专有的概率图模型和Apache-2.0许可的google/gemma-4-31B-it模型。其设计目标是支持比利时和欧洲的模型开发者构建“主权AI”系统,通过融入地区特定的人口统计和文化背景,提高合成生成数据的多样性,减轻数据与模型偏见,并防止“模型崩溃”。数据集特别强调在年龄、地理、语言、教育和职业等多个维度上代表底层的人口分布。注意:数据集聚焦于角色描述,不包含姓名、收入、人格特质等中间建模字段,所有数据均为人工合成生成,适用于商业用途,如主权AI、大语言模型训练等场景。
Nemotron-Personas-Belgium is an open-source synthetic persona dataset released under the CC BY 4.0 license. It aims to reflect the diversity and richness of the Belgian population, with its generation process strictly based on real demographic, geographic, and linguistic distributions in Belgium. The dataset is part of the Nemotron-Personas series and a variant of Nemotron-Personas-USA, representing the first open dataset of its kind for Belgium. Its core feature is multilingualism: each persona is fully described in four languages—Dutch, French, German, and English—corresponding to four independent data shards (nl_BE, fr_BE, de_BE, en_BE), each containing 300,000 samples, totaling approximately 1.2 million samples, with a data scale between 1 million and 10 million. Each data record includes 22 feature fields, covering a wide range of information dimensions: unique identifier (uuid), multiple domain-specific persona descriptions (professional, sports, arts, travel, culinary), comprehensive persona description, cultural background, skills and expertise (in text and list formats), interests and hobbies (in text and list formats), career goals and aspirations, and detailed demographic and geographic information, including gender, age, marital status, household type, education level, occupation, industry, municipality, region, and nationality (Belgian). The dataset was collaboratively developed by Pleias, NVIDIA, and KU Leuven, using the enterprise-grade composite AI system NeMo Data Designer, which combines proprietary probabilistic graphical models with the Apache-2.0 licensed `google/gemma-4-31B-it` model. Its design goal is to support Belgian and European model developers in building sovereign AI systems by incorporating region-specific demographic and cultural contexts, enhancing the diversity of synthetic data, mitigating data and model biases, and preventing model collapse from training on unfiltered outputs from other models. The dataset emphasizes representing the underlying population distribution across multiple dimensions such as age, geography, language, education, and occupation more effectively than other persona datasets. Note: The dataset focuses on persona descriptions and thus excludes intermediate modeling fields like names, income, and personality traits, as well as personas typically associated with enterprise clients (e.g., finance, healthcare). All data is synthetically generated, and any resemblance to real persons is coincidental. The dataset is ready for commercial use, suitable for scenarios involving sovereign AI, large language model training, and development aimed at improving synthetic data diversity, mitigating bias, and preventing model collapse.
数据集概述
Nemotron-Personas-Belgium 是一个由 NVIDIA 联合 Pleias 和 KU Leuven 开发的开源、多语言合成人物(persona)数据集。它旨在反映比利时真实的人口、地理和语言分布,为构建区域特定的主权人工智能系统提供高质量数据。
核心特性
- 内容:包含约 120 万条(1M < n < 10M)合成生成的人物画像。
- 语言:数据集具有多语言特性,每个人物画像都提供了荷兰语(nl)、法语(fr)、德语(de)和英语(en)四个完整翻译版本。
- 生成基础:数据基于比利时 2021 年人口普查的真实分布,涵盖了三个大区、四个语言区域以及全部 581 个市镇。
- 生成工具:采用 NVIDIA 的 NeMo Data Designer 企业级复合 AI 系统,结合专有的概率图模型(PGM)与 Apache-2.0 许可的
google/gemma-4-31B-it模型生成。 - 许可证:采用 Creative Commons Attribution 4.0 International (CC BY 4.0) 许可协议,可用于商业用途。
数据拆分
数据按语言拆分为四个独立的部分,每个部分包含 300,000 个样本:
- nl_BE (荷兰语 - 比利时):样本数: 300,000
- fr_BE (法语 - 比利时):样本数: 300,000
- de_BE (德语 - 比利时):样本数: 300,000
- en_BE (英语 - 比利时):样本数: 300,000
特征字段
每条记录包含丰富的属性来描述人物画像,共计 22 个特征:
- 标识与年龄:
uuid(字符串),age(整数) - 性别与婚姻:
sex(字符串),marital_status(字符串) - 地理信息:
municipality(字符串),region(字符串),country(字符串) - 教育职业:
education_level(字符串),occupation(字符串),industry(字符串) - 家庭与背景:
household_type(字符串),cultural_background(字符串) - 详细画像:
professional_persona(字符串),sports_persona(字符串),arts_persona(字符串),travel_persona(字符串),culinary_persona(字符串),persona(字符串) - 技能与兴趣:
skills_and_expertise(字符串),skills_and_expertise_list(字符串),hobbies_and_interests(字符串),hobbies_and_interests_list(字符串) - 职业目标:
career_goals_and_ambitions(字符串)
应用场景
该数据集旨在帮助开发者:
- 开发符合地区特定人口统计和文化背景的主权 AI 系统。
- 训练大型语言模型(LLM)。
- 提高合成生成数据的多样性,减轻数据和模型的偏见,并预防模型崩溃(model collapse)。
数据排除项
数据集明确不包含以下内容:
- 个人姓名、收入、性格特征。
- NeMo Data Designer 中可用的其他中间建模字段(如姓名文化渊源标签、姓名语言概率等)。
- 通常与企业客户相关的画像领域(如金融、医疗健康)。