
OpenLLM-Ro/ro_sft_llava_mix
收藏官方服务:
资源简介:
LlavaMix是一个为视觉指令调谐和构建大型多模态模型以接近GPT-4视觉/语言能力而构建的数据集。这里提供的是LlavaMix数据集的罗马尼亚语翻译版本,使用Seed-X-PPO进行翻译。该数据集是罗马尼亚视觉语言模型指令微调协议的一部分,相关论文为Înțelegi românește? A Recipe for Romanian Vision-Language Models。
LlavaMix is a dataset constructed for visual instruction tuning and for building large multimodal towards GPT-4 vision/language capability. Here we provide the Romanian translation of the LlavaMix dataset, translated with Seed-X-PPO. This dataset is part of the instruction finetune protocol for Romanian VLMs proposed in Înțelegi românește? A Recipe for Romanian Vision-Language Models.
提供机构:
OpenLLM-Ro搜集汇总
数据集介绍
构建方式
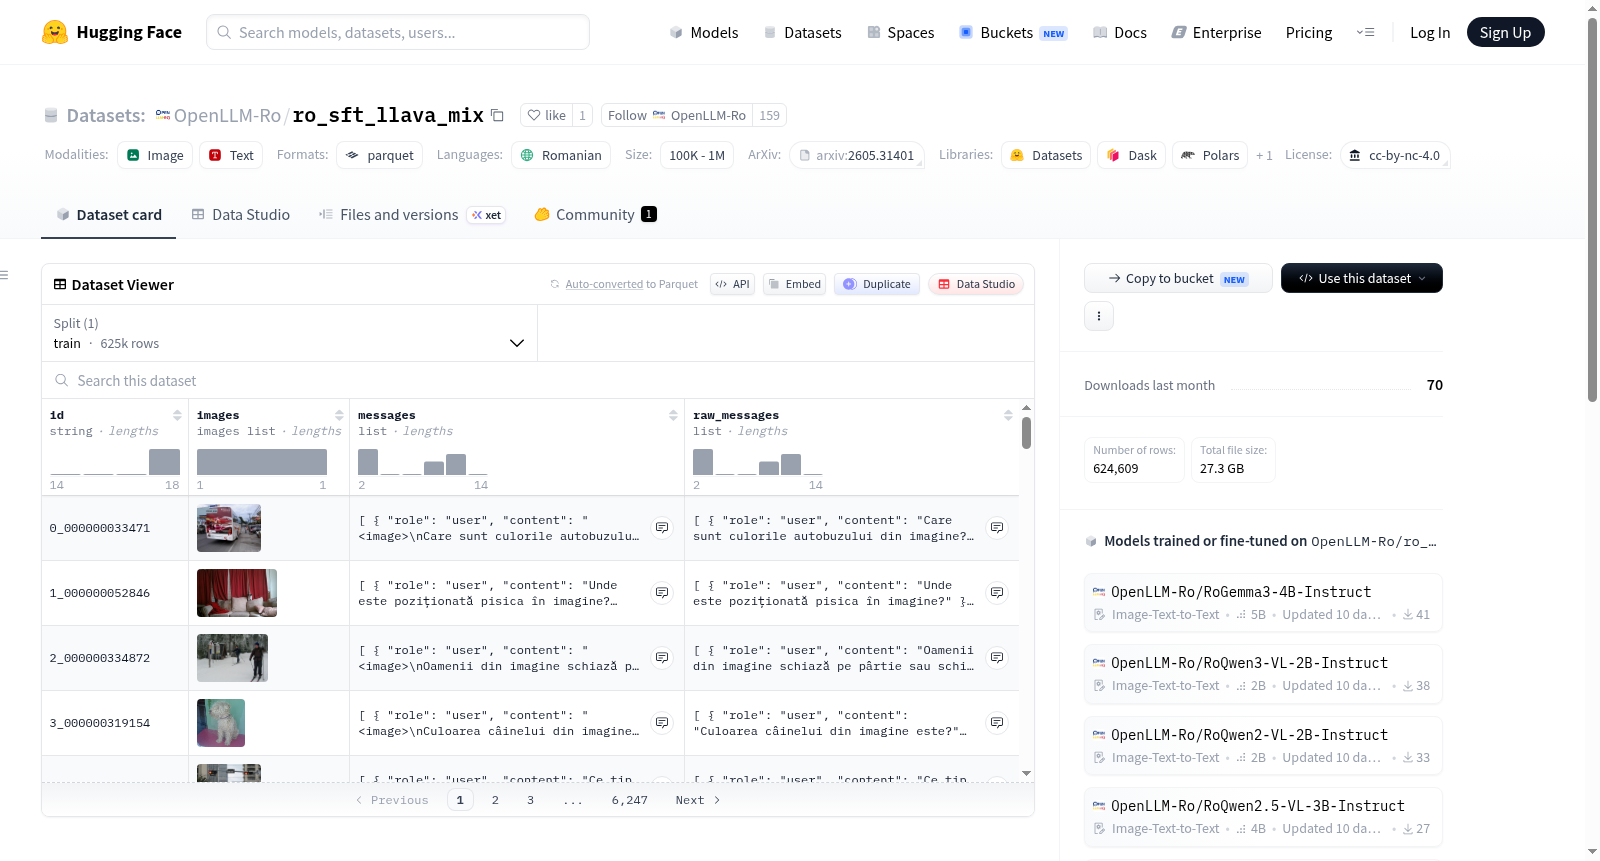
ro_sft_llava_mix数据集是基于LlavaMix的罗马尼亚语翻译版本,旨在为罗马尼亚语视觉语言模型的指令微调提供支持。原始LlavaMix数据集由Liu等人构建,专用于视觉指令微调,以推动多模态模型向GPT-4视觉与语言能力迈进。本数据集采用Seed-X-PPO模型(ByteDance-Seed/Seed-X-PPO-7B)对原始英文数据进行高质量罗马尼亚语翻译,确保了语言转换的准确性与自然度。数据集包含624609个训练样本,涵盖图像、多轮对话消息及原始消息等字段,存储规模约27.2GB,为罗马尼亚语视觉语言模型的训练提供了丰富的多模态指令数据。
特点
该数据集的核心特点在于其双语对齐与多模态融合性。通过Seed-X-PPO模型的翻译,数据集在保留原始LlavaMix视觉指令结构的基础上,实现了罗马尼亚语的高保真转换,支持罗马尼亚语视觉语言模型的指令微调。数据字段设计精细,包含id、images、messages及raw_messages,其中messages字段以角色(role)和内容(content)配对形式记录对话,便于模型学习视觉与语言的交互。此外,数据集规模庞大,训练样本超过62万条,覆盖多样化的视觉场景与指令类型,为模型提供了丰富的多模态学习素材,有助于提升模型在罗马尼亚语环境下的视觉理解与生成能力。
使用方法
用户可通过HuggingFace Datasets库轻松加载该数据集,使用load_dataset('ro_sft_llava_mix')即可获取默认配置的训练集。数据集以parquet格式存储,支持高效的数据流式读取。在模型训练中,建议将images字段作为视觉输入,messages字段作为指令与响应的对话序列,结合raw_messages字段进行数据验证或分析。该数据集专为罗马尼亚语视觉语言模型的指令微调设计,可配合常见的视觉编码器与语言模型框架(如LLaVA架构)使用,实现端到端的多模态训练。需注意数据集采用cc-by-nc-4.0许可证,适用于非商业研究场景。
背景与挑战
背景概述
在大规模多模态模型(LMM)蓬勃发展的浪潮中,视觉指令微调数据集成为提升模型对视觉与语言联合理解能力的关键基石。由Haotian Liu等人于2023年构建的LlavaMix数据集,作为视觉指令微调领域的代表性资源,旨在推动模型向GPT-4级别的视觉语言能力迈进。在此背景下,Mihai Masala等人于2026年提出了针对罗马尼亚语的翻译版本——ro_sft_llava_mix,该数据集利用ByteDance-Seed的Seed-X-PPO-7B模型完成高质量翻译,并作为其研究论文《“Înțelegi românește?” A Recipe for Romanian Vision-Language Models》中指令微调协议的核心组成部分。该工作填补了低资源语言罗马尼亚语在多模态视觉语言模型领域的空白,为促进语言多样化智能系统的发展奠定了重要基础。
当前挑战
该数据集所解决的核心领域问题在于,大多数视觉指令微调数据集集中于英语等资源丰富语言,严重限制了多模态模型对低资源语言的适应能力。构建过程中面临的挑战包括:其一,确保翻译的语义保真度与上下文一致性,避免机器翻译引入的语义偏差或信息丢失;其二,维持原始数据集中图像与指令对的复杂对齐关系,确保翻译后的罗马尼亚语指令仍能有效指导视觉理解任务;其三,处理大规模数据(约62万样本)的高效翻译与质量控制,在有限计算资源下实现可扩展的本地化流程。
常用场景
经典使用场景
在视觉语言模型(VLM)的研发中,指令微调数据集是提升模型多模态对齐能力的关键资源。ro_sft_llava_mix作为LlavaMix的罗马尼亚语翻译版本,旨在为低资源语言的多模态模型提供高质量的训练数据。该数据集的经典使用场景包括:用于罗马尼亚语视觉指令微调,使模型能够理解并执行基于图像的罗马尼亚语指令任务;作为跨语言迁移学习的桥梁,帮助多语言VLM在非英语环境下保持鲁棒性;同时支持多模态对话系统的开发,使模型在罗马尼亚语语境中实现图文交互。其精心设计的指令格式和多样化的视觉场景,为评估模型在罗马尼亚语中的视觉推理能力提供了标准化基准。
解决学术问题
该数据集直面当前多模态研究中的语言多样性匮乏问题,尤其解决了罗马尼亚语等低资源语言在视觉-语言任务中的学术空白。通过提供大规模、高质量的罗马尼亚语视觉指令数据,它使研究者能够探索跨语言视觉概念对齐的机制,并验证预训练模型在非英语语言上的泛化能力。这一工作打破了英语主导多模态研究的局限,推动了多语言VLM在语义理解、实体识别和情感分析等任务上的公平性评估。其意义在于证明了高效翻译策略(如Seed-X-PPO)可弥合资源差距,为构建包容性人工智能奠定了关键数据基础。
衍生相关工作
该数据集是《Înțelegi românește?》系列工作的核心组件,催生了一系列罗马尼亚语视觉语言模型的研究。其衍生工作包括:基于Seed-X-PPO翻译策略的跨语言指令数据构建框架,证明了大规模机器翻译在低资源语言多模态任务中的可行性;面向罗马尼亚语的视觉指令微调模型ROM-VLM系列,在多项基准上达到与英语模型可比的性能;以及多语言视觉问答基准测试集的开发,用于评估模型在不同语言下的零样本迁移能力。这些工作共同形成了一个从数据构建、模型训练到评估的完整生态链,为其他低资源语言的多模态研究提供了可复现的范式。
以上内容由遇见数据集搜集并总结生成


