HumanProteinAtlas
收藏资源简介:
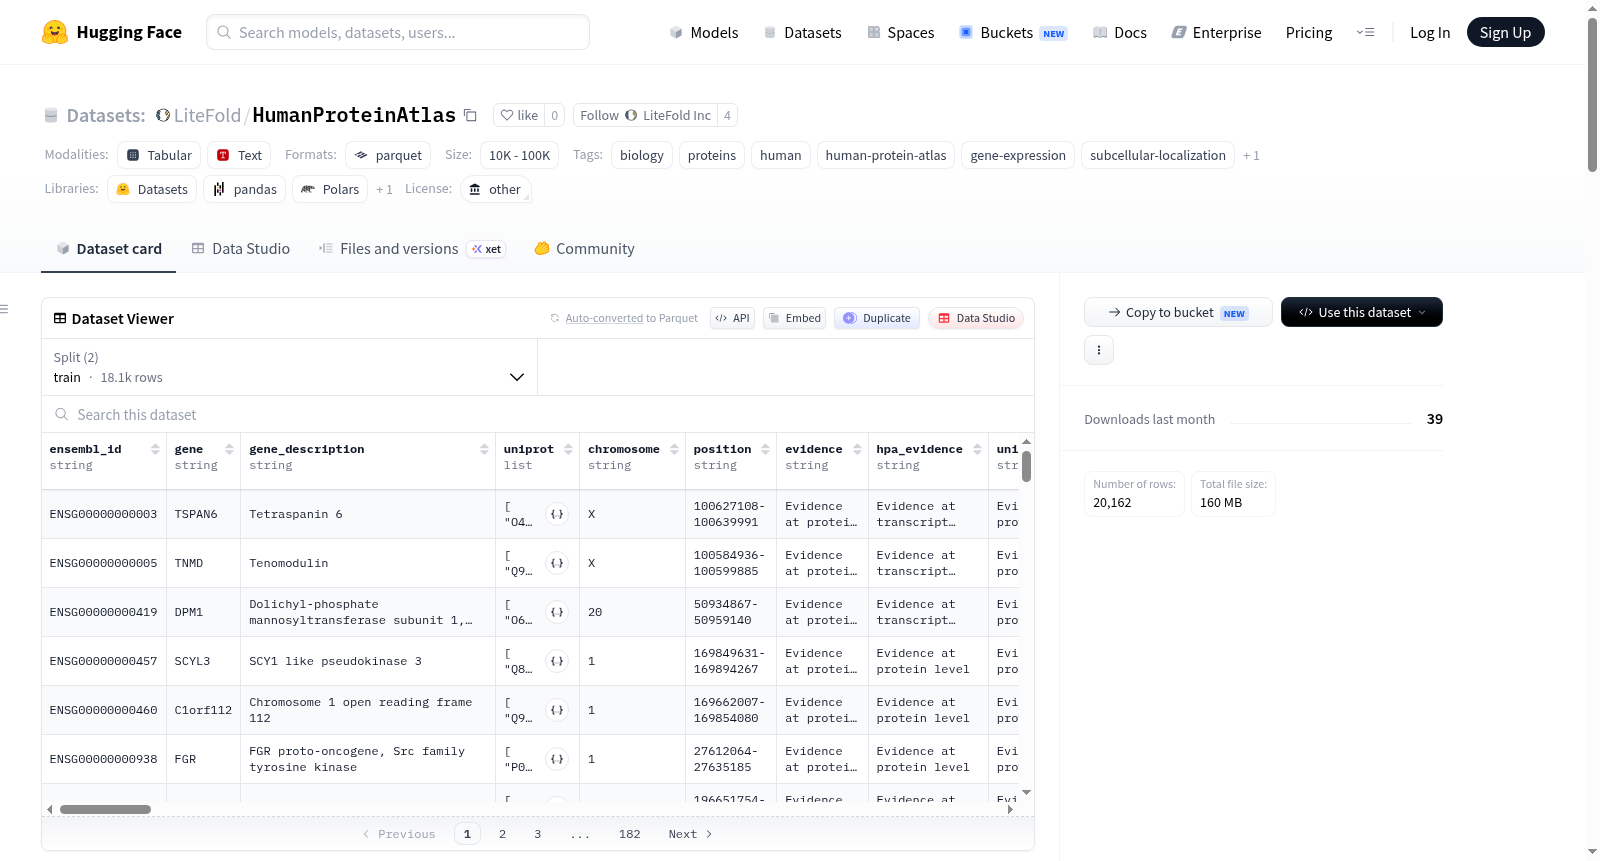
Human Protein Atlas Gene Annotations数据集是从Human Protein Atlas JSONL源数据转换而来的基因级Parquet表格,专为提升数据可读性和使用便利性而设计。该数据集以基因为核心单元,每行对应一个基因/蛋白质条目,总计包含20,162个基因记录,其中训练集18,138行,测试集2,024行,通过Ensembl ID的确定性哈希进行划分。数据集的核心特征包括25个关键字段,涵盖基因标识(如ensembl_id、gene、uniprot)、基因组位置(chromosome、position)、多源证据水平(evidence、hpa_evidence、uniprot_evidence、nextprot_evidence)、功能注释(protein_classes、biological_processes、molecular_functions)、亚细胞定位(subcellular_main_locations、subcellular_additional_locations)、分泌组信息(secretome_locations、secretome_functions)、RNA表达特征(rna_tissue_specificity、rna_tissue_distribution)以及癌症预后关联(prognostic_cancer_count、prognostic_cancers等)。此外,数据集还提供两个独立的元数据表:癌症预后元数据(442,504行)和RNA表达测量数据(149,150行),可通过特定接口加载。该数据集适用于生物信息学、蛋白质组学、基因功能注释、亚细胞定位预测、癌症生物标志物发现等研究任务,为研究人员提供了结构化的基因级注释信息。
数据集概述:Human Protein Atlas Gene Annotations
- 数据集名称: Human Protein Atlas Gene Annotations
- 许可证: 其他(other)
- 领域: 生物学、蛋白质、人类、基因表达、亚细胞定位
- 数据格式: Parquet
数据集规模与划分
| 划分 | 行数 |
|---|---|
| 训练集 (train) | 18,138 |
| 测试集 (test) | 2,024 |
| 总计 | 20,162 |
- 划分方法: 基于 Ensembl ID 的确定性哈希(
sha256(ensembl_id) % 10),哈希值 0 为测试集,1-9 为训练集。
数据集统计
| 字段 | 值 |
|---|---|
| 基因行数 | 20,162 |
| 癌症预后元数据行数 | 442,504 |
| RNA 表达测量行数 | 149,150 |
主要列说明
| 列名 | 说明 |
|---|---|
ensembl_id |
Ensembl 基因 ID |
gene |
基因符号 |
gene_description |
基因/蛋白质描述 |
uniprot |
UniProt 登录号(如可用) |
chromosome |
染色体 |
position |
基因组位置字符串 |
evidence |
主要 HPA 证据水平 |
hpa_evidence |
HPA 特有证据水平 |
uniprot_evidence |
UniProt 证据水平 |
nextprot_evidence |
neXtProt 证据水平 |
antibodies |
HPA 抗体 ID |
gene_synonyms |
基因同义词 |
protein_classes |
蛋白质类别标签 |
biological_processes |
生物过程注释 |
molecular_functions |
分子功能注释 |
disease_involvement |
疾病关联标签 |
subcellular_main_locations |
主要亚细胞定位 |
subcellular_additional_locations |
额外亚细胞定位 |
secretome_locations |
分泌组定位注释 |
secretome_functions |
分泌组功能注释 |
rna_tissue_specificity |
RNA 组织特异性类别 |
rna_tissue_distribution |
RNA 组织分布类别 |
prognostic_cancer_count |
基因在该癌症中具有预后意义的癌症数量 |
validated_prognostic_cancer_count |
已验证的预后癌症条目数量 |
potential_prognostic_cancer_count |
潜在的预后癌症条目数量 |
prognostic_cancers |
具有预后条目的癌症名称 |
split_bucket |
基于 sha256(ensembl_id) % 10 的确定性划分桶 |
访问与使用方式
- 加载数据集: 使用
datasets库,通过load_dataset("LiteFold/HumanProteinAtlas")加载所有划分,或指定split参数加载特定划分。 - 过滤示例: 可对数据行进行过滤,例如筛选具有蛋白质水平证据的基因(
evidence == "Evidence at protein level")。 - 元数据表加载: 可通过
huggingface_hub库直接下载癌症预后元数据(metadata/cancer_prognostics.parquet)和 RNA 表达测量元数据(metadata/rna_expression_measurements.parquet)。
数据准备
- 用于创建 Parquet 文件的标准化脚本位于
scripts/prepare_hpa_dataset.py。