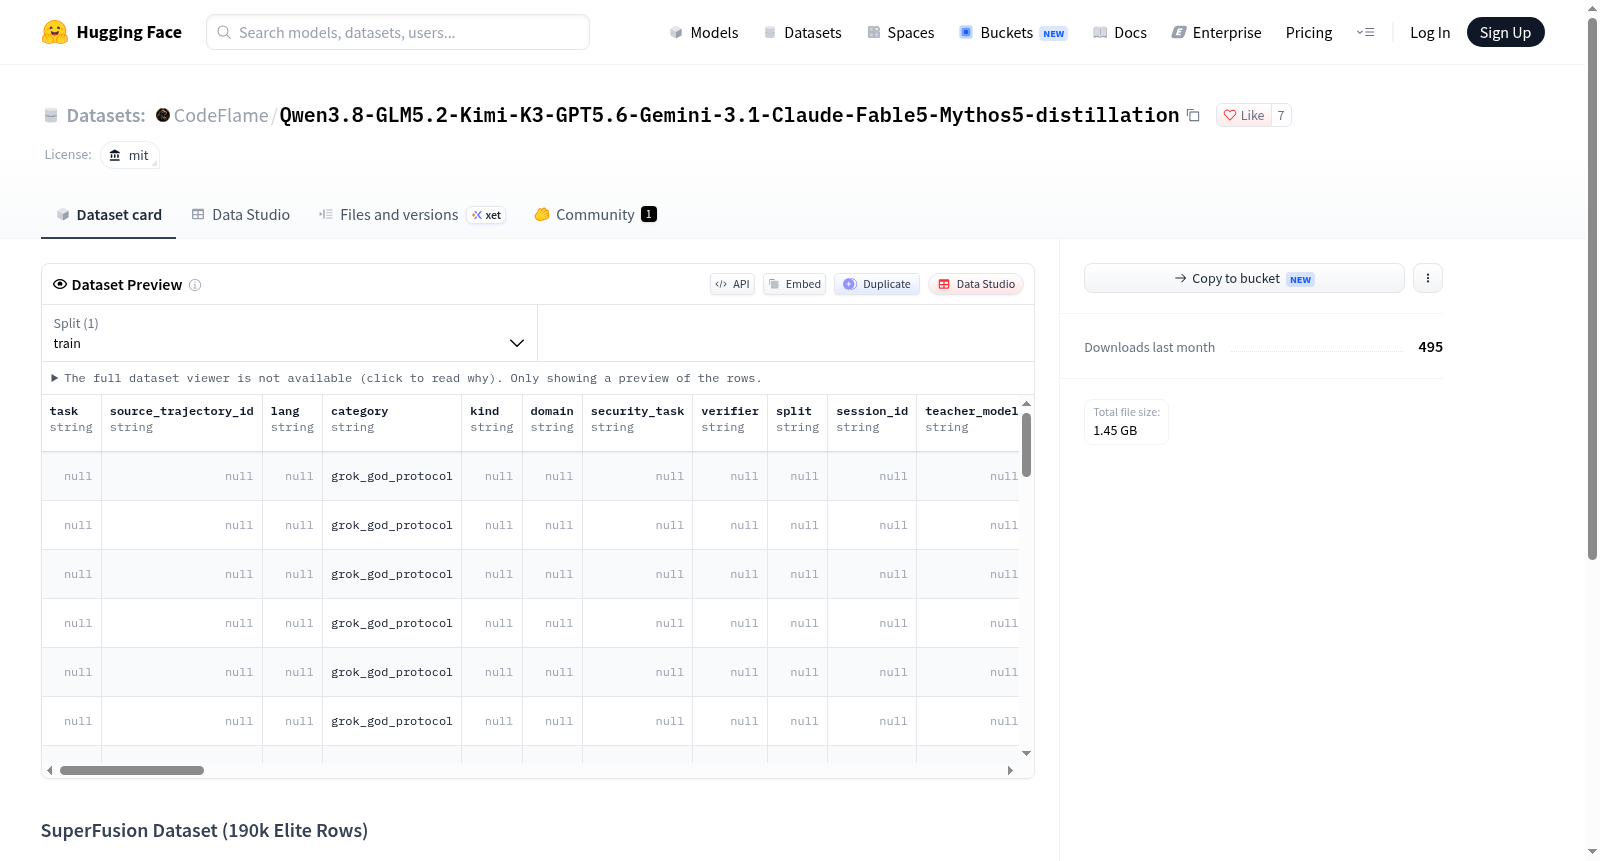
Qwen3.8-GLM5.2-Kimi-K3-GPT5.6-Gemini-3.1-Claude-Fable5-Mythos5-distillation
收藏资源简介:
SuperFusion 数据集是一个经过精心策划的高密度蒸馏融合数据集,包含 190,000 条精选样本。该数据集融合了来自多个前沿大语言模型(包括 Qwen 3.8 Max、GLM 5.2、Kimi K3、GPT 5.6、Gemini 3.1 Pro、Claude、Fable、Mythos、Grok 4.4 等)的优质轨迹,并通过深度过滤确保数据具有深度和实质内容,从而为微调和训练提供一流性能。数据集的字段非常丰富,涵盖了任务类型(task)、语言(lang)、类别(category)、领域(domain)、安全任务(security_task)、验证器(verifier)、数据分割(split)、会话 ID(session_id)、教师模型(teacher_model)、推理努力程度(reasoning_effort)、轨迹格式(trace_format)、使用的工具(tools_used)、轨迹部分(trace_part)、连续性(continuation)、衍生来源(derivation)、助手步骤(assistant_step)、消息内容(messages_json)、工具配置(tools_json)、地面真相(ground_truth_json)、去重集群 ID(dedup_cluster_id)、验证标志(verifier_passed)、格式分数(format_score_raw)、质量标志(quality_flags)、采样权重(sampling_weight)、助手回合数(n_assistant_turns)、工具调用次数(n_tool_calls)、难度(difficulty)、指令(instruction)、输入(input)、输出(output)以及标签(tags)等。该数据集适用于多轮对话、工具调用、推理轨迹学习、指令微调、模型对齐等多种任务,尤其适合需要高质量、多样化训练数据的研究和开发场景。
The SuperFusion dataset is a carefully curated high-density distillation fusion dataset containing 190,000 selected samples. It integrates high-quality trajectories from multiple cutting-edge large language models (including Qwen 3.8 Max, GLM 5.2, Kimi K3, GPT 5.6, Gemini 3.1 Pro, Claude, Fable, Mythos, Grok 4.4, etc.) and undergoes deep filtering to ensure data depth and substance, thereby providing top-tier performance for fine-tuning and training. The dataset features rich fields covering task type, language, category, domain, security task, verifier, split, session ID, teacher model, reasoning effort, trace format, tools used, trace part, continuation, derivation, assistant step, messages JSON, tools JSON, ground truth JSON, dedup cluster ID, verifier passed, format score raw, quality flags, sampling weight, number of assistant turns, number of tool calls, difficulty, instruction, input, output, and tags. This dataset is suitable for various tasks such as multi-turn dialogue, tool calling, reasoning trajectory learning, instruction fine-tuning, and model alignment, especially for research and development scenarios requiring high-quality and diverse training data.
数据集概述
SuperFusion Dataset (190k Elite Rows) 是一个经过精心策划的高密度知识蒸馏融合数据集,旨在为模型微调和训练提供顶级质量的数据支持。
数据来源
数据集融合了多个先进模型的精英轨迹数据,包括:
- Qwen 3.8 Max
- GLM 5.2 与 Kimi K3
- GPT 5.6(包含50k行数据)
- Gemini 3.1 Pro
- Claude
- Fable
- Mythos
- Grok 4.4
数据规模与特色
- 总数据量约为 190,000 行。
- 经过深度和实质内容的筛选,确保数据的高质量和高密度,专为追求顶尖性能的微调与训练任务设计。
数据文件与配置
- 数据集包含一个默认配置(
default),对应单个训练分割(train),数据存储于superfusion_master_dataset_downloaded.jsonl文件中。
数据特征
数据集包含丰富的特征字段,主要涵盖以下几类:
- 任务与内容标识:
task(任务类型)、task_type、category(类别)、domain(领域)、subdomain(子领域)、instruction(指令)、input(输入)、output(输出)、tags(标签)等。 - 数据来源与溯源:
source(来源)、source_repository、source_revision、source_license、source_split、source_item_id、source_record_hash、teacher_model(教师模型)、teacher_provider(教师提供方)。 - 轨迹与消息结构:
session_id(会话ID)、trace_format、trace_part、trace_parts、continuation(是否延续)、derivation、assistant_step、assistant_steps、target_message_index、original_n_messages、n_messages、parent_id、id、messages_json(消息JSON)、n_assistant_turns(助手轮次)、n_tool_calls(工具调用次数)。 - 工具使用:
tools_used(使用的工具列表)、tools、tools_json。 - 质量与验证:
verifier(验证器)、verifier_passed(验证是否通过)、family_oracle_passed、reference_agreement、format_score_raw(格式原始分数)、quality_flags(质量标志)、sampling_weight(采样权重)、disposition。 - 聚类与去重:
prompt_cluster_id、template_cluster_id、dedup_cluster_id。 - 其他元数据:
lang(语言)、kind、trace_kind、security_task(安全任务)、reasoning_effort(推理努力程度)、difficulty(难度)、schema_version(模式版本)。
应用场景
该数据集特别适用于需要高质量对话数据、多任务指令微调、复杂推理轨迹学习以及工具调用场景的大语言模型训练与优化。