
lojban-master
收藏官方服务:
资源简介:
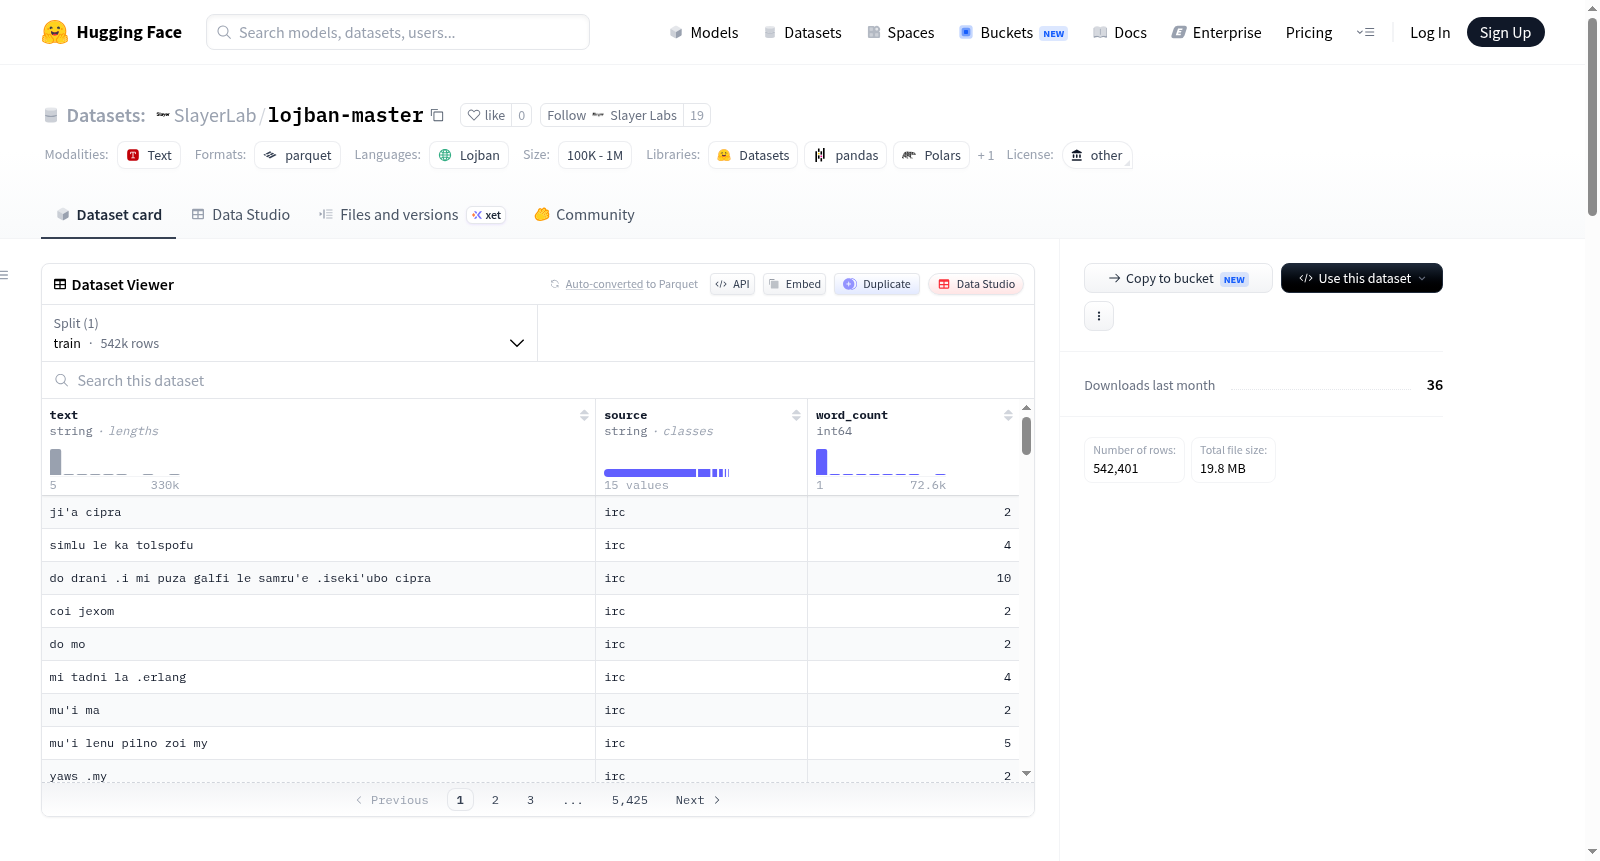
Lojban Master Corpus是目前最大的公开可用的Lojban语言数据集,由15个不同来源编译而成并经过去重处理。该数据集包含542,401个句子,7,874,164个单词,超过3,790万字符。数据来源多样,包括IRC聊天日志(占71.3%)、Lojban维基百科(10.8%)、MMLU翻译(5.1%)、英语-罗真语对(4.3%)、Tatoeba句子对(2.4%)等。数据集以Parquet格式提供,包含三个字段:text(罗真语文本)、source(来源标识符)和word_count(单词数)。所有数据都经过清理,去除了代码污染、英语文本泄漏、Markdown标题、URL、MediaWiki元数据以及空行和短行(少于5字符)。需要注意的是,该数据集没有统一的许可证,每个来源的权利和归属要求各不相同,使用者需逐源确认适用权利后方可重新分发或用于商业模型训练。该数据集适用于Lojban语言的自然语言处理任务,如语言建模、机器翻译等。
创建时间:
2026-07-20
原始信息汇总
数据集概述
数据集名称:Lojban Master Corpus
语言:逻辑语(jbo)
许可证:其他(待定,需逐源核查权利)
大小:542,401 条句子,7,874,164 个词,超过 37,900,000 个字符,大小类别为 100K<n<1M
数据构成
- 来源数量:15 个来源,已去重(基于哈希精确匹配)
- 主要来源分布:
- irc(IRC 聊天记录):386,556 行(71.3%)
- jbowiki(jbo.wikipedia.org):58,751 行(10.8%)
- mmlu_lojban(MMLU 翻译):27,696 行(5.1%)
- damfle_pairs_jbo(英-逻辑语对,仅逻辑语):23,551 行(4.3%)
- tatoeba(Tatoeba 句子对):13,266 行(2.4%)
- jbowiktionary:11,179 行(2.1%)
- muplis(词汇):8,154 行(1.5%)
- mw_texts(MediaWiki 提取):5,077 行(0.9%)
- damfle/lojban(HuggingFace):2,378 行(0.4%)
- bible(圣经翻译):1,605 行(0.3%)
- cll(完整逻辑语语言):1,413 行(0.3%)
- secretive_wiki(wiki 转储):1,364 行(0.3%)
- jbo_jbo(逻辑语-逻辑语词典):779 行(0.1%)
- damfle_ours(提取):628 行(0.1%)
- literary(文学翻译):4 行(0.0%)
数据格式
- 文件格式:Parquet
- 列字段:
text(字符串):逻辑语文档内容source(字符串):来源标识符word_count(int32):文本中的词数
数据清洗
所有来源均经以下清洗:
- 移除代码污染(MediaWiki Scribunto 模块中的 Lua/JS 代码)
- 移除双语对中的英语文本泄漏
- 移除 Markdown 标题和 URL
- 移除 MediaWiki 元数据
- 移除空行和短行(少于 5 个字符)
与其他公开逻辑语数据集对比
| 数据集 | 行数 | 词数 |
|---|---|---|
| lojban-master(本数据集) | 542,401 | 7,874,164 |
| damfle/lojban | 2,443 | 1,488,965 |
| damfle/english-lojban-pairs | 25,634 | 899,661 |
| SecretiveShell/lojban-wikipedia-dump | 1,399 | 494,597 |
| tinycrops/mmlu-lojban | 14,042 | 461,218 |
许可证状态
- 当前状态:无单一覆盖许可证,权利仍按来源特定
- 注意事项:
license: other作为警告,不是总括许可。在完成逐源权利和归属表之前,请勿重新分发合并后的数据集或用于商业模型训练。联系方式:k.wikiel@gmail.com
搜集汇总
数据集介绍
构建方式
Lojban Master Corpus作为目前公开可获取的最大规模逻辑语数据集,其构建过程体现了严谨的语料整合思路。研究团队从IRC聊天日志、维基百科、Tatoeba平行语料库、圣经译本、语言学文献等15个不同来源收集原始数据,涵盖了对话、百科、翻译、词典等多种语言使用场景。在汇集之后,采用基于哈希的精确匹配去重技术消除冗余,最终形成包含542,401个句子的高质量语料集合。
特点
该数据集具有鲜明的多源异构特性与规模优势。来源构成以IRC聊天日志为主,占比达71.3%,充分反映了逻辑语在自然交流中的真实面貌。其余来源包括jbowiki百科、MMLU翻译测试题、双语平行句对、词典条目等,形成了从口语到书面语、从基础词汇到复杂文本的完整覆盖。总计787万词、超过3790万字符的数据量,使其在逻辑语料库中具有绝对领先地位。
使用方法
数据集以Parquet格式存储,包含text(逻辑语文本)、source(来源标识)、word_count(词数)三个字段,便于基于Pandas或PyArrow进行高效读取与处理。研究者可根据source字段筛选特定子集进行训练或评估,如使用双语平行句对训练机器翻译模型,或利用MMLU片段测试语言模型的逻辑语理解能力。建议在使用前关注各来源的授权状态,避免未经许可的商用训练或再分发。
背景与挑战
背景概述
Lojban Master Corpus是由研究者Kamil Wikiel主导构建的、迄今规模最大的公开逻辑语(Lojban)语料库,创建于2024年。该数据集整合了IRC聊天记录、维基百科、圣经译本、语言学教材等15个异构来源,经过去重与清洗后包含逾54万条句子、近790万词,覆盖了从口语对话到学术文献的多元语言场景。作为一门基于谓词逻辑的人造语言,Lojban在自然语言处理领域的研究长期受限于数据匮乏,该语料库的发布为低资源人造语言的机器翻译、语义解析及语言模型预训练提供了关键基础,填补了该领域系统性数据资源的空白,对探索逻辑形式化与自然语言交互的融合具有里程碑意义。
当前挑战
该数据集面临的核心挑战集中于权利合规与数据质量两个维度。在领域问题层面,Lojban作为人造语言缺乏原生社区的大规模真实语料,现有来源多依赖技术文档与翻译文本,如何从有限数据中捕捉逻辑语言的语义完整性与语法规则一致性仍是瓶颈。构建过程中,尤为突出的是版权归属的模糊性——语料整合了14个协议各异的来源,部分数据如Tatoeba与MediaWiki虽常被视为公共领域,但缺乏逐源逐行的权利映射,导致不可直接用于商业模型训练或公开再分发。此外,去重依赖精确哈希匹配,无法处理语义重复或跨源变异,而清洗策略对Lua代码、Markdown等非语言残留的过滤进一步压缩了有效语料规模,需要在数据量与纯净度间艰难权衡。
常用场景
经典使用场景
Lojban-Master语料库汇聚了来自IRC聊天记录、维基百科、Tatoeba句子对、圣经译本及《完全逻辑语》等15个异质来源的逾54万句逻辑语文本,经过去重与清洗后形成当前规模最大的公开逻辑语数据集。其经典使用场景集中于逻辑语的神经机器翻译模型训练、低资源语言的自然语言处理基准测试,以及基于人工语言的语言学理论验证。研究人员可利用该语料库训练序列到序列模型,探索逻辑语高度规则化语法对翻译质量的提升效应,或将其作为跨语言迁移学习的独特桥梁资源。
衍生相关工作
围绕Lojban-Master语料库已衍生出一系列标志性工作,包括基于该数据训练的Lojban-English翻译模型、逻辑语维基百科词条自动提取工具,以及多个公开的Lojban子数据集(如damfle/lojban、tinycrops/mmlu-lojban)。这些衍生资源进一步催生了逻辑语的词嵌入表征学习实验、跨句子结构对齐的对比语言学研究,以及面向逻辑语的MMLU基准测试翻译版本,为人工语言的自然语言处理研究构建了完整的工具链与评估生态。
数据集最近研究
最新研究方向
当前,lojban-master数据集作为迄今规模最大的逻辑语语料库,汇聚了来自15个异构来源的逾54万句文本,为人工语言计算语言学开辟了崭新的实验场域。该数据集不仅支撑着基于逻辑语的低资源神经机器翻译研究,更激活了高度结构化语言与深度学习模型间的抽象表征探索,其多样化的语域——从IRC实时对话到《圣经》译本与维基百科条目——为研究非自然语言在预训练范式下的泛化边界提供了无可替代的基准。随着MMLU基准测试的逻辑语转译版本被纳入语料范畴,这一资源正悄然推动多语言知识蒸馏与跨语言对齐的前沿热点,其对于揭秘语言通用性与人工合成语义空间的深层互动具有奠基性意义。
以上内容由遇见数据集搜集并总结生成


