
MiaoMiaoYang/OpenMMlo
收藏官方服务:
资源简介:
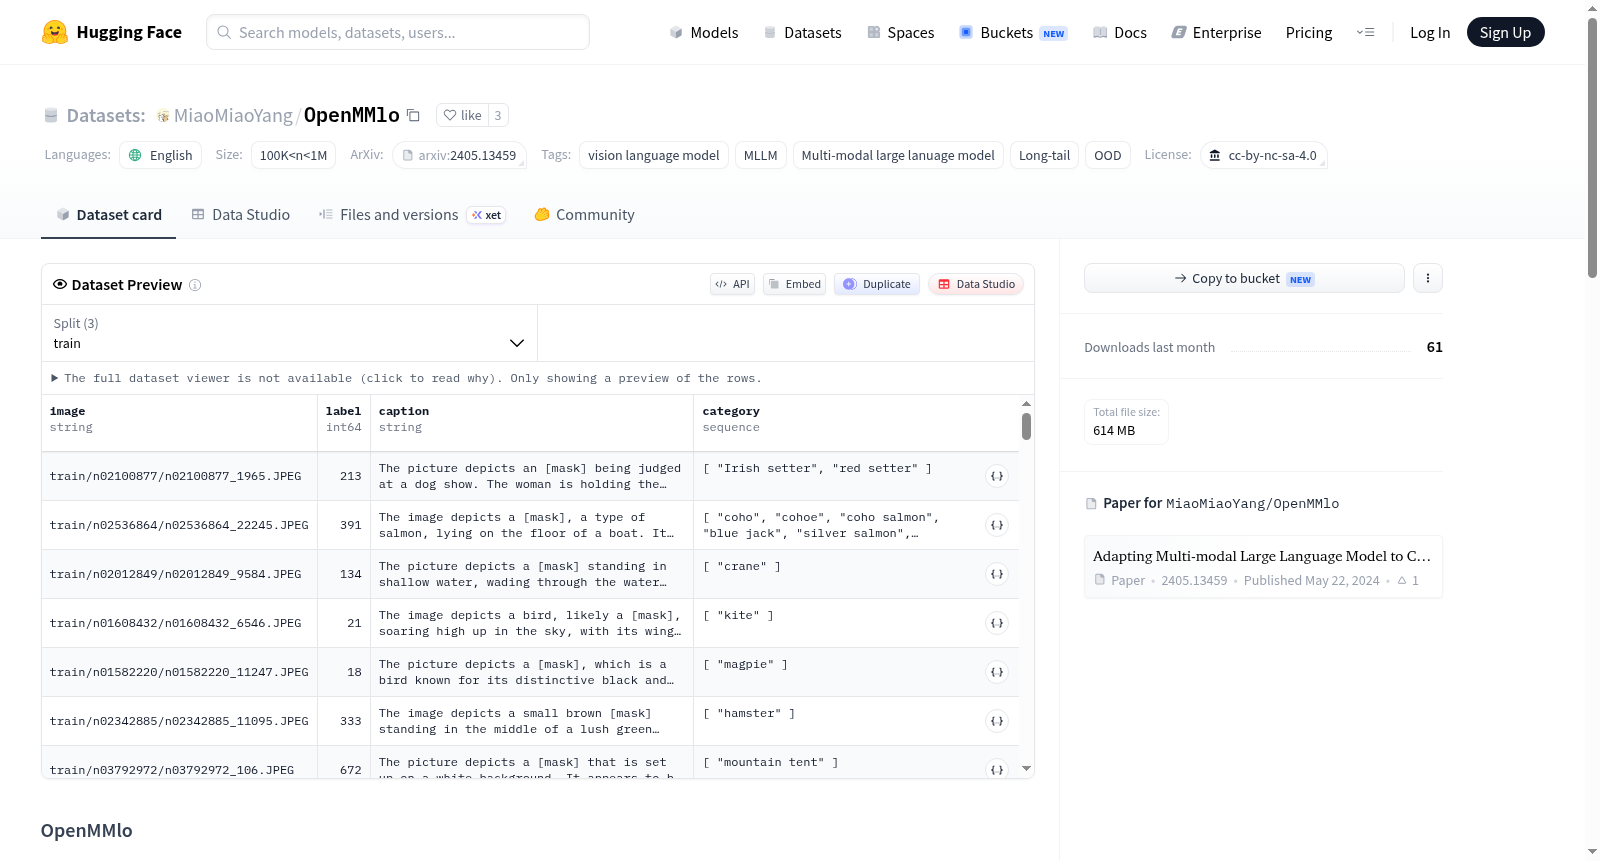
OpenMMlo数据集是为了研究长尾开放世界对多模态大语言模型(MLLMs)的影响而构建的。该数据集通过扩展开源数据集ImageNet-LT、iNaturalist2018和Places-LT来创建。ImageNet-LT包含1,000个类别和115.8k样本,Places-LT包含365个类别和184.5k样本,iNaturalist2018包含8,142个类别和437.5k样本。数据集使用InstructBLIP生成图像的详细描述,提示词为“这张图片描述了什么?请详细描述其大小、位置、颜色及其与周围环境的关系。”
OpenMMlo数据集是为了研究长尾开放世界对多模态大语言模型(MLLMs)的影响而构建的。该数据集通过扩展开源数据集ImageNet-LT、iNaturalist2018和Places-LT来创建。ImageNet-LT包含1,000个类别和115.8k样本,Places-LT包含365个类别和184.5k样本,iNaturalist2018包含8,142个类别和437.5k样本。数据集使用InstructBLIP生成图像的详细描述,提示词为“这张图片描述了什么?请详细描述其大小、位置、颜色及其与周围环境的关系。”
提供机构:
MiaoMiaoYang原始信息汇总
数据集概述
数据集名称
OpenMMlo
数据集目的
研究长尾开放世界对多模态大型语言模型(MLLMs)的影响。
数据集构建
- 来源数据集:
- ImageNet-LT: 包含1,000个类别,共115.8k样本,每个类别样本数从5到1,280不等,还包括18k用于OOD检测的图像。
- iNaturalist 2018: 包含8,142个类别,共437.5k样本。
- Places-LT: 包含365个类别,共184.5K样本,每个类别样本数从5到4,980不等。
- 数据处理: 使用InstructBLIP生成图像的相关描述,描述内容包括大小、位置、颜色及其与周围环境的关系。
数据集特征
- 类别分布: 长尾分布,类别样本数差异大。
- 模态: 多模态,包括视觉和语言信息。
数据集规模
- 样本数量: 100K<n<1M
许可证
- 许可证类型: cc-by-nc-sa-4.0
语言
- 数据集语言: 英语
标签
- 相关标签:
- 视觉语言模型
- MLLM
- 多模态大型语言模型
- 长尾
- OOD
搜集汇总
数据集介绍
构建方式
为探究长尾开放世界对多模态大语言模型(MLLMs)性能的影响,研究者构建了OpenMMlo数据集。该数据集基于三个开源数据集扩展而来:ImageNet-LT涵盖1000个类别共115.8k样本,每类样本量从5到1280不等,并包含18k张用于分布外检测的图像;Places-LT包含365个类别的184.5k样本,每类样本量介于5至4980之间;iNaturalist 2018则是一个大规模自然物种数据集,涵盖8142个类别共437.5k样本。为赋予图像语义描述,研究者采用InstructBLIP模型,以“请详细描述图像的大小、位置、颜色及其与周围环境的关系”为提示生成对应字幕,从而构建出兼具长尾分布与开放世界特性的多模态评测基准。
特点
OpenMMlo数据集的核心特点在于其鲜明的长尾分布与开放世界属性。数据集中各类别样本数量极不均衡,头部类别与尾部类别的样本量相差可达数百倍,真实模拟了现实世界中常见的长尾现象。同时,数据集内嵌了分布外检测样本,能够有效评估模型对未知类别的判别能力。通过融合ImageNet-LT、Places-LT与iNaturalist 2018这三个在类别粒度、场景复杂度和领域跨度上各具特色的子集,OpenMMlo提供了覆盖通用物体、场景与细粒度物种的多层次评测维度,为深入剖析MLLMs在概念漂移与长尾泛化方面的鲁棒性提供了独特的数据支撑。
使用方法
OpenMMlo数据集主要面向多模态大语言模型的鲁棒性评估与微调研究。使用者可将图像及其对应的InstructBLIP生成字幕作为输入,结合模型原有的视觉-语言对齐能力,评测其在长尾类别上的分类、描述与推理表现。数据集中的分布外检测子集可用于测试模型对未知类别的拒绝或自适应能力。研究者可依据论文中的评估协议,将数据集划分为训练集与测试集,并采用标准的交叉熵损失或对比学习目标进行模型训练。此外,该数据集也可作为概念漂移实验的基准,通过对比模型在预训练与微调阶段对不同尾部类别性能的变化,揭示模型适应开放世界动态分布的内在机理。
背景与挑战
背景概述
多模态大语言模型(MLLMs)在视觉与语言融合领域取得了突破性进展,然而其在实际部署中常面临长尾分布与开放世界概念的严峻考验。在此背景下,由Xiaoyu Yang、Jie Lu和En Yu等研究者于2024年构建的OpenMMlo数据集应运而生,旨在系统性探究长尾开放世界对MLLMs性能的影响。该数据集通过整合ImageNet-LT、iNaturalist2018和Places-LT等开源资源,覆盖了从5到1280个样本不等的类别分布,并额外包含18,000张用于分布外检测的图像。其核心研究问题聚焦于多模态模型在概念漂移与长尾场景下的适应能力,为后续研究如ICLR 2025上发表的《Adapting Multi-modal Large Language Model to Concept Drift From Pre-training Onwards》提供了关键基准。OpenMMlo的提出不仅填补了多模态长尾评估的空白,更推动了领域对模型鲁棒性与泛化性的深入思考。
当前挑战
OpenMMlo所应对的领域挑战主要源于多模态模型在真实开放世界中的脆弱性:类别分布极度不均衡导致模型对尾部样本的识别准确率骤降,而分布外样本的涌现则进一步加剧了预测的不确定性。在构建过程中,研究者面临数据整合与标注质量的双重难题——如何从ImageNet-LT、iNaturalist2018和Places-LT等异构数据源中提取一致的长尾结构,并确保类别间的语义连续性。此外,为生成高质量图像描述,团队采用InstructBLIP模型进行自动化标注,但需精心设计提示模板以捕捉尺寸、位置、颜色等细粒度信息,同时规避语言偏差对下游分析的影响。这些挑战共同塑造了OpenMMlo作为多模态长尾研究试验田的独特价值。
常用场景
经典使用场景
OpenMMlo数据集专为探究多模态大语言模型(MLLMs)在长尾开放世界中的表现而构建。其经典使用场景聚焦于评估和提升模型在类别分布极端不均衡(如ImageNet-LT中类别样本量从5到1280不等)且存在分布外(OOD)样本环境下的鲁棒性与泛化能力。通过整合ImageNet-LT、iNaturalist2018和Places-LT三个开源数据集,研究者可系统性地分析MLLMs在面对长尾分布与开放世界概念漂移时的视觉-语言对齐与推理退化现象,从而推动模型对罕见类别和陌生场景的适应机制研究。
实际应用
在实际应用中,OpenMMlo为需要高可靠性的多模态感知系统提供了关键测试床。例如,在野生动物监测中,模型需识别大量罕见物种(对应iNaturalist2018的尾部类别),并区分未知的入侵物种(OOD样本);在自动驾驶场景中,模型必须处理长尾出现的交通标志与突发障碍物。该数据集通过模拟这些真实世界的极端不平衡与未知类别出现情况,帮助工程师检验和优化模型在工业质检、医疗影像诊断、智能安防等领域的部署效果,确保其在数据稀缺或新类涌现时仍能维持稳定的决策质量。
衍生相关工作
基于OpenMMlo,相关研究已催生了一系列经典工作。核心代表是Yang等人(2025)在ICLR上发表的《Adapting Multi-modal Large Language Model to Concept Drift From Pre-training Onwards》,该工作利用本数据集揭示了预训练阶段引入的概念漂移如何影响MLLMs在下游长尾任务中的表现,并提出了适应性微调框架。此外,该数据集常被用于对比不同视觉编码器(如CLIP、EVA-CLIP)与语言解码器组合在长尾OOD场景下的鲁棒性,以及验证提示工程(如InstructBLIP生成描述时的指令设计)对模型注意力偏差的校正效果,推动了多模态领域内关于数据分布鲁棒性与持续学习范式的深入探讨。
以上内容由遇见数据集搜集并总结生成


