NITHUB-AI/Ehn-bible
收藏资源简介:
Ehn-Bible-BBC-GPT3.5数据集包含尼日利亚皮钦语和英语的平行句子,分为训练集、验证集和测试集,比例为8:1:1。数据来源于圣经,使用现代英语翻译版本。数据集支持语言翻译和语言识别任务。数据集的创建过程包括数据抓取、存储和分割。数据集的局限性在于主要来源于宗教文本,且不包含其他版本的皮钦语。
The Ehn-Bible-BBC-GPT3.5 dataset consists of parallel sentence pairs between Nigerian Pidgin and English, and is split into training, validation and test sets at a ratio of 8:1:1. The data is sourced from the Bible, leveraging modern English translation versions. This dataset supports language translation and language identification tasks. The dataset creation workflow includes data crawling, storage and splitting. The limitations of this dataset are that it is primarily derived from religious texts, and does not cover other variants of Pidgin.
数据集卡片 Ehn-Bible-BBC-GPT3.5
数据集描述
数据集摘要
该数据集包含尼日利亚皮金语和英语的平行句子,分为三个文件:train.csv、valid.csv 和 test.csv。原始数据按 8:1:1 的比例分割成这些文件。
支持的任务和排行榜
- 语言翻译
- 语言识别
语言
- 英语
- 尼日利亚皮金语
数据集结构
数据实例
| 英语 | 皮金 |
|---|---|
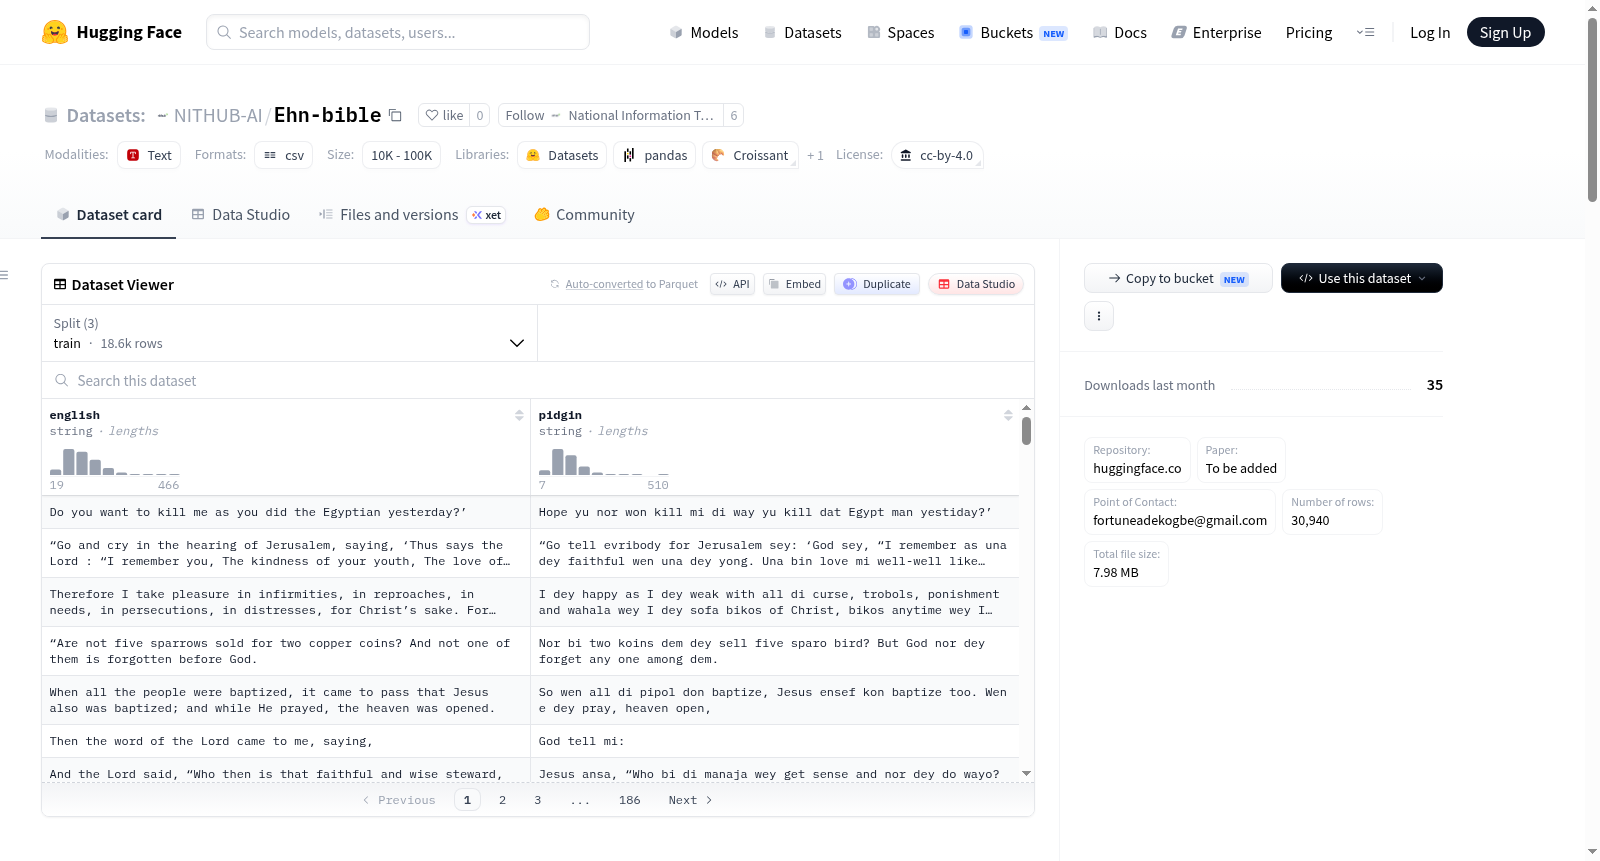
| " Do you want to kill me as you did the Egyptian yesterday?’ " | " Hope yu nor won kill mi di way yu kill dat Egypt man yestiday?’ " |
| " “Go and cry in the hearing of Jerusalem, saying, ‘Thus says the Lord : “I remember you, The kindness of your youth, The love of your betrothal, When you went after Me in the wilderness, In a land not sown." | " “Go tell evribody for Jerusalem sey: ‘God sey, “I remember as una dey faithful wen una dey yong. Una bin love mi well-well like woman wey just marry; una follow mi waka for wildaness and for dry land. " |
| " Therefore I take pleasure in infirmities, in reproaches, in needs, in persecutions, in distresses, for Christ’s sake. For when I am weak, then I am strong." | " I dey happy as I dey weak with all di curse, trobols, ponishment and wahala wey I dey sofa bikos of Christ, bikos anytime wey I dey weak, na dat time, I dey-dey strong. " |
数据字段
- English: 包含英语句子
- Pidgin: 包含对应的尼日利亚皮金语句子
数据分割
- 训练集 (60%)
- 验证集 (20%)
- 测试集 (20%)
数据集创建
数据集创建理由
数据从圣经的上下文中筛选出来,这是最大的英语-尼日利亚皮金语平行句子的可用来源。英语句子使用了圣经的《The Message》翻译版本,因为它呈现了最现代的英语形式。
源数据
初始数据收集和规范化
- 数据使用Python中的BeautifulSoup进行抓取并存储在MongoDB数据库中
- 圣经来源的数据按章节分割成样本,因为这是保留平行句子之间上下文的最简单方法。主要是因为英语和尼日利亚皮金语的句子不是完美匹配的。
源语言生产者
个人和敏感信息
除了圣经中已有的信息外,没有额外努力去除敏感信息。
使用数据集的考虑因素
数据集的社会影响
该数据使得工程师更容易构建适用于不太识字但数字连接的尼日利亚受众的语言工具。
偏见讨论
数据主要集中在现代英语的圣经文本上。这限制了数据的多样性和基于其构建的系统的灵活性。
其他已知限制
- 数据不包含其他版本的皮金语,如Warri皮金语或其他非洲国家的皮金语。
- 数据包含有限数量的上下文,主要来自宗教角度。