
wikipedia-RuDataset
收藏官方服务:
资源简介:
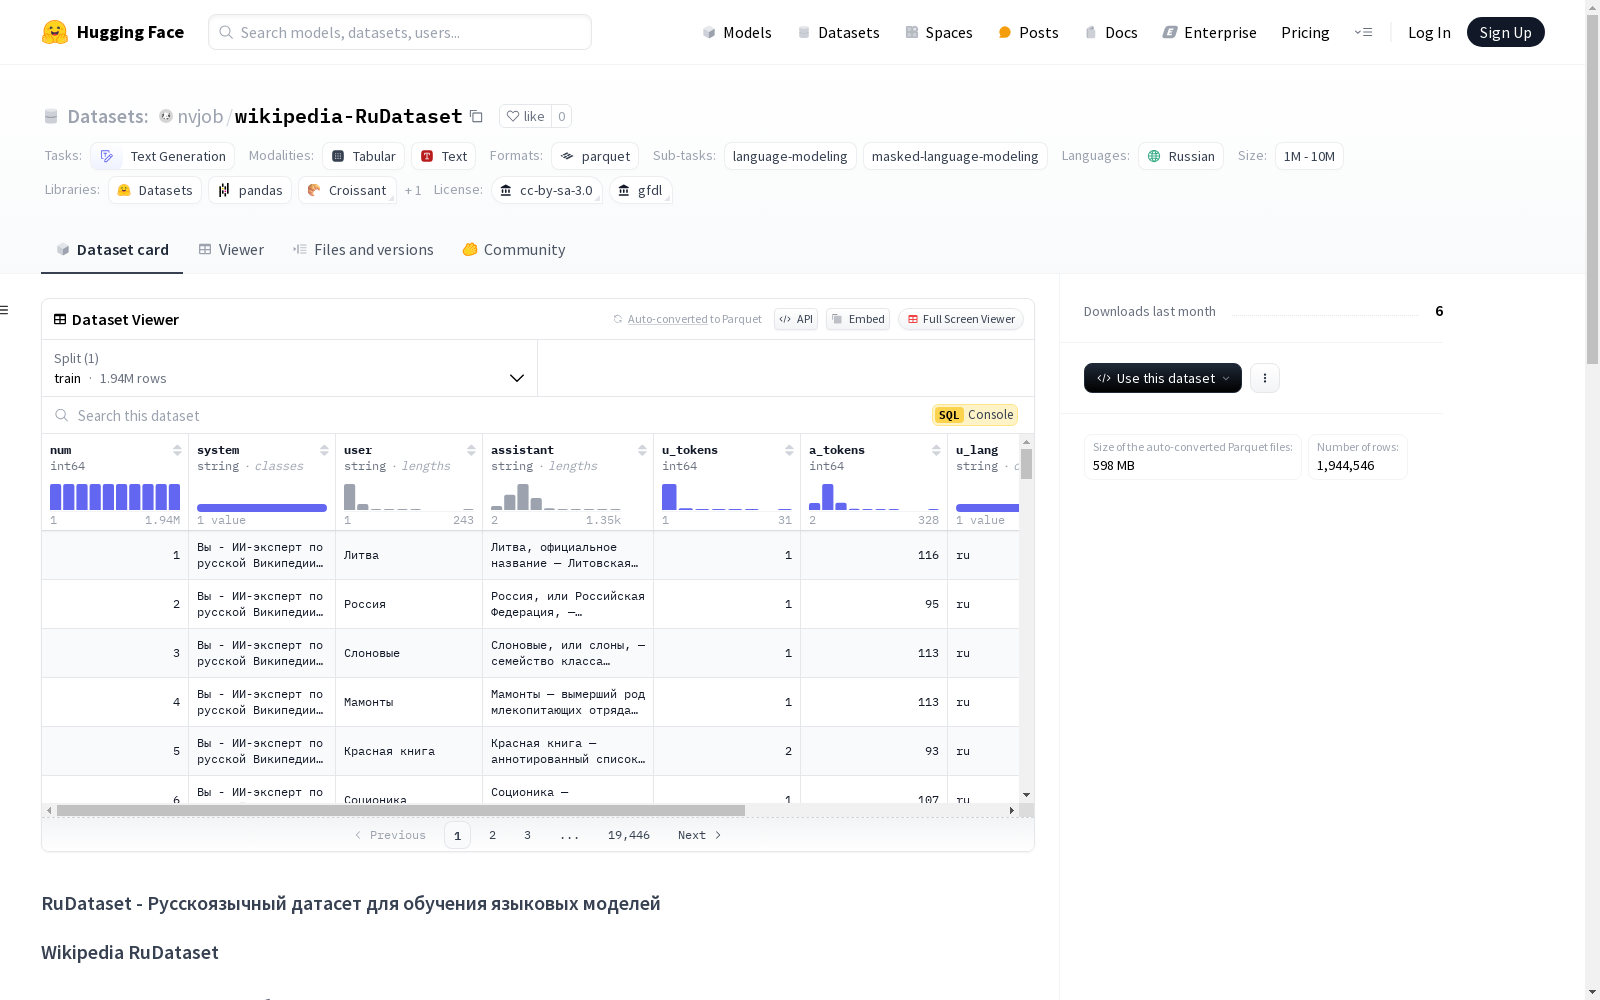
RuDataset是一个用于训练语言模型的俄语数据集,特别适用于聊天格式的训练。该数据集包含了从维基百科中提取的文章,这些文章已经过清理和格式化,去除了元数据和特殊字符,并进行了文本规范化处理。数据集以Parquet格式存储,使用Snappy压缩和UTF-8编码。它适用于LLM训练、fine-tuning、创建embeddings和模型测试。
RuDataset is a Russian-language dataset tailored for language model training, with particular suitability for chat-format training. This dataset comprises articles extracted from Wikipedia, which have been cleaned, formatted, stripped of metadata and special characters, and subjected to text normalization. The dataset is stored in Parquet format, utilizing Snappy compression and UTF-8 encoding. It is applicable for LLM training, fine-tuning, embedding creation, and model testing.
创建时间:
2025-01-22
搜集汇总
数据集介绍
构建方式
Wikipedia RuDataset的构建基于Wikimedia/Wikipedia提供的俄语数据集,专为训练大型语言模型(LLM)而设计。数据集经过精心处理,移除了文章中的元数据和服务信息,并重新格式化以适应LLM的训练需求。数据以Parquet格式存储,采用Snappy压缩和UTF-8编码,确保了数据的高效存储和快速访问。
特点
该数据集的特点在于其专注于俄语文本,涵盖了广泛的维基百科文章内容。每篇文章都经过严格的文本处理流程,包括去除BOM和特殊字符、规范化西里尔字母、删除重复空格和标点符号等。数据集的结构清晰,包含用户查询、系统提示、助手回复等字段,并记录了每个字段的token数量和语言信息,便于模型训练和评估。
使用方法
Wikipedia RuDataset适用于多种自然语言处理任务,包括语言模型的训练、微调、嵌入生成以及模型测试。用户可以通过加载Parquet文件直接访问数据,并根据需要提取特定字段进行模型训练。数据集的格式化和预处理使其能够无缝集成到现有的机器学习管道中,为俄语语言模型的研究和开发提供了坚实的基础。
背景与挑战
背景概述
Wikipedia-RuDataset是由Wikimedia/Wikipedia提供的俄语数据集,专门用于训练大型语言模型(LLM)。该数据集创建于近年来,主要研究人员包括尼古拉·维谢洛夫(Nikolay Veselov)等,旨在为俄语自然语言处理(NLP)领域提供高质量的文本资源。数据集的核心研究问题在于如何有效利用维基百科的丰富内容,构建适用于语言模型训练的格式化文本。通过对维基百科文章进行清洗、格式化和结构化处理,该数据集为俄语语言模型的训练和微调提供了重要支持,推动了俄语NLP领域的发展。
当前挑战
Wikipedia-RuDataset在构建过程中面临多重挑战。首先,维基百科文章包含大量元数据和辅助信息,如何有效去除这些冗余内容并保留核心文本信息是一个关键问题。其次,俄语文本的复杂性,如特殊字符、标点符号和变音符号的处理,增加了数据清洗的难度。此外,数据集需要确保文本格式的统一性和一致性,以便于模型训练。在应用层面,该数据集旨在解决俄语语言模型的训练和微调问题,但由于俄语语法和词汇的复杂性,模型在处理长文本、多义词和上下文依赖时仍面临挑战。这些挑战不仅体现在数据构建过程中,也影响了模型在实际应用中的表现。
常用场景
经典使用场景
在自然语言处理领域,wikipedia-RuDataset数据集被广泛应用于训练和微调俄语语言模型。其结构化的数据格式和经过精心处理的文本内容,使得该数据集成为研究俄语语言理解和生成的理想选择。特别是在语言模型的预训练阶段,该数据集提供了丰富的俄语语料,帮助模型更好地捕捉俄语的语法和语义特征。
实际应用
在实际应用中,wikipedia-RuDataset数据集被广泛用于开发俄语聊天机器人、智能助手和机器翻译系统。其高质量的文本内容和多样化的语言表达方式,使得基于该数据集训练的模型能够更好地理解和生成自然语言,从而提升用户体验。此外,该数据集还被用于俄语文本分类、情感分析和信息抽取等任务,为俄语信息处理技术的发展提供了重要支持。
衍生相关工作
基于wikipedia-RuDataset数据集,研究人员已经开发了多个经典的俄语语言模型和相关应用。例如,该数据集被用于训练和微调BERT、GPT等预训练模型,显著提升了这些模型在俄语任务上的表现。此外,该数据集还催生了一系列俄语自然语言处理工具和框架,如俄语文本生成器和俄语问答系统,推动了俄语NLP领域的技术进步和应用创新。
以上内容由遇见数据集搜集并总结生成


