
runanlab/gpt-5.4-frontend-development-27052026
收藏官方服务:
资源简介:
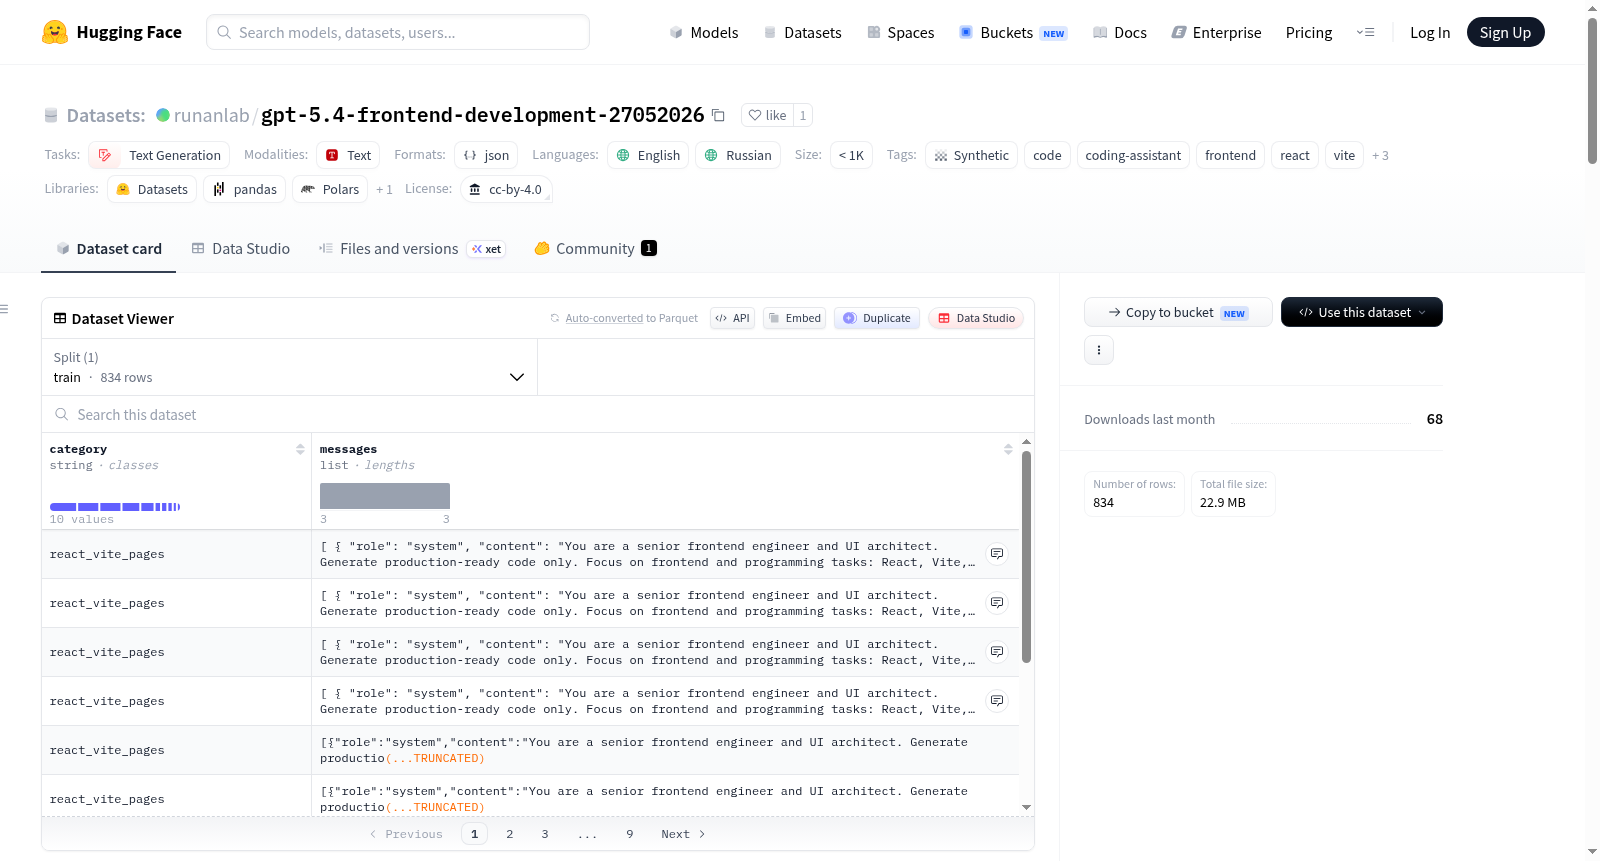
Site Coding Dataset是一个合成的聊天格式数据集,专为代码生成设计,专注于前端开发、UI实现和指令遵循编程任务。该数据集包含834条JSONL格式的记录,每条记录包括类别标签和消息(包含系统、用户和助手角色的聊天式对话)。数据集基于用户编写的提示和GPT-5.4生成的响应构建,适用于训练、评估和实验编码助手系统,特别是在Web开发和前端重工作流场景中。
Site Coding Dataset is a synthetic chat-formatted dataset for code generation, focused on frontend development, UI implementation, and instruction-following programming tasks. The dataset contains 834 records in JSONL format, each including a category label and messages with system, user, and assistant roles in a chat-style conversation. It was built from user-authored prompts and GPT-5.4-generated responses, and is intended for training, evaluation, and experimentation with coding assistants, especially in web development and frontend-heavy workflows.
提供机构:
runanlab搜集汇总
数据集介绍
构建方式
该数据集以用户自主撰写的提示词为基石,借助GPT-5.4模型生成高质量响应,从而构建合成式对话语料。每条记录遵循JSONL格式,包含任务类别标签与三段式对话结构(系统指令、用户请求、助手回复),聚焦于前端开发与UI实现场景。数据集共收录834条样本,确保了在代码生成领域进行监督微调与指令跟随实验的原始素材积累。
特点
数据集以React、Vite、TypeScript等现代前端技术栈为核心,覆盖页面构建、仪表盘、表单及UI组件等丰富任务类型。其合成性质允许快速扩展与迭代,但也伴随手动修复、重复模式及虚构API等局限性。采用CC BY 4.0许可证释放,适用于编码助手训练与评估,尤其擅长处理网页开发与前端密集工作流程。
使用方法
数据集可直接用于监督微调大语言模型,提升代码生成与指令跟随能力。用户可将JSONL文件加载至训练框架,按类别筛选任务或直接利用对话格式。适用于前端助手评估、提示响应对齐研究及多轮交互实验。需注意合成数据可能包含不完整代码,建议结合手动验证与领域专家审查以增强生产适用性。
背景与挑战
背景概述
该数据集名为Site Coding Dataset,由研究机构runanlab于2026年创建,专注于前端开发与代码生成任务。数据集包含834条基于用户自撰提示与GPT-5.4生成回复的合成对话记录,涵盖React、Vite、TypeScript等现代前端技术栈,旨在为代码生成模型提供指令遵循与UI实现的训练资源。作为面向特定编程领域的高质量合成数据,它弥补了现有代码数据集在前端精细化任务上的不足,为编码助手的研究与评估提供了结构化支撑,尤其在多轮对话式开发场景中具有重要参考价值。
当前挑战
该数据集面临的挑战主要来自两方面:一是所解决的领域问题,即现有代码生成模型在处理前端开发任务时,常因缺乏细粒度指令与UI实现样例而导致输出结果与用户预期偏差较大,数据集通过精心设计的对话格式尝试弥补这一鸿沟。二是构建过程中遇到的挑战,包括其合成属性带来的固有局限,如部分回复需手动修正才能执行、可能存在重复模式或幻象API引用,以及框架覆盖不均衡、代码质量与安全性难以保证等问题,要求使用者审慎评估其适用边界。
常用场景
经典使用场景
在自然语言处理与软件工程的交叉领域中,该数据集以其合成对话格式为代码生成任务提供了丰富的训练素材。尤其是在前端开发场景下,数据集聚焦于React、Vite、TypeScript等技术栈,支持构建能够理解用户指令并生成高质量UI组件的智能编程助手。通过包含系统、用户和助手的多轮对话结构,该数据集适用于监督式微调与指令跟随实验,帮助模型学习从模糊的用户需求到精确的前端代码实现的映射能力。
解决学术问题
该数据集有效应对了代码生成领域中面向特定领域的前端代码合成难题。传统代码数据集多聚焦于通用编程或算法实现,而忽略了UI界面构建中的特殊指令理解与组件化生成需求。该数据集通过引入结构化的指令-响应对话,解决了如何将自然语言描述的高层级界面设计意图转化为可执行的React组件代码这一关键学术问题,为探索上下文感知的前端代码生成提供了标准化实验平台。
衍生相关工作
基于该数据集,研究人员和开发者已衍生出若干关键的后续工作。一方面,有工作聚焦于利用该数据集进行代码生成模型的监督式微调,并对比不同基础模型在React组件生成质量上的差异。另一方面,也有研究探索了如何结合多模态输入,将该数据集的对话格式与界面截图或设计稿对齐,拓展出从视觉设计到代码的生成任务。此外,该数据集还被用作基准测试集,评估大型语言模型在前端开发指令跟随与代码安全性方面的表现。
以上内容由遇见数据集搜集并总结生成


