nichevault-afrikaans-asr-sample
收藏资源简介:
NicheVault Afrikaans ASR — Free Sample 是一个包含 20 个音频剪辑的预览数据集,源自一个完整的 61.5 小时 Whisper 就绪南非荷兰语自动语音识别训练数据集。该样本旨在作为完整付费数据集的发现渠道。所有音频剪辑均为 16kHz 单声道 WAV 格式,并附有人工验证的句子级转录本,以 JSON Lines 格式的元数据文件提供。数据来源于 NCHLT 南非荷兰语语音语料库和 FLEURS af_za 数据集,采用纯 CC BY 许可(分别为 CC BY 3.0 和 CC BY 4.0),无 ShareAlike 或 Copyleft 义务。重要提示:数据内容为提示性朗读语音,并非自发或对话式南非荷兰语,源语料库是为声学模型训练设计的脚本化、语音平衡的朗读语音集合。元数据包含文件名、文本、持续时间、来源、许可、语言、分割、采样率和声道等字段。样本剪辑来自完整数据集的训练、验证和测试分割(说话者不相交)。该数据集适用于微调 Whisper 和其他 ASR 模型、针对资源匮乏的南非语言进行声学模型预训练、南非荷兰语语音识别系统的基准测试与评估,以及低资源 ASR 研究。完整的付费数据集包含超过 67,000 个剪辑,来自 1,704 个不同的说话者,并提供了经过精心处理、对齐且便于直接使用的格式。
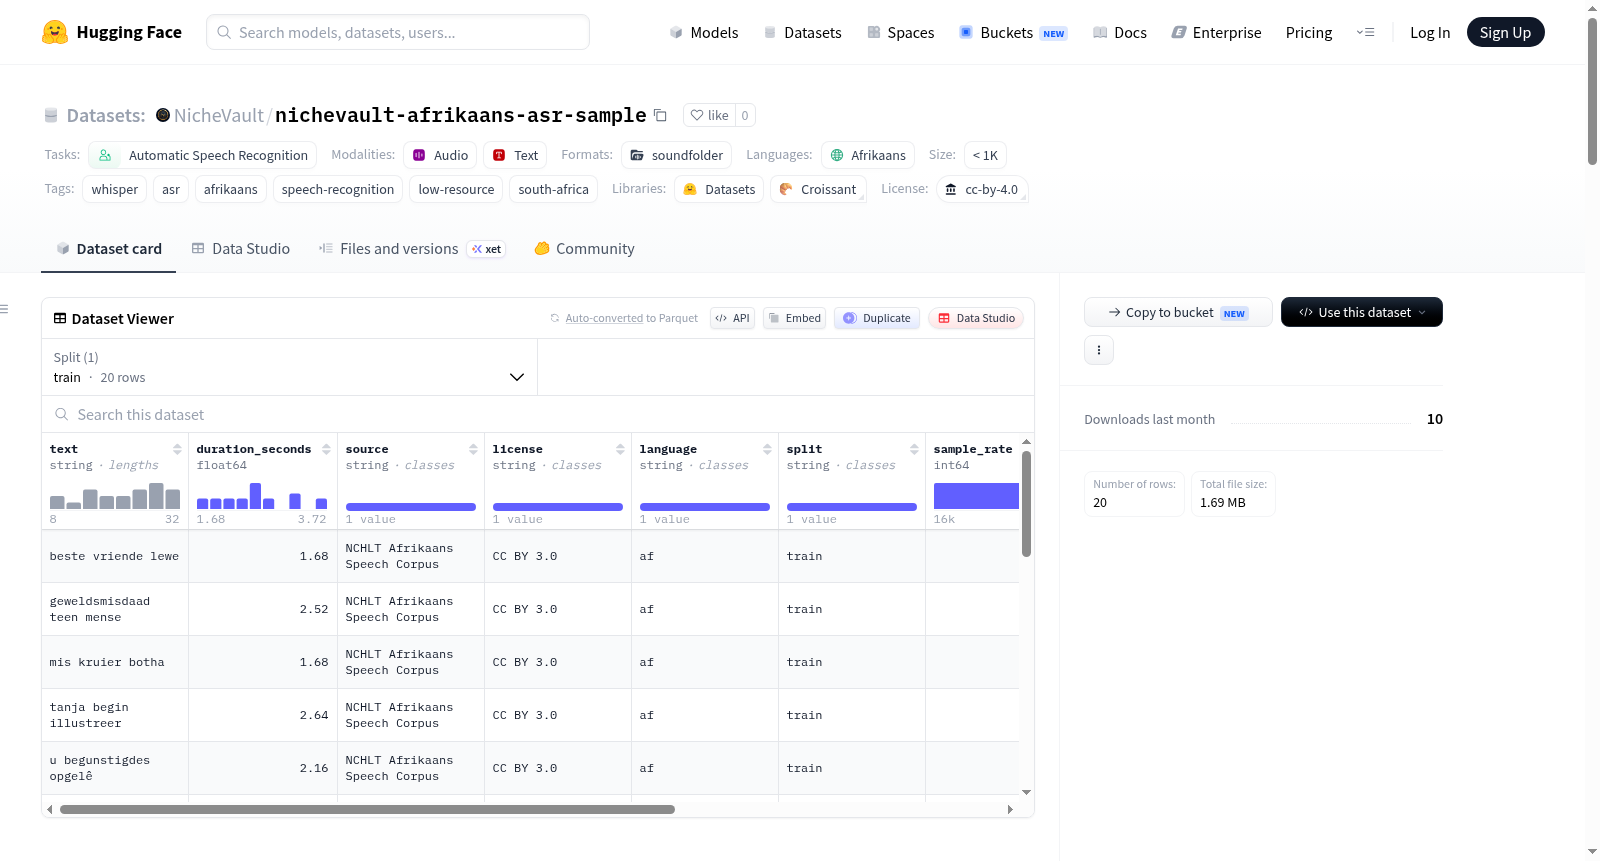
NicheVault Afrikaans ASR — Free Sample is a preview dataset containing 20 audio clips, derived from a full 61.5-hour Whisper-ready Afrikaans automatic speech recognition training dataset. This sample is intended as a discovery channel for the complete paid dataset. All audio clips are in 16kHz mono WAV format and come with human-verified sentence-level transcripts, provided in a metadata file in JSON Lines format. The data is sourced from the NCHLT Afrikaans Speech Corpus and the FLEURS af_za dataset, under pure CC BY licenses (CC BY 3.0 and CC BY 4.0 respectively), with no ShareAlike or Copyleft obligations. Important note: The data content is prompted read speech, not spontaneous or conversational Afrikaans, and the source corpora are scripted, phonetically balanced read speech collections designed for acoustic model training. The metadata includes fields such as filename, text, duration, source, license, language, split, sample rate, and channels. The sample clips are from the training, validation, and test splits of the full dataset (speaker-disjoint). This dataset is suitable for fine-tuning Whisper and other ASR models, acoustic model pre-training for under-resourced South African languages, benchmarking and evaluation of Afrikaans speech recognition systems, and low-resource ASR research. The complete paid dataset contains over 67,000 clips from 1,704 distinct speakers, provided in a well-processed, aligned, and ready-to-use format.
数据集概述:NicheVault 南非荷兰语自动语音识别(ASR)免费样本
基本信息
- 任务: 自动语音识别(ASR)
- 语言: 南非荷兰语(语言代码:
af) - 许可证: CC BY 4.0
- 数据集规模: 少于 1,000 条样本(具体为 20 条音频片段)
数据集内容
- 音频格式: 16kHz 单声道 WAV 文件
- 转录格式:
metadata.jsonl(JSON Lines 格式),包含人工验证的句子级转录 - 数据来源: 来自完整数据集的训练/验证/测试划分(说话人无重叠)
- 样本数量: 20 条音频片段
元数据字段
| 字段 | 描述 |
|---|---|
file_name |
音频文件名(相对于元数据文件) |
text |
南非荷兰语转录文本(句子级) |
duration_seconds |
音频时长(秒) |
source |
来源语料库:NCHLT Afrikaans Speech Corpus 或 FLEURS af_za |
license |
许可证:CC BY 3.0 或 CC BY 4.0 |
language |
语言代码 af |
split |
数据划分:train、validation 或 test |
sample_rate |
采样率:16000 |
channels |
声道数:1 |
数据特点与局限
- 数据性质: 此样本来自脚本化、语音平衡的朗读语音语料库(NCHLT 和 FLEURS),不是对话式南非荷兰语。不具代表性,构建对话式 ASR 的用户需注意此局限。
- 数据来源:
- NCHLT 南非荷兰语语音语料库: 约 56 小时,CC BY 3.0 许可,原始版本需自行处理 XML 解析、转录匹配、采样率转换和划分创建。免费下载地址:
https://repo.sadilar.org/ - FLEURS af_za: CC BY 4.0 许可。HuggingFace 地址:
https://huggingface.co/datasets/google/fleurs
- NCHLT 南非荷兰语语音语料库: 约 56 小时,CC BY 3.0 许可,原始版本需自行处理 XML 解析、转录匹配、采样率转换和划分创建。免费下载地址:
- 稀缺性说明: 可免费获取的南非荷兰语 ASR 数据稀缺。Common Voice 中该语言数据量极少(CV v26 约 34 MB);其他非洲语言项目(如 Swivuriso / Africa Next Voices)不包含南非荷兰语。
预期用途
- 微调 Whisper 及其他 ASR 模型,面向南非荷兰语
- 为资源匮乏的南非语言进行声学模型预训练
- 南非荷兰语语音识别系统的基准测试与评估
- 低资源 ASR 研究
完整数据集信息
- 价格: 99 美元
- 规模: 61.5 小时,共 67,627 条音频片段(66,133 条来自 NCHLT,1,494 条来自 FLEURS)
- 说话人数量: 1,704 位不同的说话人
- 数据划分: 说话人无重叠的训练/验证/测试(90/5/5)
- 处理: 所有音频已转换为 16kHz 单声道 WAV;所有转录已通过 MD5 匹配确保与原始 NCHLT 文件一致,消除空转录问题;移除所有 CC BY-SA 许可的数据(排除了 OpenSLR SLR32 的 2,360 条片段),确保仅含纯 CC BY 许可内容。
- 交付形式: 单次下载的 5 GB 压缩包(ZIP),包含所有音频、元数据、来源归属及说明文档。可立即用于 HuggingFace Dataset 进行训练。
- 购买链接:
https://flevin4.gumroad.com/l/lvjehy
引用信息
若使用该数据集,建议引用原始 NCHLT 和 FLEURS 来源:
bibtex @inproceedings{barnard2014nchlt, title = {The {NCHLT} Speech Corpus of the South {A}frican languages}, author = {Barnard, Etienne and Davel, Marelie H and van Heerden, Charl and de Wet, Febe and Badenhorst, Jaco}, booktitle = {Workshop on Spoken Language Technologies for Under-resourced Languages (SLTU)}, year = {2014} }
@inproceedings{conneau2023fleurs, title = {{FLEURS}: Few-shot Learning Evaluation of Universal Representations of Speech}, author = {Conneau, Alexis and Ma, Min and Khanuja, Simran and Zhang, Yu and Axelrod, Vera and Dalmia, Siddharth and Riesa, Jason and Rivera, Clara and Bapna, Ankur}, booktitle = {IEEE Spoken Language Technology Workshop (SLT)}, year = {2023} }