
遇见数据集

swiss-ai/if-rl-singleturn-hard-prompts

收藏
Hugging Face2026-06-01 更新2026-06-14 收录
官方服务:

资源简介:

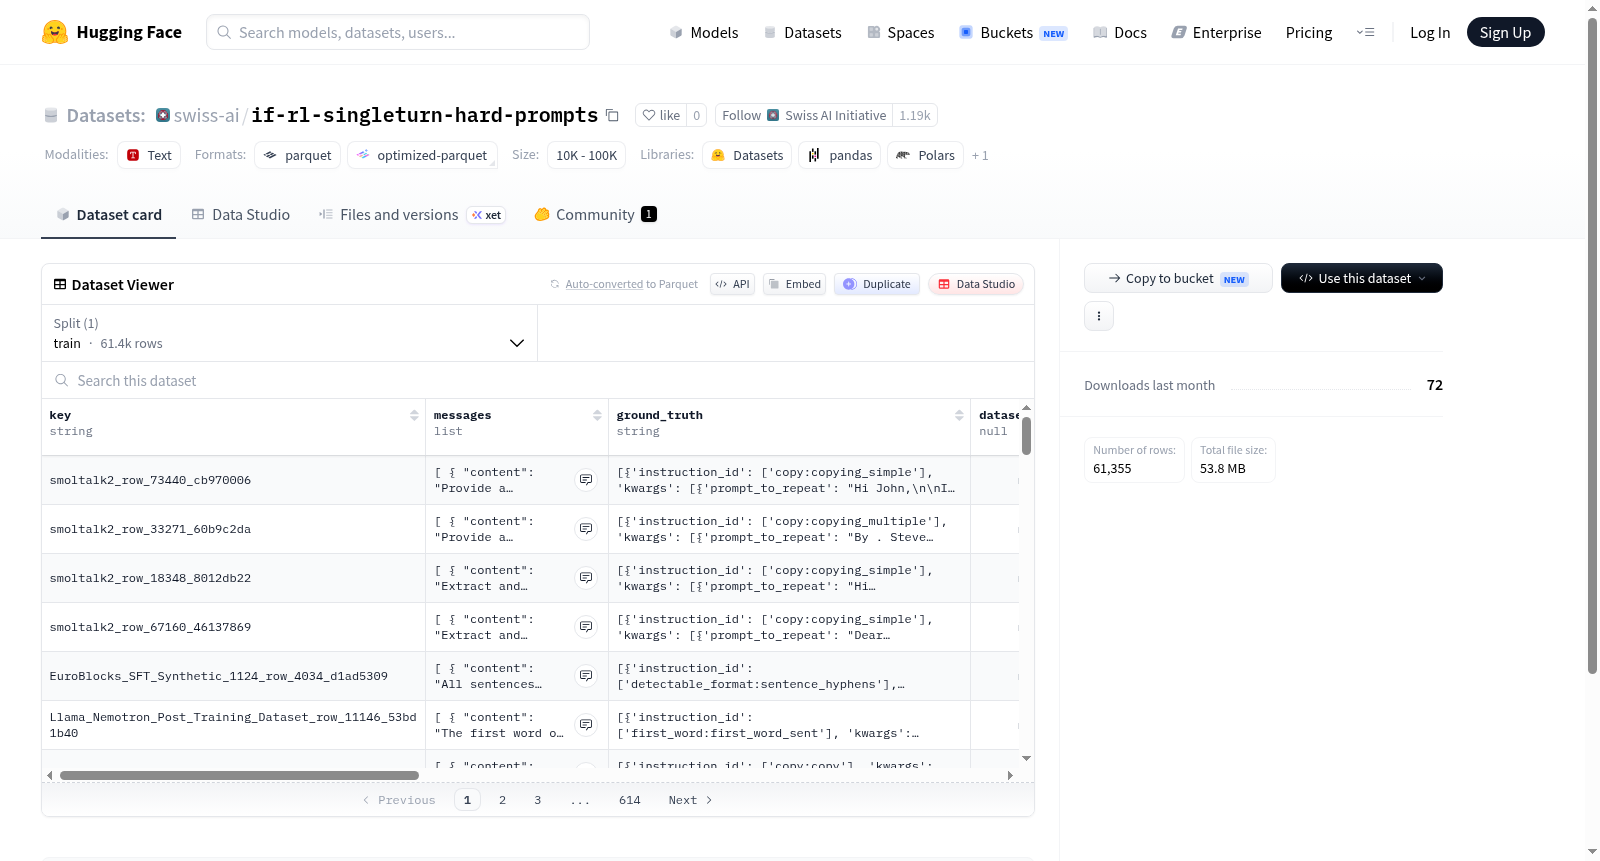
--- dataset_info: features: - name: key dtype: string - name: messages list: - name: content dtype: string - name: role dtype: string - name: ground_truth dtype: string - name: dataset dtype: 'null' - name: constraint_type dtype: 'null' - name: constraint dtype: string - name: pass_by_constraint dtype: string - name: total_pass dtype: int64 - name: incomplete_format dtype: bool - name: source dtype: 'null' - name: llm_judge dtype: 'null' - name: generation_model dtype: 'null' - name: if_verified dtype: 'null' - name: postpend dtype: 'null' - name: constraint_number dtype: 'null' splits: - name: train num_bytes: 113113217 num_examples: 61355 download_size: 53762422 dataset_size: 113113217 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
swiss-ai
搜集汇总
数据集介绍
swiss-ai/if-rl-singleturn-hard-prompts 数据集图片
构建方式
在人工智能对齐领域,强化学习从人类反馈(RLHF)是提升模型行为与人类价值观一致性的关键技术。该数据集专注于单轮交互场景下的硬约束指令遵循任务,通过精心设计的流程构建。首先,基于多样化约束类型生成包含清晰约束条件的指令文本,例如格式要求、内容边界或风格限制。每条指令关联一条模型必须遵循的约束规则,并配备已验证的符合约束的参考回答作为真值。数据集的构建还引入了自动与人工结合的校验机制,通过`pass_by_constraint`字段标记约束通过状态,并利用大语言模型作为裁判(`llm_judge`)评估回答的合规性,从而确保每一条样本具有明确的约束满足性和可验证性。最终,数据集收录了61,355条训练样本,覆盖丰富的约束模式,为强化学习中的奖励模型训练提供了高质的硬负样本。
特点
该数据集的显著特点在于其聚焦于指令遵循中的“硬约束”,即那些必须严格遵守、不可变通的条件,这区别于常见的软偏好。每条样本包含明确的`constraint`字段和`pass_by_constraint`布尔标记,量化了约束的完成情况,使得模型训练可以针对性地强化对关键规则的服从。`total_pass`字段进一步记录了多次评估中通过约束的总次数,反映了样本的难度层级。此外,数据集引入了`ground_truth`作为绝对参考,结合`messages`中的多轮对话结构,支持从上下文连贯性角度评估约束遵循。其规模适中且经过校验,避免了噪声干扰,特别适用于训练奖励模型对输出进行精密的约束合规性评分,从而推动模型在银行、法律等需严格执行指令的领域中表现更为可靠。
使用方法
该数据集的使用遵循标准HuggingFace Datasets库加载流程。用户可直接通过`load_dataset('if-rl-singleturn-hard-prompts')`获取训练集,其中每条样本包含`key`唯一标识、`messages`作为符合ChatML格式的对话列表、`ground_truth`参考回答以及`constraint`约束描述。在强化学习训练中,可将`pass_by_constraint`作为奖励标签,用于训练奖励模型区分遵循与违反约束的输出。对于需要精细控制的应用,可基于`constraint_type`(若可用)筛选特定约束类型的子集进行微调。数据集的索引结构支持快速访问,且`total_pass`字段可用于难例挖掘,优先训练模型处理高难度约束样本。建议在训练前进行数据分割以适配验证集需求,并利用`llm_judge`字段(若存在)辅助自动化评估管道。
背景与挑战
背景概述
该数据集名为if-rl-singleturn-hard-prompts,由相关研究机构于近期创建,聚焦于强化学习与指令跟随(Instruction Following)的交汇领域。其核心研究问题在于评估并提升语言模型在单轮交互中遵循复杂、硬性约束(hard constraints)指令的能力,此类问题在现实场景中广泛存在,例如在受限生成任务中确保输出严格匹配格式、内容或逻辑边界。通过包含大量人工设计的约束性提示(constraint-type字段)及对应的正确响应,该数据集为衡量模型对细粒度指令的遵循程度提供了标准化的基准。其影响力体现在为研究者提供了训练和评估模型在高度约束下推理与生成的挑战性资源,推动了从简单问答向复杂命令执行的范式演进,对提升模型的鲁棒性和可控性具有重要价值。
当前挑战
数据集所解决的领域挑战在于,当前语言模型虽然在开放域生成中表现优异,但在面对精确、多重的硬性约束时,常常无法完全满足所有指定条件,导致输出不符合预期,这是指令遵循领域亟待突破的瓶颈。数据集构建过程中面临的挑战包括:如何系统性地设计多样且真实的硬性约束(constraint字段),以避免数据偏差或过拟合;如何确保每条提示的正确响应(ground_truth)唯一且无歧义,这对标注者要求极高;以及如何通过自动化验证机制(如pass_by_constraint字段)高效评判模型输出是否真正满足所有约束,这一过程在复杂约束组合下尤其困难。
常用场景
经典使用场景
该数据集名为if-rl-singleturn-hard-prompts,专为单轮对话中硬提示(hard prompts)场景设计,通常用于强化学习框架下语言模型的指令遵循能力训练。在经典使用中,研究者将其作为评测和微调基准,通过给定的约束条件(constraint)和真实答案(ground_truth),衡量模型输出是否严格满足特定格式与内容限制。数据集包含超过六万个训练样本,每个样本围绕关键(key)、角色(role)和内容(content)等核心字段构建,模拟真实世界中需严格执行指令的对话交互,诸如要求模型遵循精确的规则或格式输出,从而提升模型在复杂约束下的鲁棒性与准确性。
实际应用
在实际应用层面,该数据集可被部署于需要高度指令依从性的场景,例如智能客服系统的响应格式规范化、法律文书的条款生成、医疗诊断报告的约束编写以及自动化编程任务中的代码风格匹配。以该数据集训练的模型能够更可靠地按照用户预设的规则执行单轮任务,减少因输出自由度过高导致的信息错误或合规风险。此外,在对话机器人与工具增强系统中,它可确保模型调用外部API时输出符合特定接口标准,提升了人机协作的效率和安全性。
衍生相关工作
该数据集的衍生工作主要围绕指令遵循与条件生成展开,经典研究包括通过强化学习优化模型对硬提示的响应成功率,以及引入对比学习或对抗训练增强模型在约束集合下的泛化能力。部分工作利用其约束类型(constraint_type)字段,探究不同规则复杂度下模型行为的差异,开发出分层奖励或课程学习策略。同时,它也为条件式语言建模提供了新的基准,启发了诸如约束导向的文本生成、少样本指令学习等后续探索,间接推动了从通用对话到精准控制模型的范式演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

