
遇见数据集

theprint/SelfHelp-ShareGPT

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

SelfHelp是一个通过DataMix生成的精选对话数据集,旨在支持心理健康教育和心理自助技术领域的语言模型训练与评估。该数据集包含多轮对话,涵盖认知行为疗法(CBT)、识别自动负面思维、正念练习以及为学生和从业者设计治疗工作坊活动等主题。每个条目都包含结构化、基于教学原理的响应,模拟循证推理、逐步指导和反思性提问,适用于教育聊天机器人、治疗师培训工具或心理健康素养项目等应用。该数据集与现实世界的治疗框架和教学设计原则紧密对齐,对于构建能够准确呈现临床心理学概念并保持非专业用户可访问性的AI系统的研究人员和开发者特别有价值。

SelfHelp is a curated collection of conversational data generated by DataMix, designed to support training and evaluation of language models in the domain of mental health education and psychological self-help techniques. The dataset features multi-turn dialogues covering topics such as cognitive behavioral therapy (CBT), identifying automatic negative thoughts, mindfulness practices, and designing therapeutic workshop activities for students and practitioners. Each entry includes structured, pedagogically grounded responses that model evidence-based reasoning, step-by-step instruction, and reflective questioning—ideal for applications in educational chatbots, therapist training tools, or mental health literacy programs. With clear alignment to real-world therapeutic frameworks and instructional design principles, this dataset is particularly valuable for researchers and developers building AI systems that must accurately represent clinical psychology concepts while maintaining accessibility for non-expert users.
提供机构:
theprint
搜集汇总
数据集介绍
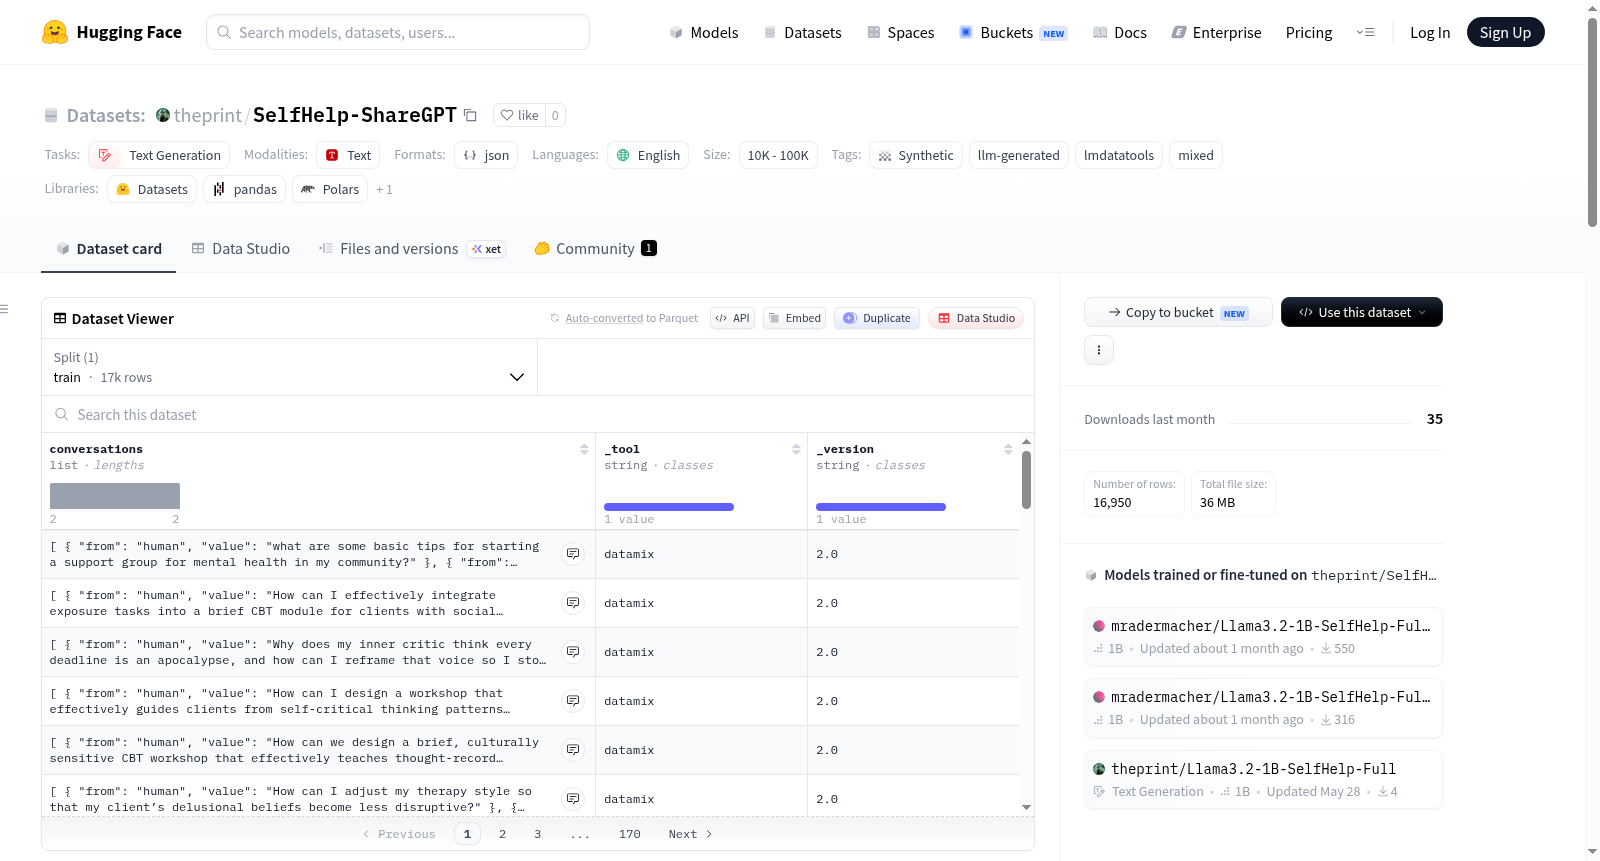
theprint/SelfHelp-ShareGPT 数据集图片
构建方式
SelfHelp-ShareGPT数据集的构建依托于LMDataTools框架中的DataMix工具箱,通过对来自HuggingFace的多个高质量对话数据集进行加权采样与融合而成。其源数据涵盖了认知行为疗法、正念练习、情绪支持、谈判对话及梦的解析等多种主题,包括theprint/CogBeTh-GPT、theprint/mindfulness-alpaca、theprint/Troubled等八个子集,每个子集按预设权重(0.03至0.22不等)混合,最终生成约16,950条多轮对话样本。构建过程中严格设定了指令与输出长度的上下限(指令10-4000字符,输出10-6800字符),并以ShareGPT格式输出,确保数据在结构上的一致性与实用性。
使用方法
使用SelfHelp-ShareGPT数据集十分简便,用户可直接加载JSON格式文件。以Python为例,通过json.load()读取本地文件(如SelfHelp-Sharegpt-16.95k-280526.json),即可获取包含16,950个条目的列表,每个条目包含conversations(对话内容)、_tool(生成工具)和_version(版本号)等字段。该格式与ShareGPT规范兼容,便于直接接入常用的语言模型训练流程,如HuggingFace的Transformers库或自定义的微调脚本。开发者可根据需要筛选特定主题或长度的数据进行针对性训练,亦可结合DataMix工具定制新的混合比例以适应不同应用场景。
背景与挑战
背景概述
SelfHelp-ShareGPT数据集由研究机构theprint于2026年创建,旨在通过多轮对话数据支持心理健康教育与心理自助技术领域的大语言模型训练与评估。该数据集整合了CogBeTh-GPT、mindfulness-alpaca、Empathetic-Alpaca等八个子数据集,涵盖认知行为疗法、自动负性思维识别、正念练习及治疗工作坊设计等主题。每条数据均包含结构化、基于教学法的回应,体现循证推理、分步指导与反思性提问。该数据集填补了心理自助领域高质量对话语料的空白,为开发教育型聊天机器人、治疗师训练工具及心理健康素养提升系统提供了关键资源,在临床心理学概念准确建模与非专业用户可及性之间取得了平衡。
当前挑战
该数据集所解决的领域问题在于,心理健康教育场景中现有的对话数据多缺乏专业性与结构化,难以支撑AI系统准确传达认知行为疗法等复杂概念,同时保持对非专业用户的亲和力。构建过程中面临的挑战包括:从八个来源整合数据时需处理不同格式、领域权重与质量差异,确保混合后的语料在临床准确性、教学有用性及对话自然度之间保持平衡;设置指令长度范围(10-4000字符)和输出长度范围(10-6800字符)以覆盖从简短练习到深入探讨的对话场景,同时避免数据冗余或关键信息丢失;此外,还需确保合成数据不引入偏见或错误心理知识,避免对实际应用产生误导。
常用场景
经典使用场景
在心理健康教育与自助技术领域,SelfHelp-ShareGPT数据集被广泛用于训练和评估面向非专业用户的语言模型。该数据集包含近一万七千条多轮对话,覆盖认知行为疗法、自动消极思维识别、正念练习及治疗工作坊设计等主题。每条对话均采用基于证据的推理、分步指导和反思性提问结构,使其成为构建教育型聊天机器人、心理咨询师辅助工具以及心理健康素养提升系统的理想训练资源。研究者通过微调预训练语言模型,使其能够模拟专业心理咨询师的对话风格,同时确保内容在临床心理学框架内准确且易懂。
解决学术问题
该数据集的核心价值在于弥补了心理健康领域高质量、结构化对话数据的匮乏。学术研究中,它解决了语言模型在临床心理学概念表征上的两大挑战:一是如何将复杂的治疗框架(如CBT)转化为自然、可操作的对话流程;二是如何在保持专业准确性的同时兼顾非专业用户的理解能力。SelfHelp-ShareGPT通过融合八个不同来源的子数据集(如CogBeTh-GPT、Empathetic-Alpaca等),系统性地提供了多主题、多视角的示范对话,推动了基于AI的心理干预模型从理论验证走向实证研究。其出现显著降低了研究者从零构建心理健康对话数据的门槛。
实际应用
在实际部署中,该数据集驱动的模型可嵌入在线心理咨询平台,为用户提供随时可得的初步情绪疏导和自助策略建议。例如,通过识别用户描述中的消极思维模式,系统能实时引导其进行认知重构练习。同时,它也被用于开发面向心理咨询实习生的技能培训系统,通过模拟来访者提问来训练学员的回应技巧。此外,在教育场景中,该数据集支撑了面向大学生的心理健康课程AI助教,协助解释正念概念或设计团体治疗活动方案。这些应用有效缓解了专业心理咨询资源稀缺的问题,推动了心理健康服务的普惠化。
数据集最近研究
最新研究方向
当前,心理健康领域与人工智能的交叉研究正迎来爆发式增长,SelfHelp-ShareGPT数据集应运而生,成为该前沿方向的重要资源。该数据集精心整合了认知行为疗法、正念练习、自动消极思维识别及心理教育工作坊设计等多轮对话语料,其内容根植于循证心理治疗框架,展现出在构建心理健康教育聊天机器人、心理治疗师辅助训练工具及心理素养普及系统中的巨大潜力。特别值得关注的是,该数据集通过融合混合采样策略,囊括了涉及共情对话、多样性公平与包容、及困境辅导等热点议题的子数据集,精准回应了当前社会对心理支持资源数字化、普惠化的迫切需求。这一工作不仅为研究者提供了结构严谨、教学导向鲜明的训练语料,更在确保临床心理学概念准确性的前提下保持了非专业用户的易理解性,为推动人工智能在心理健康领域的负责任应用与科学评估奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

