
songlab/gpn-star-scores-layout-benchmark-staging
收藏官方服务:
资源简介:
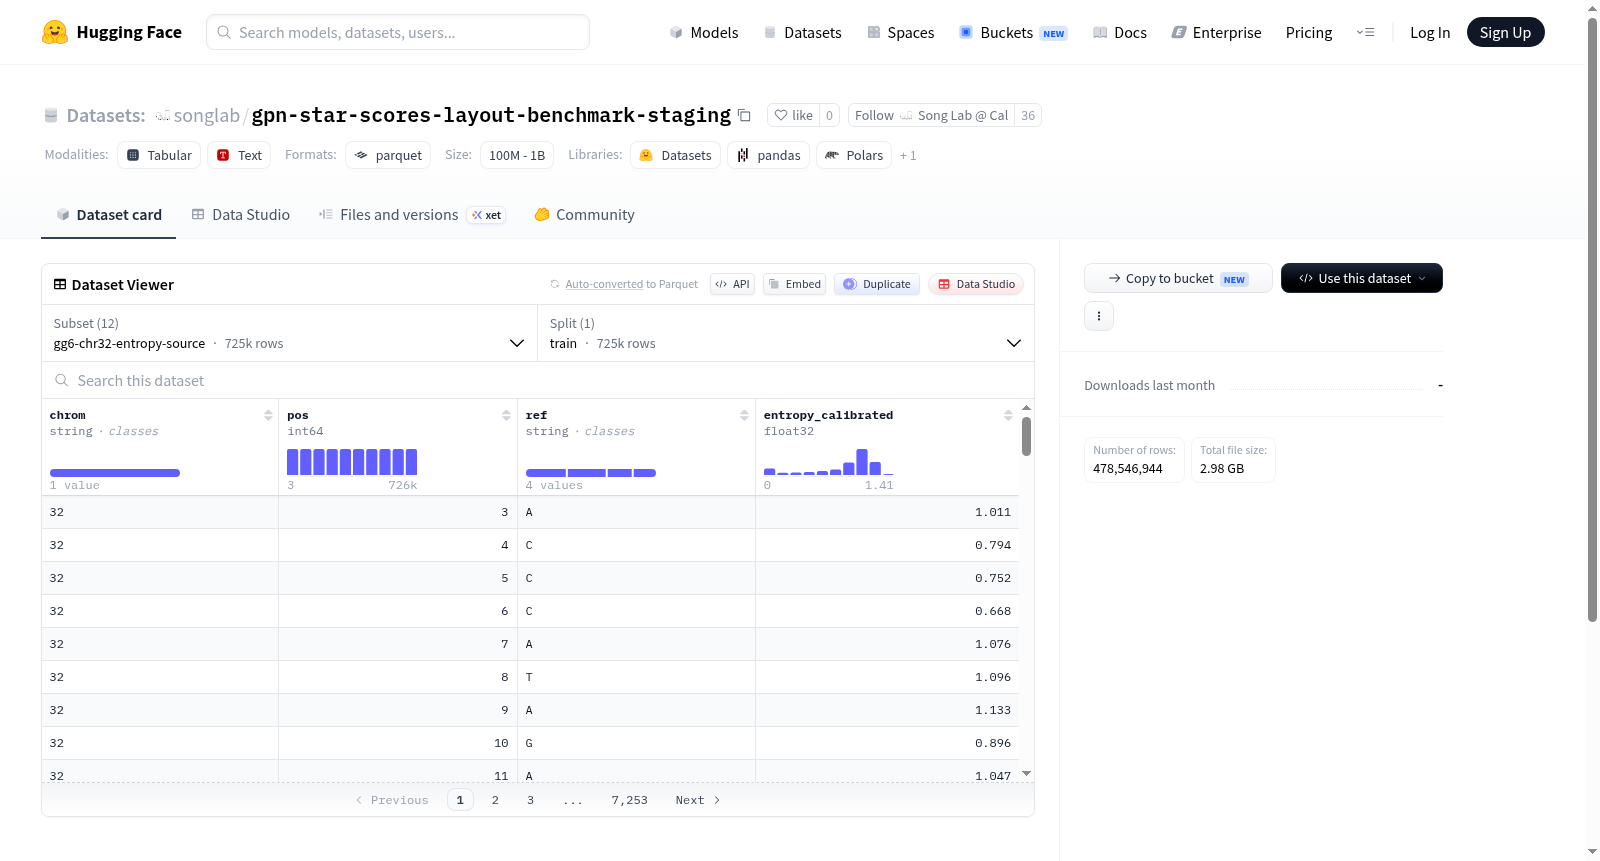
GPN-Star Parquet布局基准测试暂存数据集是一个公共临时数据集,用于在GitHub问题[`gonzalobenegas/gpn-star-scores#5`](https://github.com/gonzalobenegas/gpn-star-scores/issues/5)中可重复的布局基准测试。每个配置暴露一个不可变的源或重写候选给数据集查看器。此存储库是基准测试暂存,而非GPN-Star发布版本。
GPN-Star Parquet layout benchmark staging is a public, temporary staging dataset for the reproducible layout benchmark in GitHub issue [`gonzalobenegas/gpn-star-scores#5`](https://github.com/gonzalobenegas/gpn-star-scores/issues/5). Each configuration exposes exactly one immutable source or rewrite candidate to Dataset Viewer. This repository is benchmark staging, not a GPN-Star release repository.
提供机构:
songlab原始信息汇总
数据集概述:GPN-Star Parquet layout benchmark staging
基本信息
- 数据集名称:GPN-Star Parquet layout benchmark staging
- 所有者:Song Lab @ Cal 36(组织:songlab)
- 数据集地址:https://hf-mirror.com/datasets/songlab/gpn-star-scores-layout-benchmark-staging
- 用途说明:这是用于
gonzalobenegas/gpn-star-scores#5中可重复布局基准测试的公共临时暂存数据。每个配置向数据集查看器公开一个不可变的源或候选重写。此仓库是基准暂存数据,非 GPN-Star 发布仓库。
数据规模
- 总行数:478,546,944 行
- 总文件大小:2.98 GB
- 大小范围:100M - 1B
数据格式与模态
- 模态:表格数据(Tabular)、文本(Text)
- 文件格式:Parquet
- 支持的库:Datasets、pandas、Polars 等
数据集子集(共12个)
| 子集名称 | 行数 |
|---|---|
| gg6-chr32-entropy-source | 725k |
| gg6-chr32-entropy-zstd-1048576 | 725k |
| gg6-chr32-entropy-zstd-262144 | 725k |
| gg6-chr32-llr-source | 2.18M |
| gg6-chr32-llr-zstd-1048576 | 2.18M |
| gg6-chr32-llr-zstd-262144 | 2.18M |
| hg38-v100-chr22-entropy-source | 39.2M |
| hg38-v100-chr22-entropy-zstd-1048576 | 39.2M |
| hg38-v100-chr22-entropy-zstd-262144 | 39.2M |
| hg38-v100-chr22-llr-source | 117M |
| hg38-v100-chr22-llr-zstd-1048576 | 117M |
| hg38-v100-chr22-llr-zstd-262144 | 117M |
数据列说明(以 gg6-chr32-entropy-source 子集为例)
- chrom(字符串类型,1个唯一值):染色体标识
- pos(整数类型,范围 3-726k):位置信息
- ref(字符串类型,4个唯一值):参考碱基(如 A、C、T、G)
- entropy_calibrated(浮点数类型,范围 0-1.41):经过校准的熵值
搜集汇总
数据集介绍
构建方式
该数据集专为GPN-Star项目中的Parquet布局基准测试而构建,旨在通过可复现的对比实验优化数据存储格式。其构建方式围绕两种核心数据类型,即熵编码与对数似然比数据,分别采集自gg6与hg38-v100两种参考基因组,并针对人类第22号与第32号染色体进行精细划分。在此基础上,每一类型数据均包含原始未压缩的源文件以及采用Zstandard压缩算法、分块大小为262144字节与1048576字节的候选重写版本。最终以HuggingFace Datasets的多配置形式组织,每个配置对应一组不可变的Parquet文件,便于直接加载与对比。
特点
数据集的核心特点在于其服务于布局优化基准测试的明确用途,而非作为GPN-Star的正式发布版。它提供了同一数据源在不同压缩策略下的配对文件,支持研究者系统评估Zstandard压缩分块大小对I/O性能与存储效率的影响。覆盖两种基因组与两类特征数据,确保了测试结果的泛化性。每个配置仅包含单一训练拆分且数据不可变,保证了基准实验的公平性与可重复性,特别适合用于检验Parquet列式存储布局在不同场景下的优劣。
使用方法
该数据集的使用非常简便,这与HuggingFace Datasets的集成机制相辅相成。用户只需指定数据集标识符与配置名称,即可通过load_dataset函数加载任意一个Parquet文件进行验证。例如加载gg6-chr32熵编码的源文件,或加载hg38-v100-chr22的对数似然比数据经1048576字节分块压缩后的版本。每个配置均作为独立的训练集暴露,无需额外的分割操作,这为批量运行基准测试脚本提供了高效的数据访问接口。
背景与挑战
背景概述
随着基因组学与深度学习交叉领域的蓬勃发展,大规模基因组数据的存储与高效访问成为制约模型训练与推理的关键瓶颈。于2023年由GPN-Star研究团队创建的gpn-star-scores-layout-benchmark-staging数据集,旨在探索基因组数据在Parquet列式存储格式下的最优布局方案,核心研究问题聚焦于不同压缩策略与分块大小对数据读写效率及存储性能的影響。该数据集提供了针对人类参考基因组hg38及黑腹果蝇基因组gg6特定染色体区域的熵编码与对数似然比特征数据,通过对比源文件与不同zstd压缩级别的重组版本,为基因组大数据的存储优化研究提供了标准化基准,有效推动了计算基因组学中数据基础设施的发展。
当前挑战
该数据集面临的挑战首先体现在领域问题层面:基因组原始数据(如FASTA或VCF格式)通常体量巨大且冗余度高,传统行式存储格式在深度学习工作负载下的访问效率低下,如何在保持数据完整性的同时实现存储压缩与快速随机读取的平衡是核心难题。在构建过程中,主要挑战包括:设计适用于生物序列数据的列式存储转换策略,解决不同基因组坐标系统间的对齐问题;确定最优的分块大小(如262144与1048576字节)以适配GPU显存层级;以及确保压缩算法在不影响数据随机访问性能的前提下最大化压缩比。此外,该基准测试数据的临时性定位也带来了版本管理与长期可复现性的挑战。
常用场景
经典使用场景
GPN-Star Parquet布局基准测试分期数据集在生物信息学领域中,主要用于评估基因组数据压缩与存储方案的性能优劣。该数据集通过提供不同基因组区域(如人类基因组hg38和黑猩猩基因组gg6)的熵编码与对数似然比(LLR)特征数据,并搭配多种Parquet布局格式(如原始Kryo序列化、ZSTD压缩级别262144与1048576),构建了一个标准化的测试平台。研究者可借此系统性地对比不同数据布局在读取效率、压缩率与内存占用上的表现,从而为大规模基因组数据的存储优化提供可重复的基准参考。
解决学术问题
该数据集的核心贡献在于解决了基因组大数据存储领域中长期存在的基准测试碎片化问题。以往不同研究采用各自独立的数据格式与测试流程,导致结果难以横向对比。通过提供统一的分期数据与标准化布局方案,研究者得以在相同条件下系统评估压缩算法与数据组织形式对基因组序列熵值分析和变异检测任务的影响。这为探索更优的基因组数据存储策略奠定了实证基础,推动了高效存储与快速访问之间的平衡研究,对降低生物医学大数据处理的基础设施成本具有深远意义。
衍生相关工作
围绕该基准数据集已衍生出多项经典工作,其中最具代表性的是GPN-Star评分系统的持续迭代与跨平台布局优化研究。一方面,研究者利用该数据集系统对比了不同分块大小与压缩策略对熵值评分及似然比计算的影响,形成了可复现的布局优化指南。另一方面,该基准也催生了针对GPU加速阵列与分布式存储系统的新型Parquet适配器,推动了基因组数据在异构计算环境中的高效流转。这些衍生效能不仅验证了原始基准的实用性,更拓展了其在实时生物信息学分析中的应用边界。
以上内容由遇见数据集搜集并总结生成


