
遇见数据集

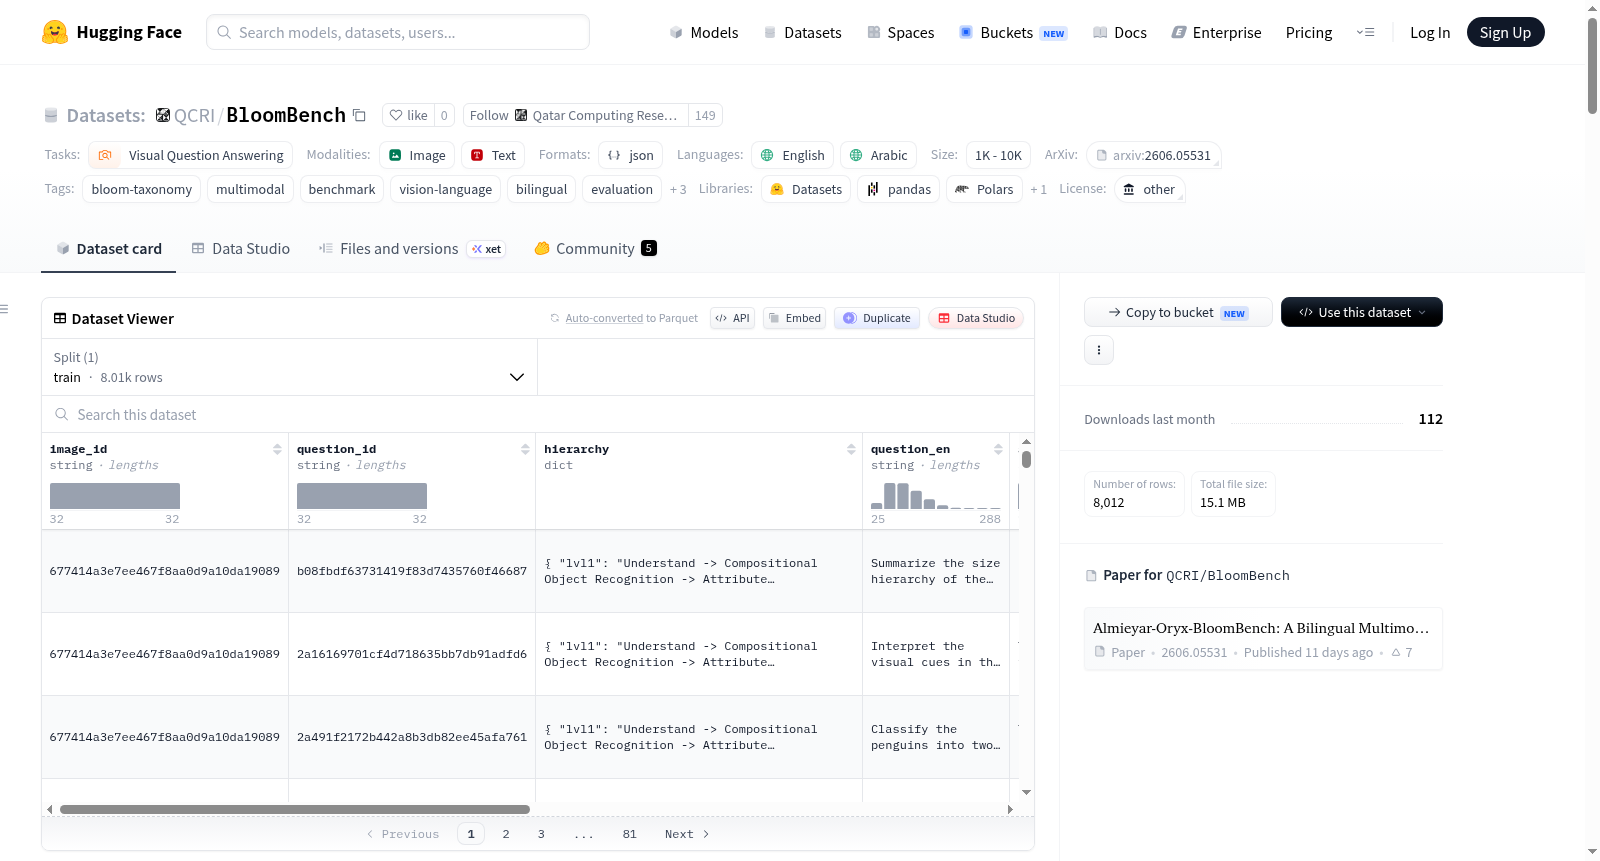
QCRI/BloomBench

收藏
Hugging Face2026-06-09 更新2026-06-14 收录
官方服务:

资源简介:

Almieyar-Oryx-BloomBench是Almieyar基准系列的一部分,是首个基于认知人类基础的双语(英语-阿拉伯语)多模态视觉语言模型基准。该基准基于Blooms Taxonomy,通过精心设计的图像-问题-答案任务,系统评估六个层次的认知能力:从基本的感知回忆到高阶的创造性合成。它旨在解决现有基准在评估认知弱点和提供针对性改进见解方面的不足。关键发现表明,当前先进的视觉语言模型存在认知不对称性,在语义理解方面表现强劲,但在事实回忆和创造性合成方面较弱;且阿拉伯语性能持续落后于英语,即使在强大的多语言模型中也是如此。数据集包含7,747个问答对,涵盖106个不同的叶子类别,采用4项选择题格式,图像来源于网络爬取的真实世界图像,质量验证率达到98.45%。

BloomBench is part of the Almieyar benchmarking series — the first cognitively human-grounded, bilingual (English–Arabic) multimodal benchmark for Vision-Language Models (VLMs). Grounded in Blooms Taxonomy, it systematically evaluates six levels of cognition through carefully designed image–question–answer tasks. It addresses the gap in existing benchmarks that obscure cognitive weaknesses and provide little insight for targeted improvement. A key finding reveals that state-of-the-art VLMs show a sharp cognitive asymmetry — strong in semantic understanding but substantially weaker in factual recall and creative synthesis, with Arabic performance consistently lagging English even in strong multilingual models. The dataset includes 7,747 QA pairs across 106 distinct leaf categories, in a 4-choice MCQ format, with images sourced from web-crawled real-world images and a quality validation rate of 98.45%.
提供机构:
QCRI
搜集汇总
数据集介绍
QCRI/BloomBench 数据集图片
构建方式
BloomBench隶属于Almieyar基准系列,是首个以人类认知为基础、面向视觉语言模型的双语(英语-阿拉伯语)多模态评估基准。其构建遵循半自动化、混合验证的流水线:首先,由Gemini 2.5 Pro为布鲁姆分类学的每个叶节点生成10个涵盖西方、中东与阿拉伯文化背景的场景构思;继而依据关键词从互联网检索多样化真实图像;随后生成完全基于视觉内容的开放式图文问答对,并将其转化为包含一个陷阱选项的四选一多选题;再完成全文的多选题现代标准阿拉伯语翻译;最终通过大型语言模型裁判与人类仲裁相结合的混合质量验证机制,对每类叶节点至少4个样本进行抽检,取得了98.45%的高质量率。
使用方法
使用者可通过Hugging Face datasets库便捷加载BloomBench数据集,获取包含图像标识符、双语问题与答案、层次化分类路径及多选题选项在内的完整字段。利用Python列表推导式,可依据布鲁姆层级(如'Remember'或'Create')或具体的叶类别(如'Chart Analysis')对样本进行高效筛选,从而开展针对性的子任务评估。该数据集专为双语环境下评估视觉语言模型的认知推理能力而设计,研究者可在论文中引用相关文献,并参照GitHub仓库获取更多实验细节与复现指引。
背景与挑战
背景概述
BloomBench是Almieyar基准系列的核心组成部分,由卡塔尔计算研究所(QCRI)的研究团队于2025年构建,其相关论文已被ACL 2026 Findings接收。该数据集旨在填补现有视觉语言模型(VLM)评估基准的认知维度空白。当前主流基准如MMMU,其任务设计多聚焦于碎片化、孤立的技能测试,导致对模型认知弱点的刻画模糊不清,且缺乏针对性的改进方向。BloomBench则独辟蹊径,以修订版布鲁姆教育目标分类学为理论框架,系统性地评估VLM在从基础感知回忆到高阶创造性综合的全谱系认知能力。通过构建一个包含7,747个双语(英文与阿拉伯文)多项选择题的视觉问答基准,该工作揭示了前沿模型在语义理解上表现强劲,但在事实回忆与创造性合成环节存在显著不足,且阿拉伯语性能普遍落后于英语,为多语言多模态认知评估开辟了新范式。
当前挑战
BloomBench所面对的挑战是多维度的。在领域问题层面,现有VLM基准普遍缺乏对人类认知层次结构的系统性映射,评估任务分布高度失衡——例如MMMU中分析层级独占66.4%的覆盖,而创造与评价层级合计不足1.1%,造成模型认知能力的评估偏差。该数据集的核心挑战在于构建一套能够忠实反映完整认知阶梯的双语评估框架。在构建过程中,团队面临了多重困难:需为布鲁姆分类法的106个叶子节点设计兼具文化敏感性的场景(涵盖西方、中东与阿拉伯语境),从海量网络图像中检索符合特定认知任务的真实世界图片,并确保生成的问答对严格基于视觉内容而非语言先验。此外,生成原创建构型(Create)与批判性评价型(Evaluate)问题远比事实回问题目复杂,需兼顾语义准确性与认知深度。最终,通过LLM裁判与人工仲裁的混合验证策略,在层级抽样969个样本上达到了98.45%的质量率,方得以实现这一高难度的认知评估基准。
常用场景
经典使用场景
BloomBench作为首个基于布鲁姆认知分类学构建的双语多模态基准,其最经典的使用场景在于系统性地评估视觉语言模型(VLM)在六个认知层级上的表现。该数据集通过精心设计的图像-问题-答案对,覆盖从基础感知回忆(Remember)到高阶创造性综合(Create)的完整认知阶梯,能够精准刻画模型在事实回忆、语义理解、逻辑分析、批判评价、知识应用与创意生成等方面的能力分布。研究者可借此剖析模型认知能力的结构性短板,例如当前先进模型虽在语义理解上表现优异,却在事实回忆与创造性综合上显著薄弱,从而为模型的定向优化提供诊断依据。
解决学术问题
BloomBench的诞生回应了现有VLM基准评估碎片化、缺乏认知深度与诊断价值的核心学术困境。传统基准往往聚焦于狭窄且相互割裂的任务,无法揭示模型在人类认知层次上的系统性弱点,也难以指导有针对性的改进。该数据集通过锚定完整的布鲁姆认知层级,填补了高阶认知能力(如创造性综合与批判评价)几乎未被覆盖的评估空白。其双语特性(英语与阿拉伯语)更首次支持跨语言认知差异的严谨对比,揭示出模型在阿拉伯语场景下表现系统性滞后的现象,为多语言视觉语言模型的公平性与跨文化认知研究开辟了崭新的学术方向。
实际应用
在实际部署场景中,BloomBench展现出极高的应用价值,尤其适用于需要对视觉语言模型进行精细化认知审计的领域。例如,教育科技公司可借助该基准选择合适的模型用于自动批改、智能辅导或生成多语言学习内容,确保模型不仅能理解表层语义,还能执行逻辑推理与创造性任务。在内容审核与安全评估中,Evaluate层级的子任务可帮助检测模型在文化敏感性、毒性内容识别及年龄适切性判断上的表现。此外,跨国企业和多语言服务提供商可利用其双语评估框架,验证模型在阿拉伯语等资源稀缺语言上的认知稳健性,从而更安全地部署多模态AI助手、视觉问答系统及跨文化创意生成工具。
数据集最近研究
最新研究方向
BloomBench作为首个基于布鲁姆认知分类学的双语多模态基准,当前聚焦于揭示视觉语言模型在认知层级上的系统性不对称——模型在语义理解层面表现卓越,却在事实回忆与创造性综合等高级认知环节暴露出显著短板,尤其在阿拉伯语场景中性能普遍弱于英语。这一发现不仅为评估多模态智能体提供了超越传统窄域测试的认知诊断框架,更与当前大模型能力边界探讨、跨语言公平性及教育领域智能评估等热点议题深度耦合,推动了从任务导向评测向认知导向评测的范式转型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

