forestofaudits-agent-grader-traces-20260608-backfilled
收藏资源简介:
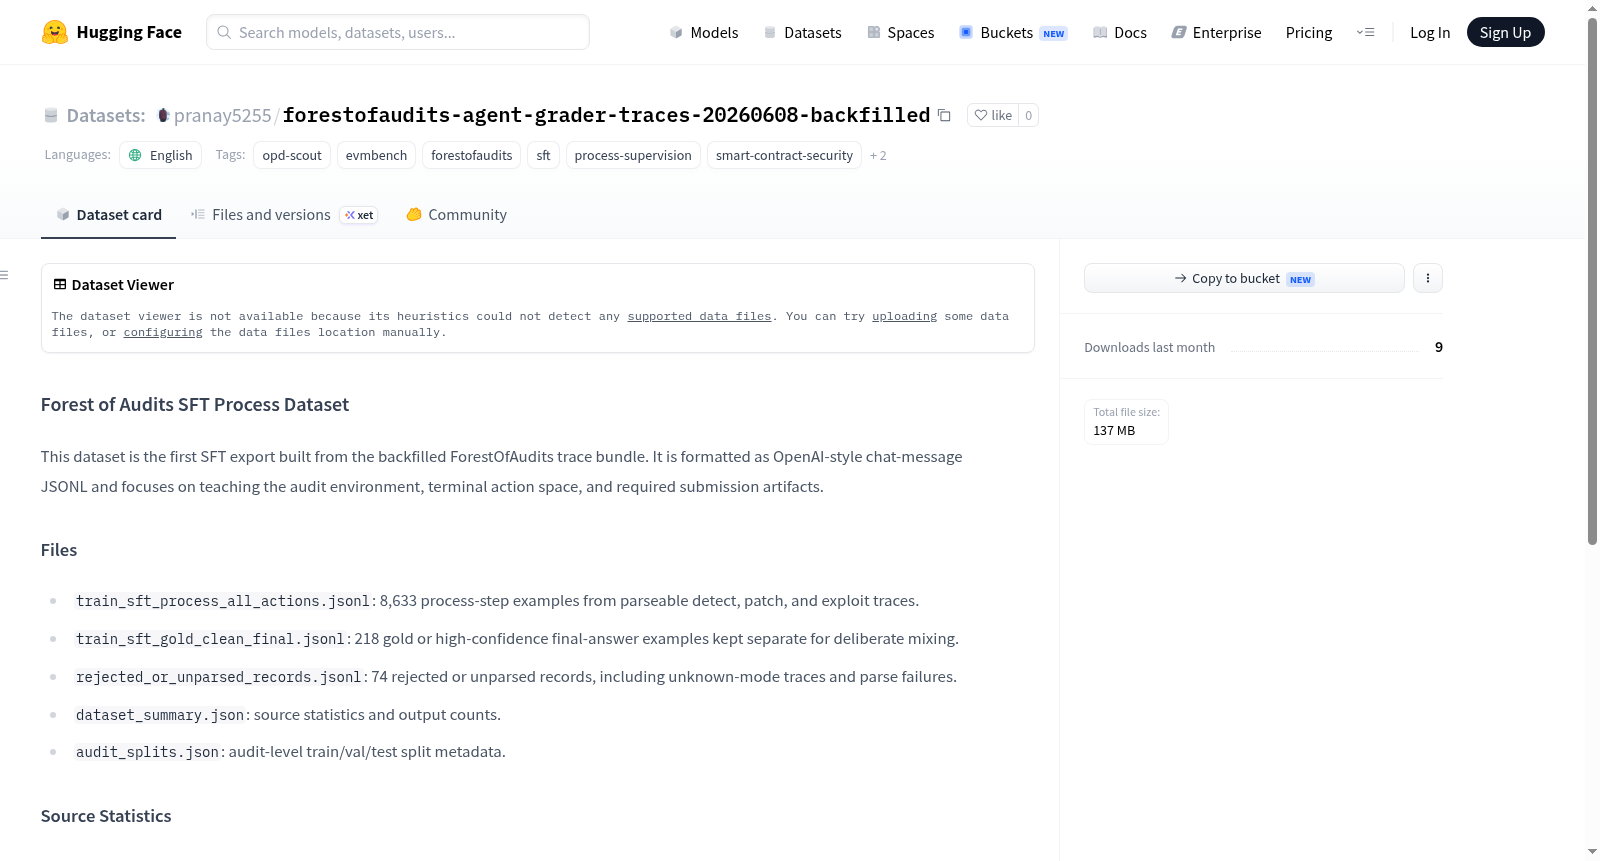
Forest of Audits SFT Process Dataset 是一个专门用于智能合约安全审计监督式微调(SFT)的数据集。该数据集是首个基于ForestOfAudits跟踪包回填构建的SFT导出数据集,采用OpenAI风格的聊天消息JSONL格式。其主要目的是教授模型审计环境、终端操作空间以及安全审计过程中所需的提交工件(如检测报告、补丁方案、利用证明)。数据集包含8,633个过程步骤示例,这些示例来自可解析的检测、补丁和利用跟踪记录。此外,还单独提供了218个高质量或高置信度的最终答案示例,用于有控制的混合训练。数据来源于217条跟踪记录,覆盖41次独立审计,包含135次检测模式、56次补丁模式、24次利用模式和2次未知模式。数据集还记录了各种审计状态统计,包括72个缺失最终工件、88个过早终止、79个错误状态跟踪以及24次利用尝试中仅2次通过的情况。数据格式严格使用system、user和assistant三种角色,工具调用和工具输出被序列化为带标签的文本块,并保留了结果和质量元数据,便于后续加权或消融实验。该数据集适用于智能合约安全审计、过程监督学习、代码审计助手训练等任务。
The Forest of Audits SFT Process Dataset is a specialized dataset for supervised fine-tuning (SFT) in smart contract security auditing. It is the first SFT export dataset constructed based on backfilling from the ForestOfAudits trace package, using an OpenAI-style chat message JSONL format. Its primary purpose is to teach models about the audit environment, terminal operation space, and submission artifacts required during the security audit process (such as detection reports, patch solutions, and proof-of-exploit). The dataset contains 8,633 process step examples derived from parsable detection, patch, and exploit trace records. Additionally, it separately provides 218 high-quality or high-confidence final answer examples for controlled mixed training. The data originates from 217 trace records, covering 41 independent audits, including 135 detection modes, 56 patch modes, 24 exploit modes, and 2 unknown modes. The dataset also records various audit status statistics, including 72 missing final artifacts, 88 premature terminations, 79 error state traces, and only 2 passes out of 24 exploit attempts. The data format strictly uses system, user, and assistant roles, with tool calls and tool outputs serialized into labeled text blocks, and retains result and quality metadata to facilitate subsequent weighting or ablation experiments. This dataset is suitable for tasks such as smart contract security auditing, process supervision learning, and code audit assistant training.
Forest of Audits SFT Process Dataset 数据集概述
该数据集是首个从回溯填充的 ForestOfAudits 追踪数据集中导出的 SFT(监督微调)数据集,采用 OpenAI 风格的聊天消息 JSONL 格式,专注于教学审计环境、终端操作空间及所需提交产物。
数据文件
- train_sft_process_all_actions.jsonl:包含 8,633 个过程步骤示例,来自可解析的 detect、patch 和 exploit 追踪数据。
- train_sft_gold_clean_final.jsonl:包含 218 个黄金或高置信度最终答案示例,为刻意混合而保持独立。
- rejected_or_unparsed_records.jsonl:包含 74 个被拒绝或无法解析的记录,包括未知模式追踪和解析失败数据。
- dataset_summary.json:源统计信息和输出计数。
- audit_splits.json:审计级别的训练/验证/测试分割元数据。
源统计信息
- 追踪数:217
- 审计数:41
- 模式分布:135 个 detect、56 个 patch、24 个 exploit、2 个 unknown
- 缺失最终产物:72
- 过早终止:88
- 错误状态追踪:79
- Exploit 通过数:24 个中有 2 个通过
数据格式说明
数据行仅使用 system、user 和 assistant 角色。工具调用和工具输出被序列化为带标签的文本块,并保留结果和质量元数据,便于后续加权或消融实验。