fnbm-current-cocktail-dc-capacity-20260726
收藏资源简介:
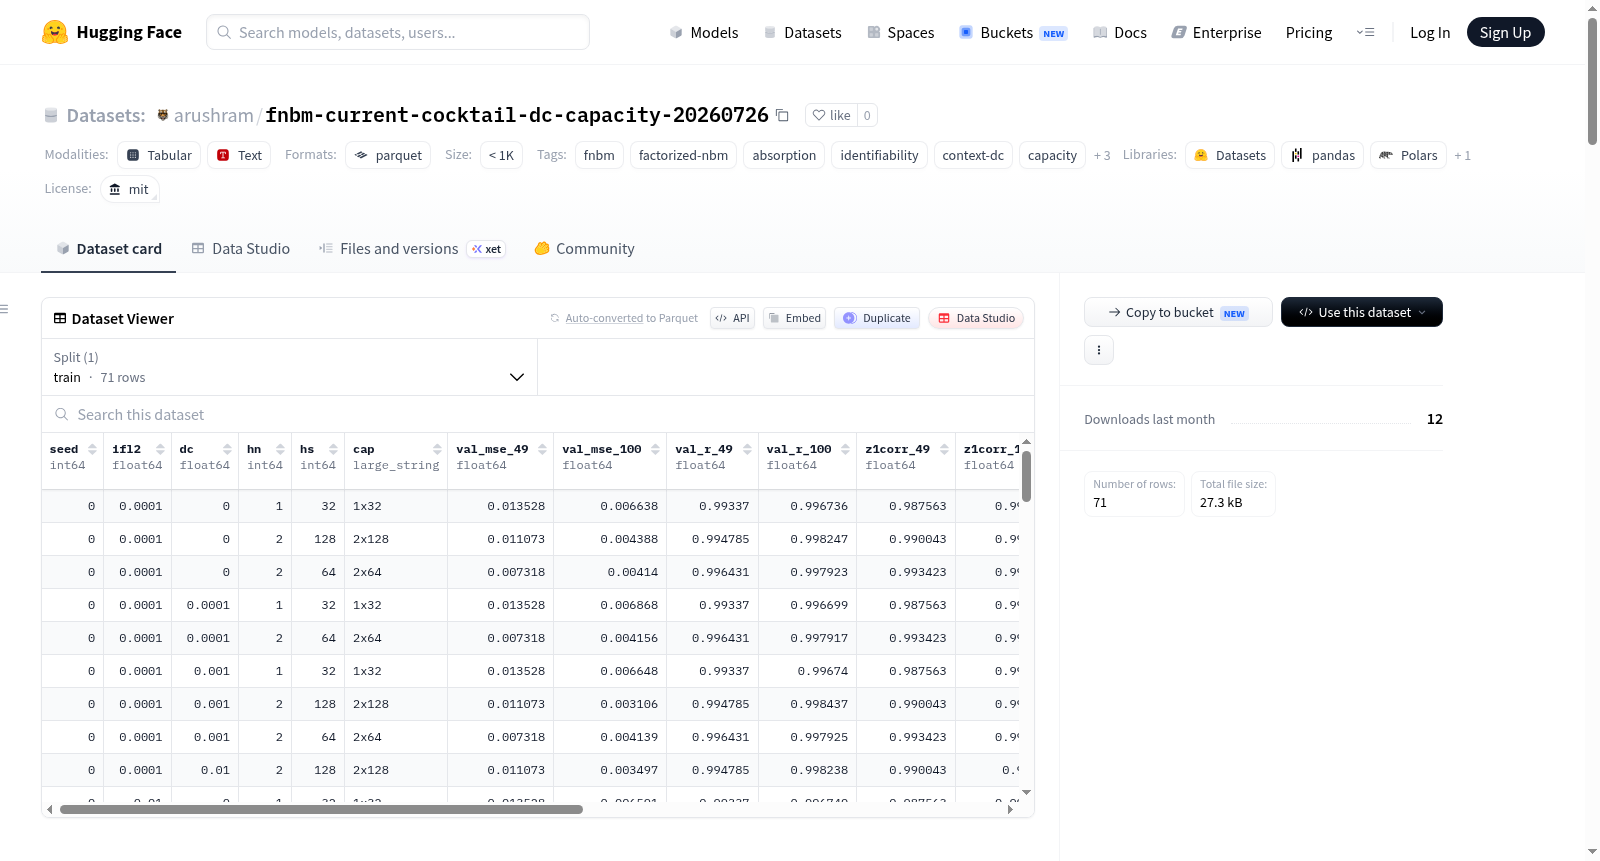
该数据集名为fnbm-current-cocktail-dc-capacity-20260726,记录了FactorizedNBM(因子化神经基础模型)在容量、正则化与随机种子影响下的实验研究结果。实验重点关注模型在纯一阶合成数据上产生虚假二阶归因(即泄漏)的问题。通过系统扫描超参数组合,包括交互特征L2惩罚(取值1e-4和1e-2)、交互上下文直流惩罚(取值0、1e-4、1e-3、1e-2)、滤波器变换层容量(配置为1x32、2x64、2x128)以及4个随机种子(0-3)。模型在ten-motif纯一阶无噪声数据上训练101个周期,并在第50周期激活二阶组件。数据集包含71行(覆盖72种可能组合中的71种)和20列,分为实验配置参数(如seed, ifl2, dc, hn, hs, cap)和性能评估指标。关键指标包括周期49和100的验证集均方误差(val_mse)和皮尔逊相关系数(val_r)、一阶归因与真实值的相关性(z1corr)、泄漏度量(leak_100)、上下文直流分量(dc_raw_max, dc_raw_100)、二阶贡献幅度(o2_raw_100)、移位重复核对数(n_red)、恢复的真实模体数量(n_rec)以及功能滤波器数量(n_func)。该数据集适用于分析神经网络容量对训练稳定性(种子鲁棒性)的影响、正则化方法在控制虚假高阶交互识别上的有效性与代价,以及模型内部表示随容量变化的规律。
The dataset, named fnbm-current-cocktail-dc-capacity-20260726, documents experimental results investigating the behavior of FactorizedNBM (Factorized Neural Basis Model) under the influence of capacity, regularization, and random seeds. The study specifically addresses the issue of spurious second-order attribution (i.e., leakage) when the model is trained on pure first-order (no second-order signals) synthetic data. It systematically scans hyperparameter combinations, including interaction feature L2 penalty (values: 1e-4 and 1e-2), interaction context DC penalty (values: 0, 1e-4, 1e-3, 1e-2), filter transformation layer capacity (configurations: 1x32, 2x64, 2x128), and four random seeds (0-3). The model is trained for 101 epochs on ten-motif pure first-order noiseless data, with second-order components activated at epoch 50. The dataset comprises 71 rows (covering 71 out of 72 possible combinations) and 20 columns, categorized into experimental configuration parameters (e.g., seed, ifl2, dc, hn, hs, cap) and performance evaluation metrics. Key metrics include validation mean squared error (val_mse) and Pearson correlation coefficient (val_r) at epochs 49 and 100, correlation of first-order attribution with ground truth (z1corr), leakage measure at epoch 100 (leak_100, with ground truth gt_leak_100 always 0), peak and final values of context DC components (dc_raw_max, dc_raw_100), raw magnitude of second-order contributions (o2_raw_100), logarithm of shifted repeated kernels (n_red), number of recovered true motifs (n_rec), and number of functional filters (n_func). This dataset is suitable for analyzing how neural network capacity affects training stability (seed robustness), the effectiveness and cost of regularization methods (L2 penalty and DC penalty) in controlling spurious high-order interaction identification, and the patterns of model internal representations (such as filter redundancy and motif recovery) as capacity varies.
数据集概述
该数据集名为 fnbm-current-cocktail-dc-capacity-20260726,是一个关于因子化神经瓶颈模型(Factorized NBM,FNBM)中二阶泄漏、上下文直流(DC)惩罚与模型容量之间关系的仿真实验评估结果。
数据集基本信息
- 许可协议: MIT
- 行数: 71
- 列数: 20
- 实验任务: 在一阶十基序无噪声数据上(真实二阶质量严格为0)训练FNBM,在50个epoch后激活二阶,检验模型产生的虚假二阶吸收(泄漏)。
- 实验配置: 71/72组合的“鸡尾酒”扫描,涉及
interaction_context_dc_penalty、interaction_feature_l2、filter_transform容量以及训练种子(0-3)的网格搜索。
主要数据列说明
| 列名 | 类型 | 描述 |
|---|---|---|
| seed | int64 | 训练种子(0-3)。泄漏模式与种子高度相关:1x32/2x64下仅种子1泄漏,2x128下种子1无泄漏但种子0和2泄漏。 |
| ifl2 | float64 | 交互特征L2惩罚(interaction_feature_l2_penalty),扫描值 {1e-4, 1e-2}。1e-4为敏感水平,1e-2为特异性锚点。 |
| dc | float64 | 交互上下文DC惩罚(interaction_context_dc_penalty),扫描值 {0, 1e-4, 1e-3, 1e-2},具体取决于容量。惩罚上下文的常数分量(DC分量),该分量会将二阶伪装成一阶。 |
| hn / hs / cap | int64 / large_string | 模型容量描述:每滤波器组MLP的隐藏层数(hn)和隐藏宽度(hs)。容量标签组合为1x32、2x64、2x128。 |
| val_mse_49 / val_mse_100 | float64 | 第49 epoch(二阶激活前纯一阶拟合)和第100 epoch(最终)的验证MSE。 |
| z1corr_49 / z1corr_100 | float64 | 第49和第100 epoch的一阶归因与真实值的序列级相关性。从z1corr_49到z1corr_100的下降表示一阶质量被二阶吸收。 |
| leak_100 | float64 | 泄漏度量(sim_mean_model_z_abs_ratio):模型在二阶放置的归因质量比例。真实值严格为0(见gt_leak_100列),因此所有泄漏都是虚假的。 |
| gt_leak_100 | float64 | 真实二阶质量,所有行均为0.0,证明leak_100是纯泄漏。 |
| dc_raw_max / dc_raw_100 | float64 | 上下文DC原始分量在epoch 50-100间的最大值和最终值。未惩罚时可达~1013,dc=1e-3时抑制至~0.07。 |
| n_red | int64 | 第100 epoch的位移重复核对数量(归一化互相关>0.8)。中位数从1x32的8.0降至2x128的0.5,表明容量无需去相关惩罚即可抑制重复。 |
| n_rec | int64 | 第100 epoch的每基序一阶恢复数(10个真实基序中有多少个与某滤波器的一阶归因 |
| n_func | int64 | 第100 epoch的功能滤波器计数(序列级一阶贡献方差超过最活跃滤波器1%的滤波器数量)。 |
六大关键发现
- 容量是种子鲁棒性杠杆,而非拟合杠杆:大容量(2x128)不降低最优拟合,但大幅缩小种子间方差(0.00084 vs 0.016),将最差种子提升4倍。
- 容量重新洗牌了哪些种子泄漏: 在敏感ifl2水平下,不同容量条件下泄漏的种子不同;净特异性无增益。
- 仅
interaction_feature_l2=1e-2实现全域零泄漏:在所有容量、种子和dc水平下,35/35组合均无泄漏。 - DC惩罚攻击正确机制但不足够:可抑制DC分量14000倍,但残留泄漏仍存在;在2x128下DC与泄漏解耦,证明存在第二条非DC吸收路径。
- DC惩罚不影响拟合,ifl2则显著影响: dc=1e-2的MSE几乎无变化(0.0041 vs 0.0047),而ifl2=1e-2导致MSE增加30-64%。
- 容量替代去相关惩罚实现重复控制: 位移重复核对数量从1x32的8.0降至2x128的0.5,且拟合质量改善;每基序恢复在1x32和2x128下均为10.00/10。
模型与超参数(生成参数)
- 模型: FactorizedNBM,32个11长度卷积滤波器,阶数[1,2],二阶在epoch 50激活
- 优化: lr 0.001,plateau调度,batch size 128,损失函数MSE
- 固定惩罚: 特征NN权重L2 1e-4,卷积核L2 1e-4,输出L2 1e-3,交互核平滑惩罚1e-4,交互dropout 0.1
- 扫描超参数:
interaction_feature_l2_penalty(2个值)、interaction_context_dc_penalty(3-4个值)、filter_transform容量(3种组合)、种子(4个) - 输入数据: 20260713_fo_no_noise(十基序,纯一阶,无噪声)
数据加载方式
python from datasets import load_dataset dataset = load_dataset("arushram/fnbm-current-cocktail-dc-capacity-20260726", split="train")