vispeech-whisper-features
收藏资源简介:
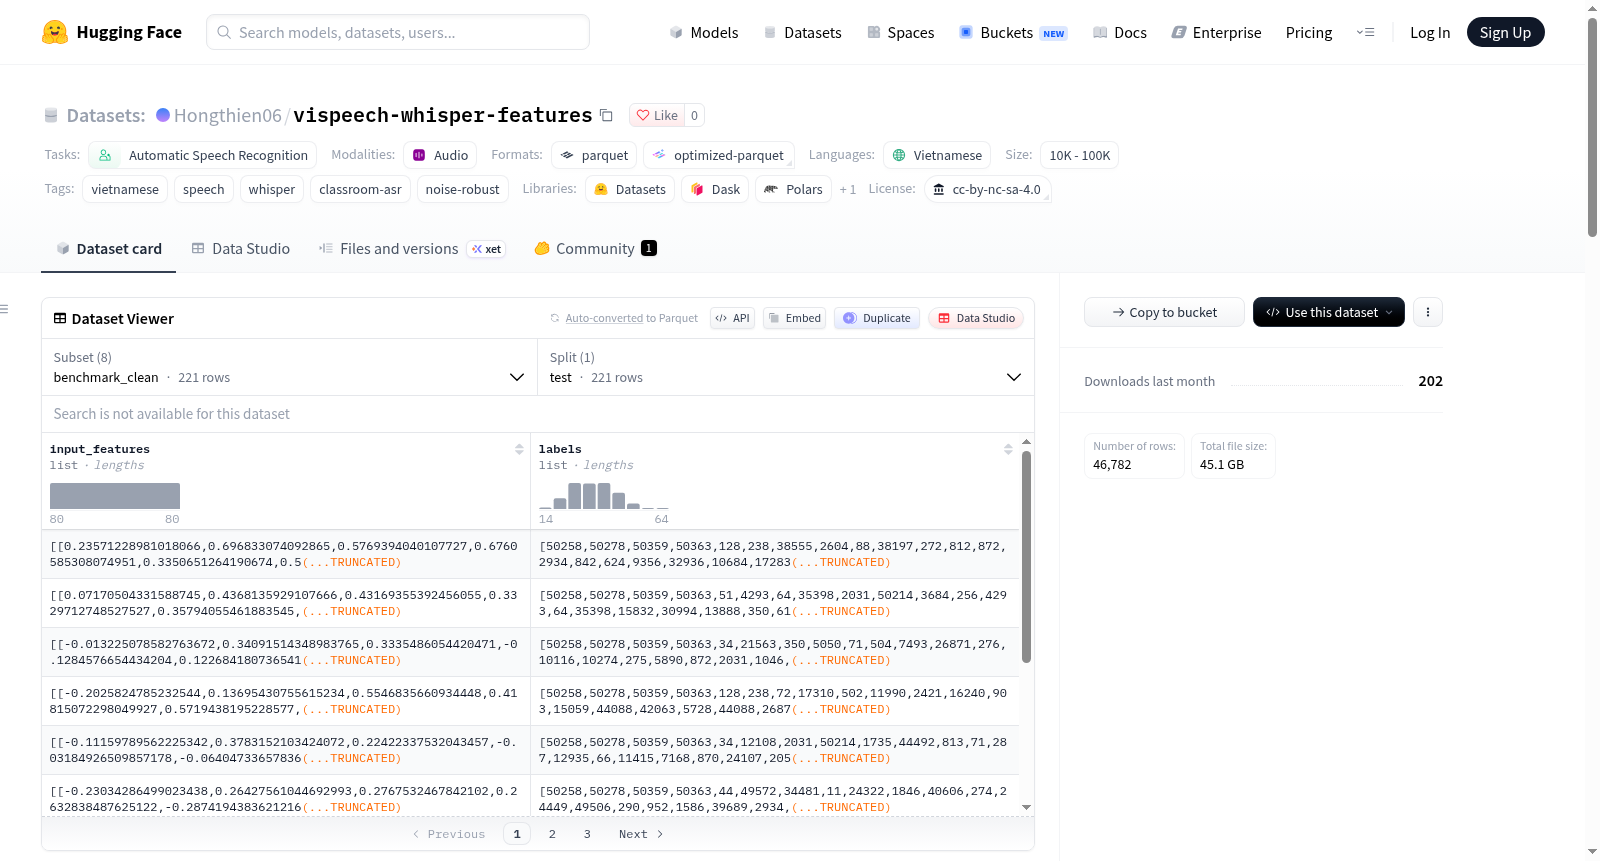
ViSpeech是一个面向噪声鲁棒课堂自动语音识别(ASR)的多条件越南语音数据集。本版本提供了经过Whisper-small特征提取器预处理的log-mel谱图特征(input_features)和经过Whisper-small分词器处理的标签token ID(labels),不包含原始音频。数据集总时长37.62小时,采用配对录制设计(同一说话者在安静房间和真实课堂条件下朗读相同脚本),包含36.50小时的噪声增强训练语料、1.12小时的保留验证集以及一个独立收集的221条真实噪声课堂基准测试集。具体配置包括:p1、p2、p3分别对应课程学习训练的三个阶段(训练集),ev为验证集,ev_noisy_snr10/15/20为添加不同信噪比噪声的测试集,benchmark_clean为真实噪声课堂基准测试集(经标签审计移除一条误标话语)。本数据集仅供非商业研究使用,遵循CC BY-NC-SA 4.0许可,部分内容衍生于VIVOS数据集。
ViSpeech is a multi-condition Vietnamese speech dataset for noise-robust classroom automatic speech recognition (ASR). This version provides log-mel spectrogram features (input_features) preprocessed by Whisper-small feature extractor and label token IDs (labels) processed by Whisper-small tokenizer, without original audio. The total duration is 37.62 hours, with a paired recording design (the same speaker reads the same script in a quiet room and real classroom conditions). It includes 36.50 hours of noise-augmented training data, 1.12 hours of reserved validation set, and an independently collected benchmark test set of 221 real noisy classroom utterances. Specific configurations include: p1, p2, p3 corresponding to three stages of curriculum learning (training sets), ev as the validation set, ev_noisy_snr10/15/20 as test sets with different signal-to-noise ratios, and benchmark_clean as the real noisy classroom benchmark test set (with one mislabeled utterance removed after label auditing). This dataset is for non-commercial research only, licensed under CC BY-NC-SA 4.0, with partial content derived from the VIVOS dataset.
ViSpeech (Whisper-small preprocessed features) 数据集总结
基本信息
- 数据集地址:https://huggingface.co/datasets/Hongthien06/vispeech-whisper-features
- 许可证:CC BY-NC-SA 4.0(非商业性、相同方式共享)
- 语言:越南语(vi)
- 任务类别:自动语音识别(automatic-speech-recognition)
- 标签:vietnamese、speech、whisper、classroom-asr、noise-robust
- 别名:ViSpeech (Whisper-small preprocessed features)
数据集简介
本仓库包含论文《ViSpeech: A Multi-Condition Vietnamese Speech Dataset for Noise-Robust Classroom ASR》(T. D. Tran 等,FISAT 2026,Springer)所使用的预processed特征集。
ViSpeech 是一个 37.62 小时的多条件越南语语音语料库,基于配对录音设计构建——相同的说话者在安静房间和真实教室两种条件下朗读相同脚本,包含 36.50 小时的噪声增强训练语料、1.12 小时的留出验证集,以及独立采集的 221 条真实噪声教室基准。
格式说明
- 本数据集不是原始音频文件。
- 每个样本包含:
input_features:由openai/whisper-small特征提取器生成的 log-mel 频谱图;labels:由openai/whisper-small分词器生成的目标 token ID。
- 本发布版本用于使用 Whisper-small 精确复现论文的训练与评估流程。转录文本可通过 Whisper 分词器解码
labels恢复;原始波形无法从 log-mel 特征中恢复。
配置(Configurations)
| 配置 | 划分 | 描述 |
|---|---|---|
p1 |
train | 课程学习第 1 阶段训练语料 |
p2 |
train | 课程学习第 2 阶段训练语料 |
p3 |
train | 课程学习第 3 阶段训练语料 |
ev |
validation | 留出验证集(1.12 小时) |
ev_noisy_snr10 |
test | 添加 10 dB SNR 噪声的验证集 |
ev_noisy_snr15 |
test | 添加 15 dB SNR 噪声的验证集 |
ev_noisy_snr20 |
test | 添加 20 dB SNR 噪声的验证集 |
benchmark_clean |
test | 221 条真实噪声教室基准(标签审核时移除一条误标注样本) |
各配置数据规模
| 配置 | 划分 | 样本数 | 数据大小(字节) | 下载大小(字节) |
|---|---|---|---|---|
benchmark_clean |
test | 221 | 212,296,239 | 212,341,777 |
ev |
validation | 1,036 | 995,111,080 | 995,356,312 |
ev_noisy_snr10 |
test | 1,036 | 995,111,080 | 995,356,312 |
ev_noisy_snr15 |
test | 1,036 | 995,111,080 | 995,356,312 |
ev_noisy_snr20 |
test | 1,036 | 995,111,080 | 995,356,312 |
p1 |
train | 11,660 | 11,199,970,288 | 11,202,731,687 |
p2 |
train | 2,479 | 2,381,323,256 | 2,381,911,295 |
p3 |
train | 28,278 | 27,162,587,088 | 27,169,281,913 |
特征结构
所有配置的样本特征一致:
input_features:嵌套的 float32 列表(log-mel 频谱图)labels:int64 列表(目标 token ID)
使用方式
python from datasets import load_dataset from transformers import WhisperTokenizer
ds = load_dataset("Hongthien06/vispeech-whisper-features", "benchmark_clean", split="test")
从 labels 解码转录文本
tok = WhisperTokenizer.from_pretrained("openai/whisper-small", language="vi", task="transcribe") text = tok.decode([t for t in ds[0]["labels"] if t >= 0], skip_special_tokens=True)
数据文件路径
| 配置 | 划分 | 路径 |
|---|---|---|
benchmark_clean |
test | benchmark_clean/test-* |
ev |
validation | ev/validation-* |
ev_noisy_snr10 |
test | ev_noisy_snr10/test-* |
ev_noisy_snr15 |
test | ev_noisy_snr15/test-* |
ev_noisy_snr20 |
test | ev_noisy_snr20/test-* |
p1 |
train | p1/train-* |
p2 |
train | p2/train-* |
p3 |
train | p3/train-* |
许可与署名
- 采用 CC BY-NC-SA 4.0 许可发布(非商业性、相同方式共享)。
- 语料库部分源自 VIVOS(AILAB, VNUHCM — University of Science),该数据集以 CC BY-NC-SA 4.0 许可仅用于研究目的:https://huggingface.co/datasets/AILAB-VNUHCM/vivos。对 VIVOS 衍生部分应用的修改包括 DSP 预处理和加性噪声(AWGN)增强。源许可的 ShareAlike 条件通过以相同许可发布整个语料库得以保留。
- 依据 VIVOS 使用条款,本数据集用户同意不尝试确定语料库中任何说话者的身份。
伦理与同意
- 教室录音在获得说话者口头同意(录音、研究使用和公开发布)以及主管讲师许可的情况下采集。
- 转录文本不包含学校名称;可能出现的个人姓名已获得相关个人同意。
- 文件名和元数据不包含任何可识别信息。
引用
bibtex @inproceedings{tran2026vispeech, title = {ViSpeech: A Multi-Condition Vietnamese Speech Dataset for Noise-Robust Classroom ASR}, author = {Tran, Thi Dung and Pham, Thi Ngoc Oanh and Vo, Hong Thien and Nguyen, Huy Khang and Tran, Nhat Long and Tran, Duc Anh}, booktitle = {Proceedings of FISAT 2026}, publisher = {Springer}, year = {2026} }