
amalia-llm/POPE-PT
收藏官方服务:
资源简介:
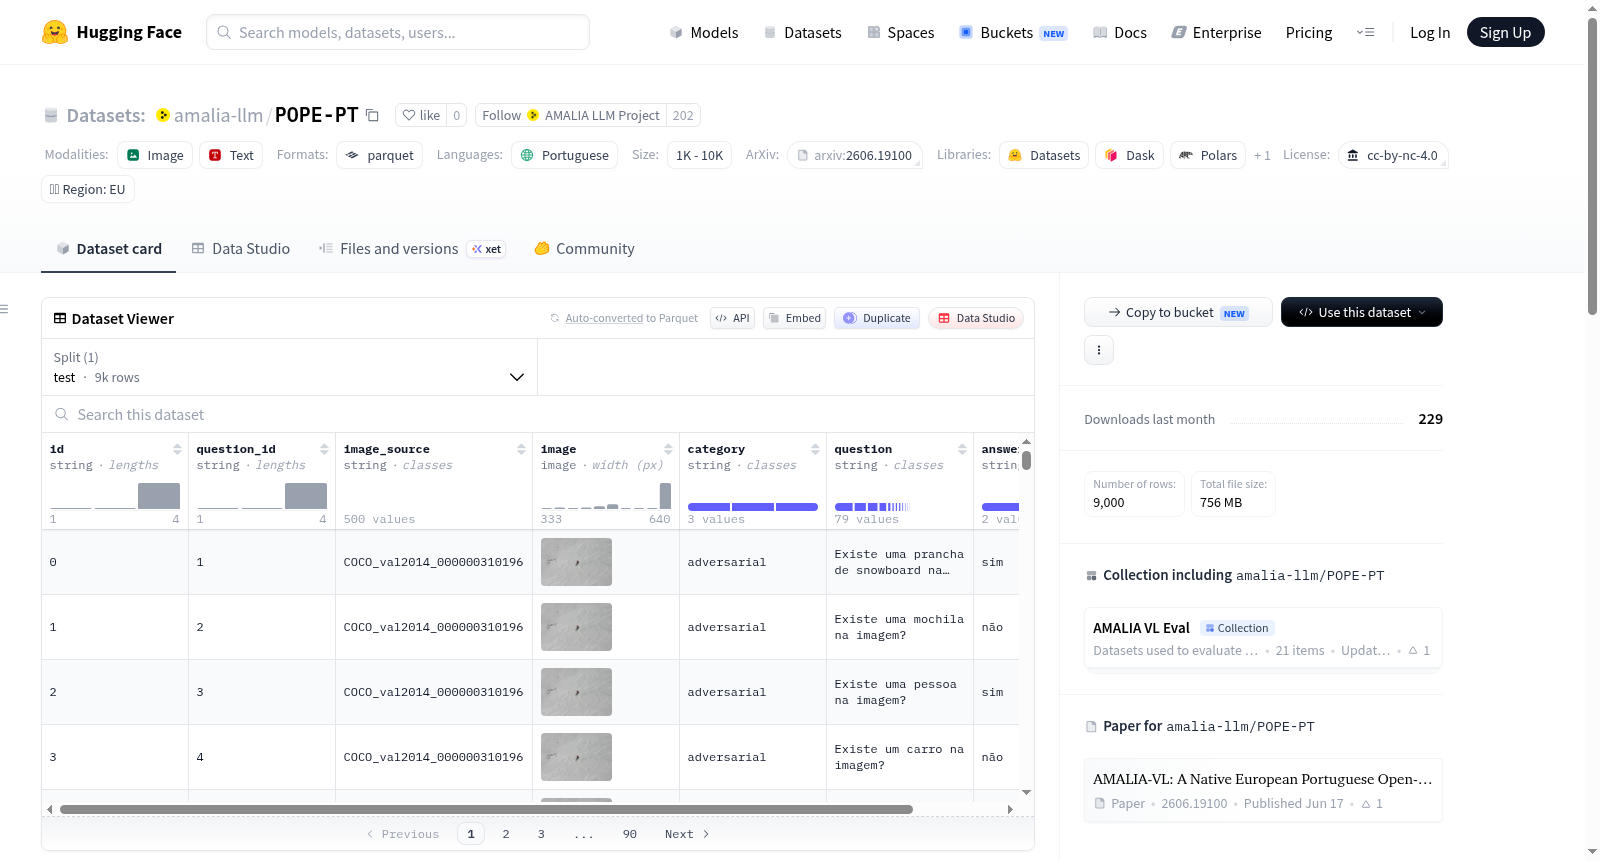
欧洲葡萄牙语(pt-PT)的机器翻译版本,源自POPE基准测试,用于通过是/否轮询问题评估视觉语言模型中的物体幻觉。
European Portuguese (pt-PT) machine translation of POPE, a benchmark for evaluating object hallucination in vision-language models through yes/no polling questions.
提供机构:
amalia-llm搜集汇总
数据集介绍
构建方式
POPE-PT数据集源自广泛用于评估视觉语言模型对象幻觉现象的POPE基准测试,其核心构建方式是将原始英文测试集中的是非题(yes/no polling questions)通过gemini-3.1-pro模型全自动翻译为欧洲葡萄牙语(pt-PT)。该翻译过程严格保留了原始数据的结构和字段,仅对文本内容进行语言转换,从而确保评估体系与原始基准测试在任务形式和难度上的一致性。
特点
该数据集共计包含9000个测试样本,每个样本均配备图像来源、图像数据、类别标签、问题及标准答案等结构化字段。作为欧洲葡萄牙语领域首个专门用于视觉语言模型幻觉评估的翻译数据集,POPE-PT填补了该语言在模型鲁棒性评测方面的空白,其与原始POPE基准的机械对应关系使得跨语言模型性能对比成为可能。
使用方法
使用者可直接从HuggingFace数据集库加载POPE-PT的默认配置(default),并通过'test'分割访问全部样本。数据集与AMALIA项目提供的amalia-vl-eval评估框架深度集成,支持一键化评估流程。值得注意的是,由于翻译内容采用CC-BY-NC-4.0许可,商业用途受限,且图像部分需遵守原始POPE数据集的许可证条款。
背景与挑战
背景概述
POPE-PT数据集诞生于2026年,由葡萄牙AMALIA项目团队基于原版POPE基准测试构建而成。该数据集聚焦于评估多模态大语言模型在欧式葡萄牙语环境下的物体幻觉现象,通过是非问答形式检验模型的视觉-语言对齐能力。作为AMALIA项目的重要组成部分,POPE-PT填补了高资源语言之外视觉语言评估领域的空白,为葡萄牙语社区的多模态模型研究提供了标准化的测试平台。其发布有助于推动多语言多模态人工智能的公平性发展,并对低资源语言场景下的模型可靠性研究产生深远影响。
当前挑战
POPE-PT面临的核心挑战在于解决多模态大语言模型中的物体幻觉问题,即模型在描述图像时生成与实际内容不符的物体,严重制约了其在安全攸关场景中的应用。数据集构建过程中,需将原版POPE的英文测试集精准翻译为欧式葡萄牙语,依赖机器翻译引擎(gemini-3.1-pro)可能引入语义失真或文化特定表达误差,从而影响评估的保真度。此外,确保翻译后的问答对在不同视觉上下文中保持逻辑一致性,并平衡正负样本分布以避免偏差,亦是构建流程中的关键难点。
常用场景
经典使用场景
POPE-PT 作为 POPE 基准的葡萄牙语译版,经典用途在于评估多模态大语言模型在处理欧式葡萄牙语问答时是否存在物体幻觉现象。该数据集通过结构化的 yes/no 轮询问题,要求模型判断图像中特定物体的存在与否,从而系统性地度量模型在跨语言视觉推理中的忠实度。其设计巧妙地将物体存在性判断转化为二元分类任务,使得研究人员能够精确捕捉模型在语言与视觉信息结合过程中产生的虚假关联或错误表述。尤其对于葡萄牙语社区的研究者而言,这一数据集填补了非英语环境下视觉语言模型幻觉评估的空白,为开发更鲁棒的多语言视觉模型提供了标准化的校验工具。
解决学术问题
POPE-PT 精准解决了非英语语言环境下视觉语言模型物体幻觉评估缺失的学术困境。长期以来,物体幻觉检测基准几乎完全集中于英语,导致多语言模型在非英语场景中的误导性响应难以被有效量化。该数据集通过提供高质量的葡萄牙语翻译,使得研究者能够探明当前视觉语言模型在跨语言迁移时是否产生新的幻觉模式,或原有幻觉问题在语言转换后是否恶化。这一工作深化了对视觉语言模型中语言偏差与视觉信息融合机制的理解,推动了模型评估从单语言向多语言范式的演进,对构建真正多语言、多文化的可信人工智能系统具有重要的方法论意义和普世价值。
衍生相关工作
POPE-PT 的发布衍生了一系列围绕多语言视觉幻觉检测与模型对齐的研究工作。基于 AMALIA 项目框架,研究者利用该数据集系统评估了多个主流多模态模型在葡萄牙语上的幻觉表现,并据此开发了针对性的去幻觉微调策略。此外,POPE-PT 启发了类似基准的法语、西班牙语等低资源语言翻译版本的出现,推动了跨语言视觉幻觉评估基准谱系的构建。相关工作还探索了利用该数据集进行对抗性样本生成,以分析模型在葡萄牙语修饰下对物体关系的错误推理。这些衍生研究共同揭示了视觉语言模型在面对非英语语言时幻觉模式的多样性,为开发更鲁棒的多模态对数据训练方法提供了宝贵的实证基础。
以上内容由遇见数据集搜集并总结生成


