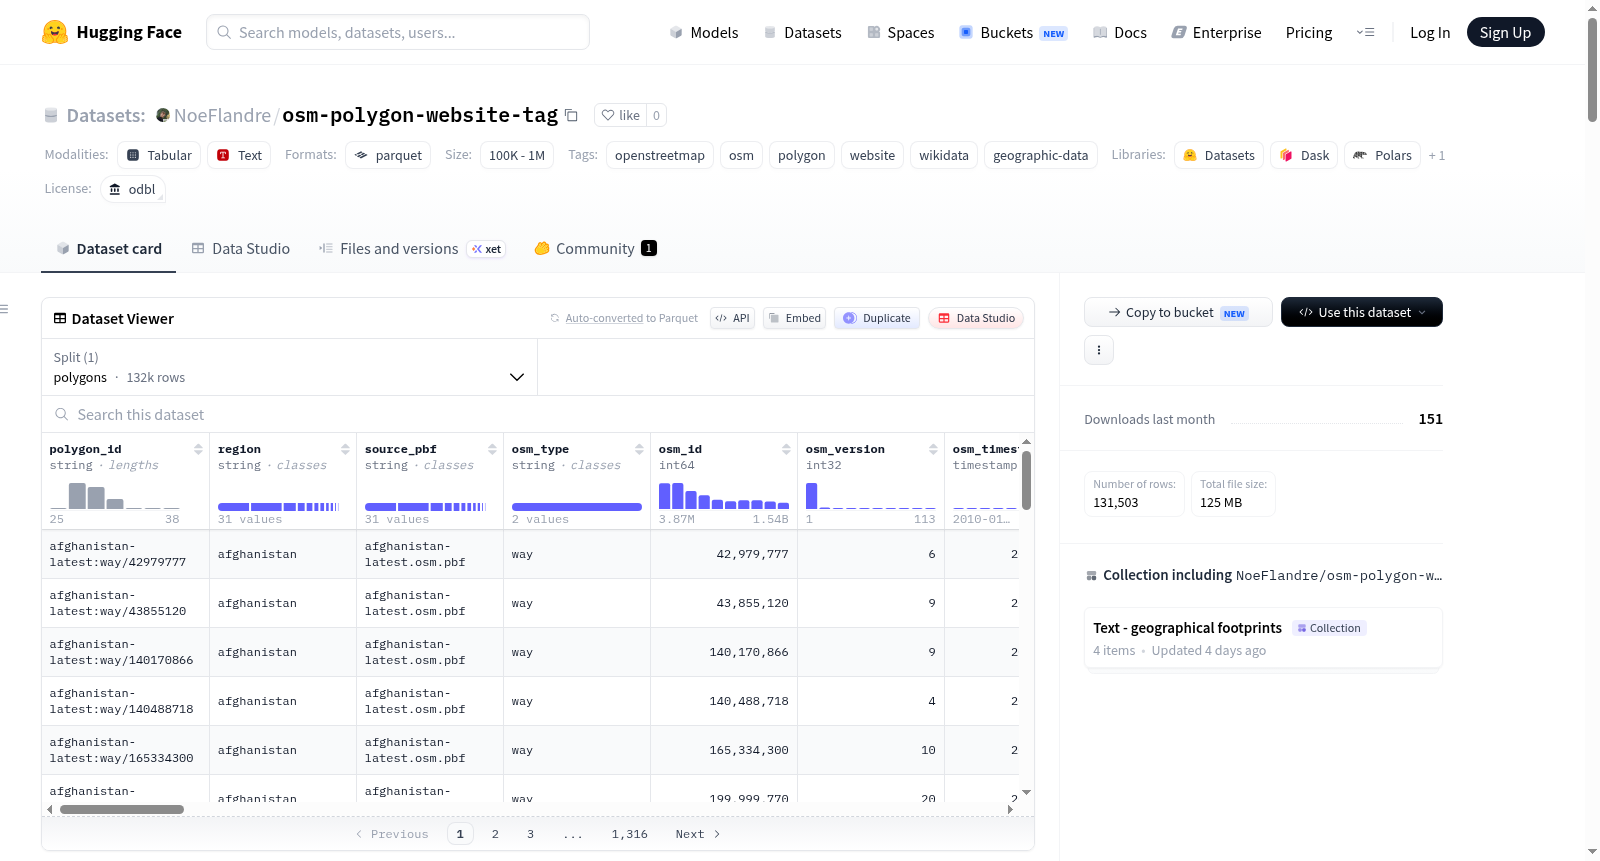
osm-polygon-website-tag
收藏资源简介:
OSM Polygon Website Dataset 是一个基于 OpenStreetMap(OSM)数据构建的地理数据集,专门收集了携带非空 website 或 contact:website 标签的闭合路径(closed ways)和面关系(polygon relations),并利用 Trafilatura 工具提取了这些网站的主页全文文本。该数据集旨在支持与 OSM 多边形对象相关的网站信息分析、地理数据质量评估、文本挖掘等研究与应用。
OSM Polygon Website Dataset is a geographic dataset built from OpenStreetMap (OSM) data, specifically collecting closed ways and polygon relations with non-empty `website` or `contact:website` tags, and extracting full-text content of these websites using Trafilatura. This dataset aims to support research and applications such as website information analysis of OSM polygon objects, geographic data quality assessment, and text mining.
数据集概述
OSM Polygon Website Dataset 是一个地理空间数据集,聚焦于携带非空 website 或 contact:website 标签的 OpenStreetMap(OSM)闭合路径与多边形关系。该数据集使用 Trafilatura 提取了每个多边形对应网站的完整主页文本,并包含丰富的派生统计信息与几何属性。
数据集规模与状态
| 指标 | 数值 |
|---|---|
| 数据集状态 | 进行中 |
| 来源 PBF 文件数 | 32 / 386 |
| 公开多边形数 | 131,503 |
| 规范多边形数 | 0 |
| 比较观测数 | 211,313 |
| 重复观测数 | 0 |
| 冲突快照数 | 0 |
| 几何拒绝数 | 64,969,633 |
网站文本提取统计
| 标签 | URL 数 | 成功数 | 空文本数 | 失败数 | 总词数 |
|---|---|---|---|---|---|
website |
56,530 | 37,789 | 2,571 | 16,170 | 12,158,503 |
contact:website |
6,061 | 4,170 | 570 | 1,321 | 1,383,431 |
- 已提取文本的多边形数:41,721
- 合并提取总词数:13,541,934
地理分布
H3 分辨率 3 下,131,503 个多边形质心覆盖了 1,139 个占用单元。颜色尺度为对数,计数为绝对值,背景使用 Natural Earth 1:110m 陆地数据提供地理上下文。
数据集内容
polygons/*.parquet:公开多边形分片,每个来源 PBF 对应一个分片。analysis/*.parquet:详细的重叠、来源、主机名、重复、冲突及按来源的统计数据。manifests/:来源清单、上传检查点及完成回执。
公开多边形模式(核心字段)
| 字段 | 类型 | 可空 | 描述 |
|---|---|---|---|
polygon_id |
string | 否 | 确定性来源作用域标识符,格式为 <source-stem>:<osm_type>/<osm_id>。 |
region |
string | 否 | 从来源 PBF 文件名(Geofabrik 约定)推导的人类可读区域标签。 |
osm_type |
string | 否 | "way" 表示闭合多边形路径,"relation" 表示组装的多边形或边界关系。 |
osm_id |
int64 | 否 | OSM 对象原始数字标识符,路径与关系命名空间保持区分。 |
website |
string | 是 | 修剪后的原始 website 标签值,标签缺失或仅为空白时为 None。 |
contact_website |
string | 是 | 修剪后的原始 contact:website 标签值,缺失时可为 None。 |
website_class |
string | 是 | website 值的离散分类,标签缺失时为 None。 |
website_hostname |
string | 是 | 从 website 提取的小写主机名,无法解析时为 None。 |
tags |
string | 否 | 包含源 OSM 对象所有标签的确定性 JSON 对象,键排序。 |
osm_primary_tag |
string | 否 | 主要 OSM 类别键,优先级列表包括 boundary > building > amenity 等,无识别键时为 other。 |
geometry |
string | 否 | WGS84 下的确定性 GeoJSON Polygon 或 MultiPolygon,坐标四舍五入至七位小数。 |
centroid |
string | 否 | WGS84 下的确定性 GeoJSON Point 质心。 |
lat / lon |
double | 否 | 质心纬度和经度(WGS84 十进制),四舍五入至七位小数。 |
bbox |
string | 否 | 确定性 JSON 数组 [min_lon, min_lat, max_lon, max_lat]。 |
area_m2 |
double | 否 | WGS84 椭球体上的多边形面积(平方米),始终有限且非负。 |
area_bucket |
string | 否 | 粗略面积分桶,如 <10m2、10-100m2、100m2-1km2 等。 |
website_text |
large_string | 是 | 从 website 提取的完整主页文本,提取失败时为 null。 |
website_word_count |
int64 | 是 | website_text 中的词数,无文本时为 null。 |
website_text_status |
string | 否 | 网站文本富集状态,使用固定的冻结词汇。 |
contact_website_text |
large_string | 是 | 独立从 contact:website 提取的完整主页文本。 |
contact_website_text_status |
string | 否 | 联系网站文本富集状态。 |
方法论与质量
- 几何使用 libosmium 组装。
- 两个网站标签的完整主页文本均使用 Trafilatura 独立提取,不进行截断。
- 词数通过 Python Unicode
w+匹配计算。 - 文本状态包括
absent、pending、success、empty、invalid_url、unsafe_url、fetch_error、extract_error;失败值会在后续恢复时重试,成功值会被缓存。 - 来源文件名、字节大小及纳秒级修改时间在处理前记录;完成回执按相对路径、字节大小和 SHA-256 绑定最终产物。
来源与许可证
- 数据基于 OpenStreetMap 数据,遵循 Open Database License (ODbL) 1.0;版权归 OSM 贡献者所有,详见 OpenStreetMap 版权与署名页面。
- 区域 PBF 提取由 Geofabrik 提供。
- 地图背景使用 Natural Earth 1:110m Admin-0 国家地理数据,按公共领域条款分发。