Last Translation Benchmark
收藏资源简介:
Last Translation Benchmark(LTB)是由苏黎世联邦理工学院等多家机构联合创建的大型挑战性基准数据集,旨在暴露当前最先进机器翻译模型的失败案例。数据集包含3456条人工撰写并经同行评审的困难翻译输入,覆盖109种语言,并集成文本、图像、音频和视频多模态形式,每条示例均配有手工设计的验证规则。创建过程采用众包方式,由244位贡献者提交,经同行评审确保质量,并持续接受新贡献。该数据集应用于机器翻译评测领域,旨在提供可靠、可重复且可解释的评估方法,突破静态基准饱和局限,推动翻译模型持续进步。
Last Translation Benchmark (LTB) is a large-scale challenging benchmark dataset jointly created by ETH Zurich and multiple other institutions, aiming to expose failure cases of current state-of-the-art machine translation models. It comprises 3456 manually authored and peer-reviewed challenging translation inputs spanning 109 languages, and integrates multimodal content including text, images, audio and video. Each instance is paired with manually crafted validation rules. The dataset was developed via a crowdsourcing workflow, with submissions from 244 contributors; its quality was rigorously ensured through peer review, and it continues to accept new contributions. This dataset is applied in the field of machine translation evaluation, aiming to provide a reliable, reproducible and interpretable evaluation paradigm, break through the saturation bottleneck of static benchmarks, and drive the continuous advancement of translation models.
Last Translation Benchmark 数据集详情
数据集概览
- 名称:Last Translation Benchmark (LTB)
- 最新版本:LTBv1(包含截至2026年9月1日前接受的贡献)
- 许可协议:CC-BY-4.0
- 数据集大小:1K < n < 10K(LTBv1包含3,456条难翻译示例)
- 任务类型:翻译、文本生成
- 核心特点:这是一个实时更新的数据集,接受社区贡献,旨在测试最先进机器翻译模型的极限
语言覆盖
数据集支持54种语言,包括英语、中文、德语、法语、西班牙语、日语、俄语、意大利语、葡萄牙语、荷兰语、波兰语、阿拉伯语、韩语、越南语、土耳其语、捷克语、瑞典语、乌克兰语、波斯语、印尼语、罗马尼亚语、加泰罗尼亚语、芬兰语、匈牙利语、丹麦语、挪威语、希伯来语、希腊语、泰语、印地语、斯洛伐克语、克罗地亚语、立陶宛语、爱沙尼亚语、孟加拉语、乌尔都语、泰米尔语、泰卢固语、马拉地语、白俄罗斯语、南非荷兰语、世界语、拉丁语、爪哇语、缅甸语、维吾尔语、坎纳达语、奥里亚语、阿萨姆语、豪萨语、约鲁巴语、库尔德语、梵语、卢森堡语、提格里尼亚语、罗曼什语、林堡语、沃拉普克语等。
数据集内容
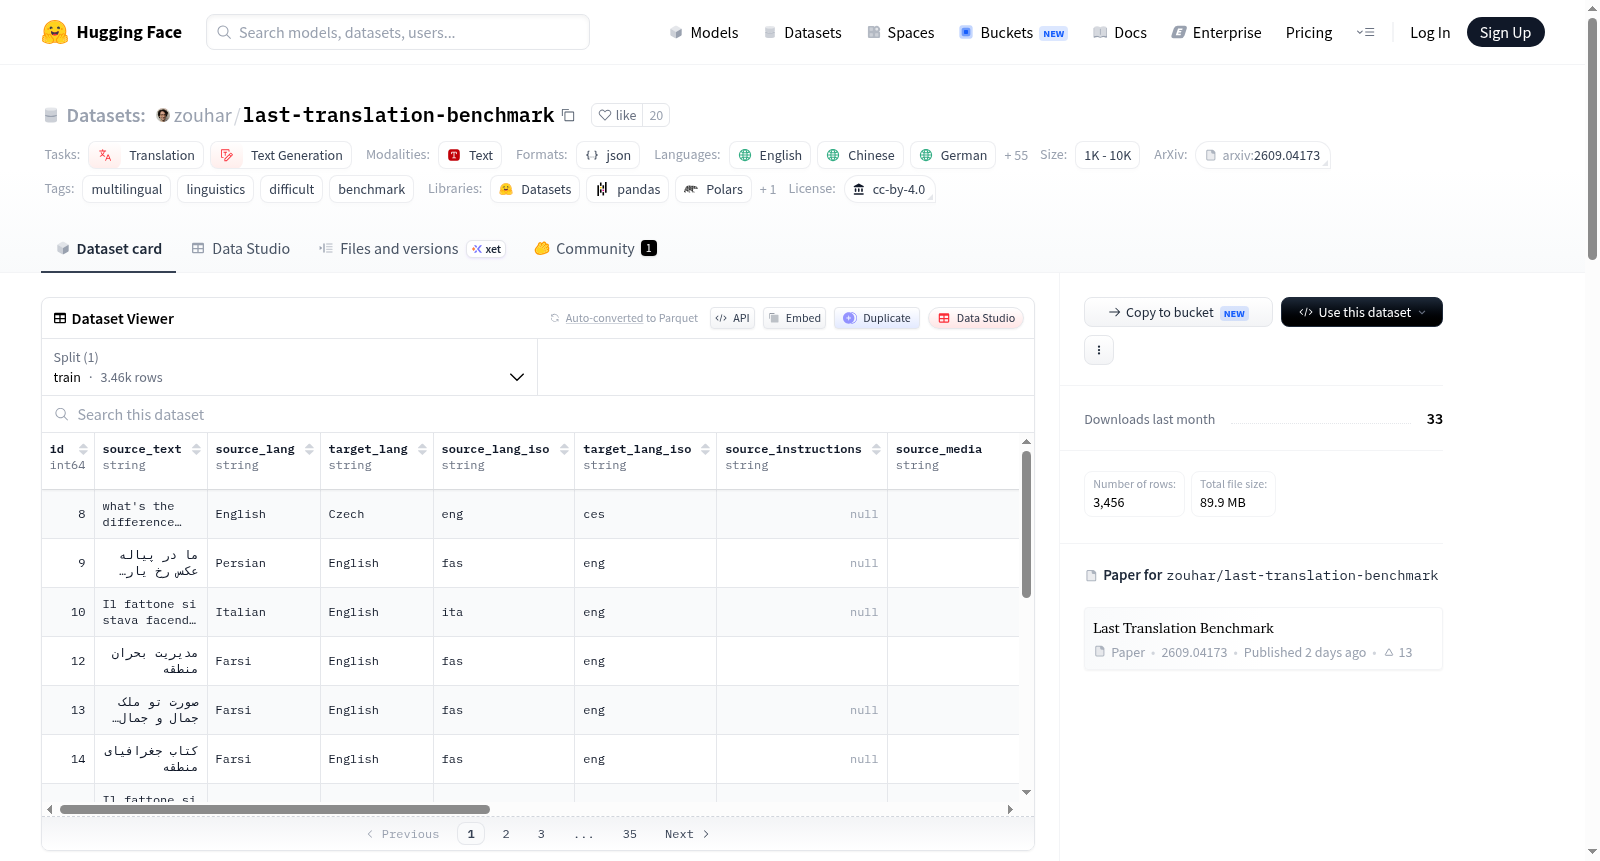
每个示例包含以下字段:
- source:输入文本
- source_lang, target_lang:人类可读的语言名称
- source_lang_iso, target_lang_iso:ISO639-3语言代码(若存在)
- source_instructions:特殊翻译指令(可选)
- source_media:图像、音频和视频(Base64编码字符串,可选)
- verification_rules:翻译需要满足的验证规则列表(一条或多条)
- translations:人类和现有模型的翻译列表,并包含是否通过验证规则的信息
- linguistics:导致翻译困难的语言学标注
- attribution:创建该示例所依据资源的链接
- tags:所属子集(
LTBv1为全部,LTBv1-text为纯文本,LTBv1-micro为微型纯文本)
数据集特点
- 包含人类撰写且经同行评审的示例(文本、图像、音频、视频)
- 每个示例配有手工制定的验证规则,用于可靠、客观地评估任何未来翻译
- 示例来源多样,涵盖多种语言对,专门打破最先进的机器翻译模型
- 创新性地解决了当前机器翻译基准测试中存在的琐碎化或不真实化问题
数据示例
数据集提供了JSON格式的示例,展示英译德任务中人类与多个模型(Google Translate、Gemini 3.1 Pro、Gemma 4等)的翻译对比及验证结果。
外部资源
- 论文:https://arxiv.org/abs/2609.04173
- 贡献提交及模型排行榜:https://last-translation-benchmark.vilda.net/
- 排行榜结果:https://last-translation-benchmark.vilda.net/leaderboard-results
- 简单JSON格式数据:http://last-translation-benchmark.vilda.net/LTBv1.json
引用方式
数据集提供完整的BibTeX引用格式,作者列表过长时可截断或使用author={LTB}代替。