
遇见数据集

tahoebio/EmeraldBay

收藏
Hugging Face2026-06-05 更新2026-06-14 收录
官方服务:

资源简介:

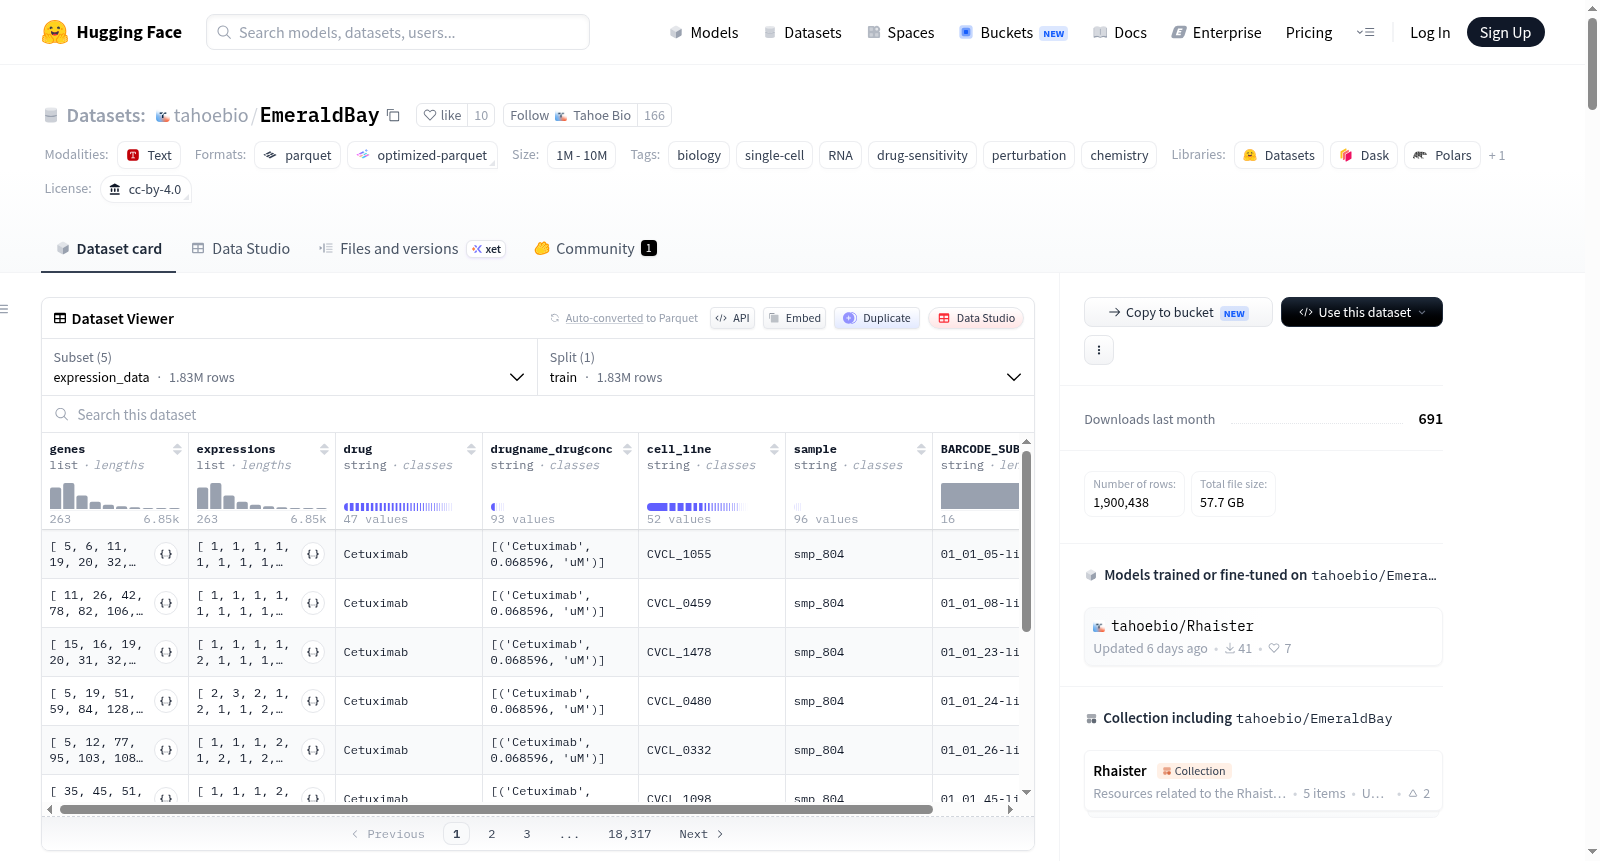
Emerald Bay是一个单细胞扰动数据集,包含超过180万个转录组图谱,涵盖52个细胞系和91种药物处理(包括组合处理)。该数据集使用Tahoe Therapeutics的MOSAIC高通量平台生成,包含一组经过筛选的抗癌药物,在优化用于五天培养的MOSAIC肿瘤池中以多个剂量应用。数据集提供两种读数:单细胞分辨率的转录组图谱和从五天终点细胞计数比例得出的药物表型测量。数据集包括多个表格:expression_data(主数据,原始计数)、gene_metadata(基因元数据,映射基因到整数令牌ID)、cell_line_metadata(细胞系元数据,包含驱动突变注释)、drug_metadata(药物元数据,包含药物目标、机制等信息)和summary_statistics(汇总统计,包含每个细胞系和条件的生长率统计)。数据规模为1M到10M之间,适用于生物学、单细胞、RNA、药物敏感性和扰动研究。

Emerald Bay is a single-cell perturbation dataset of over 1.8M transcriptomic profiles spanning 52 cell lines and 91 drug treatments, including combinations. Generated using Tahoe Therapeuticss MOSAIC high-throughput platform, it comprises a curated set of anticancer agents applied at multiple doses across a MOSAIC tumor pool optimized for five-day culture. The dataset provides two readouts: a transcriptional profile at single-cell resolution and a drug-phenotype measure derived from cell-count proportions at the five-day endpoint. It includes multiple tables: expression_data (main data with raw counts), gene_metadata (gene metadata mapping genes to integer token IDs), cell_line_metadata (cell line metadata with driver-mutation annotations), drug_metadata (drug metadata with targets, mechanisms, etc.), and summary_statistics (summary statistics with growth-rate per cell line and condition). The size category is 1M to 10M, and it is tagged for biology, single-cell, RNA, drug-sensitivity, and perturbation research.
提供机构:
tahoebio
搜集汇总
数据集介绍
tahoebio/EmeraldBay 数据集图片
构建方式
EmeraldBay数据集基于Tahoe Therapeutics的MOSAIC高通量平台构建,系统性地收集了超过180万个单细胞转录组图谱,涵盖52种癌细胞系和91种药物处理(包括联合用药方案)。研究者将精选的抗癌药物以多个剂量梯度施加于优化培养五天的MOSAIC肿瘤池中,从而获取两种互补的生物学读数:单细胞分辨率的转录组特征与基于细胞计数比例的药物表型度量。数据以116个分片形式存储,每个条目代表一个细胞的完整转录信息。
特点
该数据集的核心特色在于其多维度整合的生物学信息架构。除了原始的基因表达计数矩阵外,还配套提供了基因元数据(涵盖Tahoe-100M词汇表之外的574个新增基因)、细胞系元数据(包含驱动突变注释)、药物元数据(包含靶点、作用机制及临床状态)以及生长率汇总统计表,构建了一个完整的药物扰动响应知识图谱。值得注意的是,药物元数据经过Claude辅助策划并通过MedChemExpress、ClinicalTrials.gov和PubChem等多源验证,确保了信息的准确性与可靠性。
使用方法
用户可通过HuggingFace Datasets库便捷加载数据,推荐采用流式模式(streaming=True)以避免完整下载。对于不同分析需求,数据集提供了五个独立配置项:主表达数据(expression_data)可直接转换为AnnData格式进行单细胞分析;基因、细胞系及药物的元数据表支持高效的关联查询;汇总统计表则适用于批量药物敏感性分析。配套的Jupyter Notebook教程提供了从数据加载、元数据关联到格式转换的完整工作流指引,用户可通过Colab直接运行示例。
背景与挑战
背景概述
EmeraldBay数据集由Tahoe Therapeutics团队于近年创建,依托其自主研发的MOSAIC高通量平台,生成了超过180万条单细胞转录组图谱,覆盖52种癌细胞系与91种药物处理(含联合用药方案)。该数据集聚焦于抗癌药物在单细胞分辨率下的转录扰动效应,同时整合了基于细胞计数比例的药物表型读数,为解析药物作用机制、筛选潜在靶点提供了前所未有的精细度。其核心研究问题在于揭示不同遗传背景的肿瘤细胞对药物扰动响应的异质性,尤其是联合用药策略下的协同或拮抗效应。作为首个大规模、多细胞系、多药物的单细胞扰动资源,EmeraldBay在精准肿瘤学、药物重定位及系统生物学领域具有里程碑意义,为构建预测性计算模型和验证生物学假说奠定了数据基石。
当前挑战
该数据集所解决的领域核心挑战在于,传统批量测序无法捕捉肿瘤微环境中单细胞层面的药物响应异质性,而现有单细胞数据集多局限于少数细胞系或单一药物。EmeraldBay通过设计涵盖52种遗传背景的癌细胞系与91种药物(含组合)的扰动矩阵,首次实现了对药物敏感性与耐药性的单细胞级系统表征。其构建过程中面临双重技术挑战:一是MOSAIC平台需在5天培养期内维持肿瘤细胞池的活性与多样性,同时整合多个剂量梯度以捕捉非线性响应;二是数据结构复杂,需统一170万个细胞的高维表达谱、细胞系驱动突变注释、药物结构及机制分类等多源异构元数据,并确保批次效应最小化与跨条件可比性。
常用场景
经典使用场景
EmeraldBay数据集作为单细胞层面药物扰动转录组学的瑰宝,在生命科学与精准医学交汇处开辟了全新研究范式。其核心使用场景在于系统解析抗癌药物对肿瘤细胞异质性的影响,通过涵盖52种细胞系、91种药物处理(含联合方案)及超过180万条单细胞转录组谱的庞大数据矩阵,研究者得以在单细胞分辨率下追踪药物诱导的基因表达动态变化。该数据集特别适用于探究同种药物在不同遗传背景细胞系中的差异化响应机制,揭示肿瘤耐药性产生的单细胞根源。此外,其提供的药物表型生长率指标与转录谱双模态信息,为构建药物敏感性预测模型、识别生物标志物以及理解药物协同作用提供了前所未有的数据基础与实验验证平台。
实际应用
EmeraldBay数据集在实际应用中展现出多元转化潜力,尤其在抗癌药物研发与精准医疗领域。制药企业可借助该数据集筛选具有特定遗传背景的敏感人群,加速药物适应症的精准定位;临床研究者通过对比不同细胞系对靶向药物的反应,能够优化联合用药方案并预测潜在耐药路径。此外,基于该数据构建的机器学习模型可直接应用于新化合物在多种肿瘤类型的疗效预测,大幅降低药物开发的试错成本。在生物技术产业中,MOSAIC平台产生的高保真数据为开发新一代单细胞分析方法、基因调控网络推断工具以及药物响应评分系统提供了标准化的训练和验证基准,推动了单细胞组学技术从实验室向临床应用的实质性跨越。
衍生相关工作
EmeraldBay数据集自发布以来已衍生出一系列具有深远影响的经典工作。首先,基于其庞大的基因表达矩阵和细致的药物注释,研究者开发了用于单细胞药物响应预测的深度生成模型,如结合变分自编码器的条件转录谱生成框架,实现了对未知药物组合效果的推算。其次,该数据集催生了针对药物扰动下细胞状态迁移的时序推断方法,通过整合转录组与生长率数据,构建了药物诱导的细胞命运决策图,显著推进了耐药演化过程的可视化分析。此外,基因调控网络推断领域亦受其滋养,涌现出融合药物结构信息与单细胞轨迹的因果推断算法。这些工作不仅验证了数据集的质量,更将其价值拓展至方法学创新与计算生物学前沿,形成了以数据驱动假设、以模型验证机制的研究闭环。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

