
遇见数据集

huggingface_time_2700_f78db8ee_model_registry

收藏
Hugging Face2026-08-24 更新2026-08-25 收录
官方服务:

资源简介:

该数据集由Lumina Analytics数据团队发布,包含亚马逊客户评论及其情感极性标签,专为文本分类任务重新打包。数据经过清洗和重新分割,源自上游公共语料库fancyzhx/amazon_polarity,原始来源为Xiang Zhang等人(NIPS 2015)的Amazon Review Polarity语料库。数据文件data.csv包含200个样本,每个样本有三个字段:label(情感极性标签)、title(评论标题)和text(评论文本)。许可证为Apache-2.0,允许商业使用,但需保留署名和许可证声明,并归属上游来源。

This dataset is released by the Lumina Analytics data team, containing Amazon customer reviews and their sentiment polarity labels, repackaged for text classification tasks. The data has been cleaned and re-split, sourced from the upstream public corpus fancyzhx/amazon_polarity, originally from the Amazon Review Polarity corpus by Xiang Zhang et al. (NIPS 2015). The data file data.csv contains 200 samples, each with three fields: label (sentiment polarity label), title (review title), and text (review text). The license is Apache-2.0, allowing commercial use with attribution and license notice, and attribution to the upstream source.

创建时间:
2026-08-16
原始信息汇总

数据集概述:Customer Review Polarity Corpus

本数据集由 Lumina Analytics 数据团队发布,是亚马逊客户评论的情感极性标注语料库,重新打包用于文本分类任务。


数据内容

  • 文件data.csv
  • 样本数量:200 条评论样本
  • 字段label(情感标签)、title(标题)、text(评论文本)

数据来源与声明

  • 上游来源fancyzhx/amazon_polarity(Hugging Face Hub)
  • 原始语料:源自 Xiang Zhang 等人(NIPS 2015)的 Amazon Review Polarity 语料库
  • 处理方式:文本内容保留自上游来源,仅重新划分和打包,未修改原文
  • 声明许可证:待定(需核实上游来源后方可最终确定)

许可证信息

  • 最终许可:Apache License 2.0
  • 商业使用:允许
  • 署名要求:必须保留 Apache-2.0 许可证声明,并注明上游来源(含原始语料作者与出处)
  • 限制:除 Apache-2.0 标准条款外无额外限制(如保留版权/署名声明,不暗示商标认可)
  • 审批状态:已批准使用,包括商业用途,但须满足署名要求

审计日期:2026-08-24
搜集汇总
数据集介绍
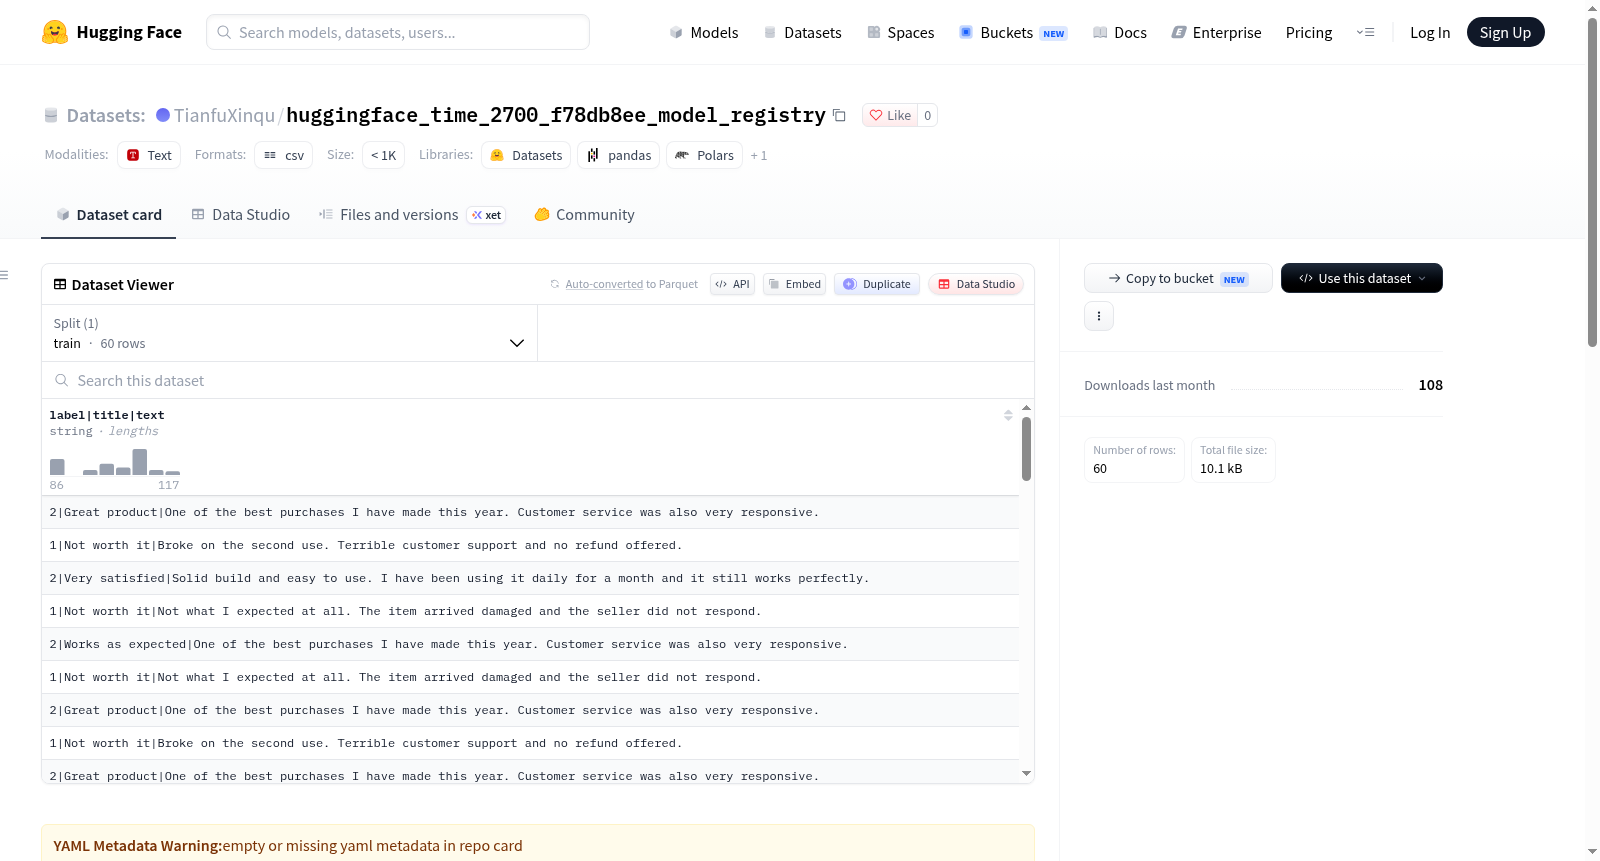
huggingface_time_2700_f78db8ee_model_registry 数据集图片
构建方式
该数据集系基于公开上游语料库的二次加工产物,由Lumina Analytics数据团队完成发布。其构建过程未对原始文本内容进行修改,仅对数据进行了清洗与重新划分,以适配文本分类任务的需求。具体而言,数据集源自fancyzhx/amazon_polarity仓库,该上游数据可追溯至Xiang Zhang等人于NIPS 2015提出的Amazon评论极性语料库。派生过程主要涉及数据格式的重新封装与采样,最终形成包含200条评论样本的data.csv文件,其中每个样本均标注了情感极性标签,并附有标题与正文文本字段。
特点
该数据集的核心特征在于其情感二分类属性,每条评论均被赋予明确的极性标签,适用于情感分析模型的训练与评估。数据集规模较小,仅含200条样本,便于快速实验与原型验证。字段设计简洁,包含label、title与text三列,兼容主流文本分类框架的输入格式。其文本内容完整保留自上游语料,避免了二次标注引入的偏差。此外,数据集遵循Apache-2.0许可协议,允许商业使用,但要求保留版权声明并注明上游来源,使用限制较为宽松。
使用方法
使用该数据集时,研究者可通过加载data.csv文件,直接读取label、title与text字段,将title与text拼接或分别作为输入特征,label作为目标变量,用于训练情感分类模型。由于数据规模有限,该数据集更适于方法验证、教学演示或基线测试,而非大规模模型训练。在实际应用中,建议结合交叉验证或与其他情感分析数据集联合使用,以提升模型泛化能力。使用时应遵守Apache-2.0许可条款,保留原始版权声明,并明确标注数据来源为fancyzhx/amazon_polarity及Xiang Zhang等人的原始工作。
背景与挑战
背景概述
面向情感分析任务的标注语料长期依赖大规模真实用户评论,Amazon评论极性语料即在此脉络中确立其地位。其上游出处为Xiang Zhang等学者于2015年神经信息处理系统大会(NIPS)发布的大规模评论文本集合,相关研究将评论文本按星级映射为二类情感极性,并系统比较了多种特征表示方法。该语料经Hugging Face Hub上fancyzhx/amazon_polarity仓库广泛传播,成为文本分类基准的常用资源。本数据集由Lumina Analytics数据团队二次整理与重新划分,保留原始文本内容,仅改变封装形式与样本规模,适用于轻量级情感分类实验与流程验证。
当前挑战
情感极性判别本身即面临跨领域语义漂移、讽刺与混合情感、星级与文本不一致等固有困难,评论标题与正文的短文本特性又加剧了上下文缺失问题。该数据集的构建亦受制于若干现实约束:上游许可状态一度未明,需经治理团队核验后确认为Apache-2.0;二次封装仅含200条样本,规模有限,难以支撑统计显著性的稳健评估;重新划分可能引入与原始训练集之间的分布偏移,影响结论可比性;样本抽样策略与标注质量均未在文档中详述,复现性与泛化性因此存在不确定性。
常用场景
经典使用场景
在情感分析与文本分类的研究中,该数据集通常被用于训练与评估二分类模型,其经典使用场景是借助评论标题与正文的联合表征来判别顾客评价的极性倾向。研究者常将数据划分为训练、验证与测试子集,并以准确率、F1值等指标衡量模型在正向与负向情感间的区分能力,从而为评论级情感分类提供可复现的基准。
衍生相关工作
围绕该数据集,衍生工作主要集中于基于预训练语言模型的评论情感分类微调、多字段融合的注意力机制设计,以及面向低资源场景的迁移学习与数据增强策略。这些工作进一步推动了亚马逊评论极性语料在可解释性、鲁棒性与跨域适应性方面的研究,并催生了若干以可审计数据来源为特色的公开基准与模型卡实践。
数据集最近研究
最新研究方向
在情感分析领域,基于亚马逊评论极性语料库的衍生数据集持续为文本分类研究提供基准支持。当前研究前沿聚焦于利用此类标注数据探索预训练语言模型在细粒度情感判别中的鲁棒性,以及跨域迁移学习中的领域适应问题。该数据集源自Zhang等人在NIPS 2015提出的Amazon Review Polarity语料,经Lumina Analytics团队重新清洗与划分后,以Apache-2.0许可发布,允许商业使用并需保留署名,这降低了学术与工业界的应用门槛。近期热点包括将此类极性数据用于大语言模型指令微调中的情感对齐评估,以及低资源场景下的少样本学习验证。其影响在于为可复现研究提供合规的衍生资源,推动情感分类在真实评论场景中的部署与公平性审计。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

