
unclickbait-synthetic-27b-trajectories
收藏官方服务:
资源简介:
该数据集名为“Unclickbait Synthetic 27B Trajectories”,是一个用于文本生成任务的合成轨迹数据集。数据由丰富的结构化 JSON 提示生成,并通过两阶段判断流水线进行验证。数据集包含两部分:一是完整的生成轨迹,当前快照包含 48,623 条记录(来自 152,369 个原始事件候选);二是 30 个基准测试样本,这些样本经过 122B 两阶段判断器(包含第一阶段完整性门控和第二阶段四维评分)的端到端审核。数据集语言为越南语,适用于去标题党(unclickbait)、思维链(Chain-of-Thought)等相关文本生成任务。许可证为 Apache-2.0。
创建时间:
2026-09-08
搜集汇总
数据集介绍
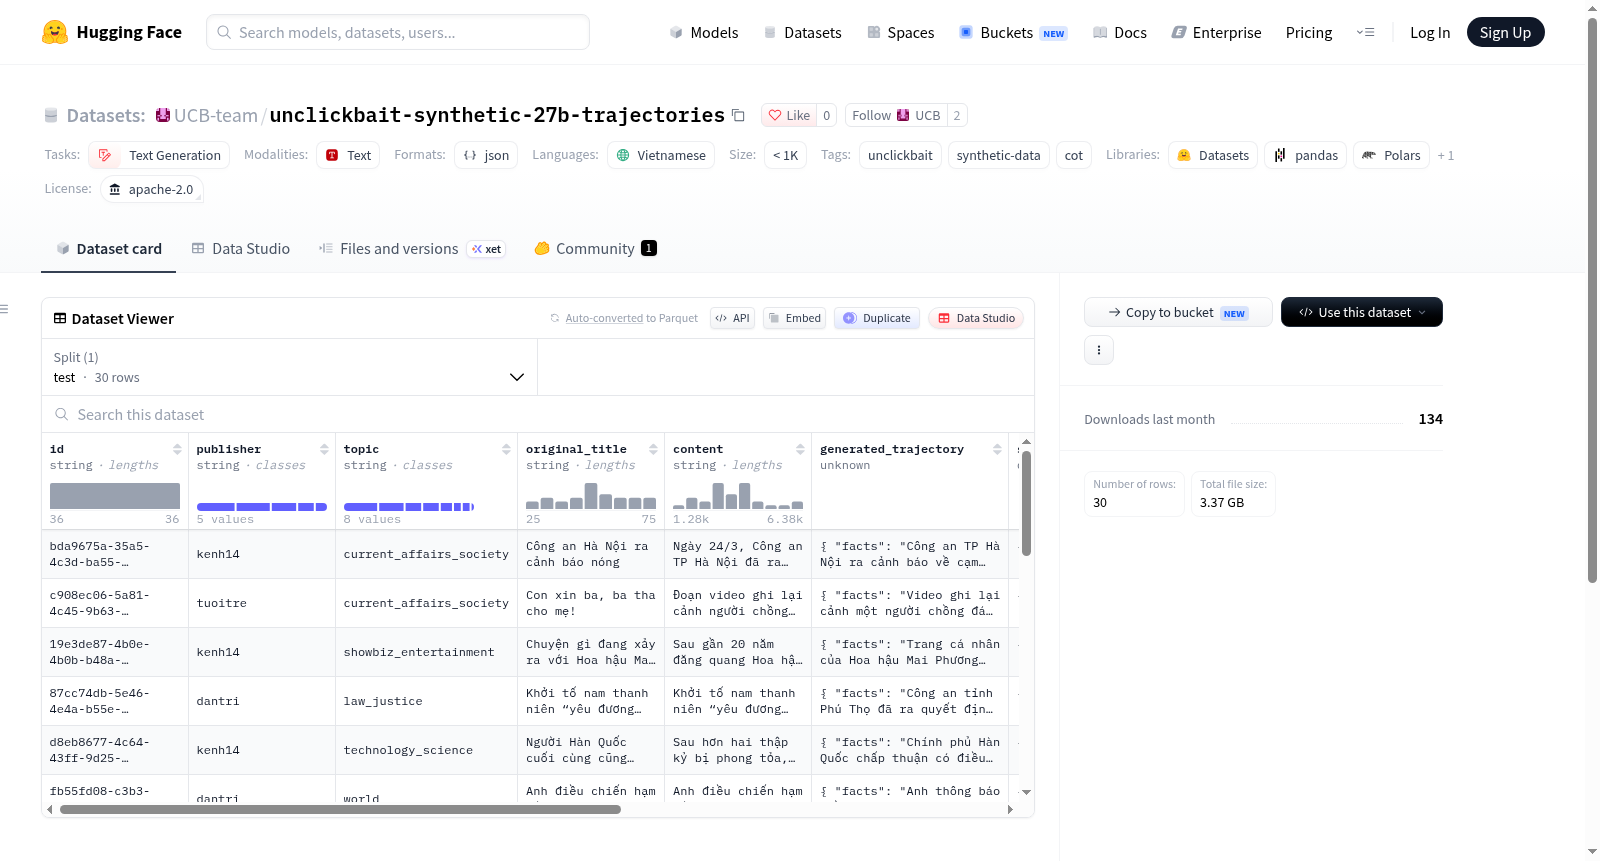
构建方式
在虚假信息与标题党泛滥的数字生态中,构建具备可解释性与可信度的合成数据成为缓解标注瓶颈的关键路径。该数据集以结构化JSON提示驱动大语言模型生成推理轨迹,每条轨迹对应一个原始事件候选,经由两阶段评判流水线进行质量筛选:第一阶段实施完整性门控,剔除逻辑断裂或信息缺失的样本;第二阶段从四个维度进行细粒度评分,最终保留48,623条优质轨迹。生成过程兼顾语言多样性与语义连贯性,确保合成数据在保持自然语言分布的同时,满足下游任务对推理链完整性的严格要求。
特点
该数据集的核心特质在于其轨迹级合成范式与严格的多阶段质控机制。相较于传统单轮问答或简单标签数据,其记录涵盖完整的思维链推理过程,能够为模型提供显式的中间推理步骤,增强生成结果的可追溯性。数据规模介于一万至十万条之间,当前快照包含48,623条轨迹,源自152,369个原始事件候选,筛选比例约为三成,体现出较高的质量门槛。语言方面以越南语为主,填补了低资源语言在反标题党与可信生成领域的数据空白,且附带30条经122B参数模型双阶段审计的基准测试样本,为评估提供可靠参照。
使用方法
使用该数据集时,研究者可将其作为文本生成任务的监督微调语料,尤其适用于训练模型识别并改写标题党内容、生成中性或事实性摘要。推理轨迹字段可直接用于思维链蒸馏,引导小规模模型习得逐步推理能力。基准测试样本可用于零样本或少样本评估,通过完整性门控与四维评分复现原始评判流程,量化模型输出的逻辑一致性与事实准确性。数据以JSON结构组织,便于按事件候选溯源与分片加载,支持在Hugging Face生态中直接调用datasets库进行流式读取或全量下载,适配从研究实验到生产部署的多层次需求。
背景与挑战
背景概述
在信息过载的数字时代,标题党现象严重侵蚀了内容生态的可信度,自动化解构并重写夸张标题成为自然语言生成领域的前沿课题。unclickbait-synthetic-27b-trajectories数据集于2024年由越南研究团队构建,旨在为越南语标题去夸张化任务提供大规模合成轨迹语料,其核心研究问题在于如何借助结构化提示与思维链推理,引导大语言模型生成忠实于原文信息且风格中立的替代标题。该数据集包含逾4.8万条生成轨迹,源自15万余条原始事件候选,并采用两阶段评判流水线进行质量审计,对低资源语言环境下的可控文本生成研究具有显著推动作用。
当前挑战
该数据集所应对的领域问题极具挑战性,标题去夸张化不仅要求模型精准识别夸张修辞与事实陈述的边界,还需在保持语义完整性的同时完成风格转换,避免信息遗漏或语义漂移。构建过程中,团队面临多维度困难:从海量原始事件中筛选高质量候选需耗费大量人力与计算资源;合成轨迹的生成依赖大模型推理,易引入事实幻觉或逻辑断裂;两阶段评判流水线虽能提升数据可信度,但四维评分标准的设计与校准需反复迭代,且当前快照仅覆盖约三分之一候选事件,数据规模与多样性仍待扩充。
常用场景
经典使用场景
在自然语言生成与虚假信息治理领域,该数据集凭借其由结构化JSON提示驱动、经两阶段评判流水线验证的合成轨迹,为构建反标题党(unclickbait)文本改写模型提供了高质量的监督信号。研究者常将其用于训练和评估生成模型,以将耸动性标题转化为信息真实、语气中立的表述,从而在生成式人工智能与媒体可信度交叉研究中形成一套标准化的实验范式。
实际应用
在实际应用层面,该数据集可服务于新闻聚合平台、社交媒体内容审核系统以及自动化摘要与标题生成工具。通过提供大量经质量筛选的合成改写轨迹,它帮助工程人员训练轻量级模型,在保持原文语义的前提下抑制夸张修辞与诱导性表达,从而降低用户受误导风险,提升信息生态的整体可信度。
衍生相关工作
围绕该数据集,后续研究衍生出多条技术路线:其一,基于其轨迹数据微调生成式语言模型,探索低资源场景下的反标题党改写;其二,利用其两阶段评判标签构建奖励模型,服务于强化学习与偏好优化;其三,将其作为基准测试集,评估大模型在信息保真与风格控制之间的权衡能力,相关成果已逐步融入虚假信息治理与可控文本生成的研究脉络之中。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


