
遇见数据集

themes12/lanna-global-mmlu-lite

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

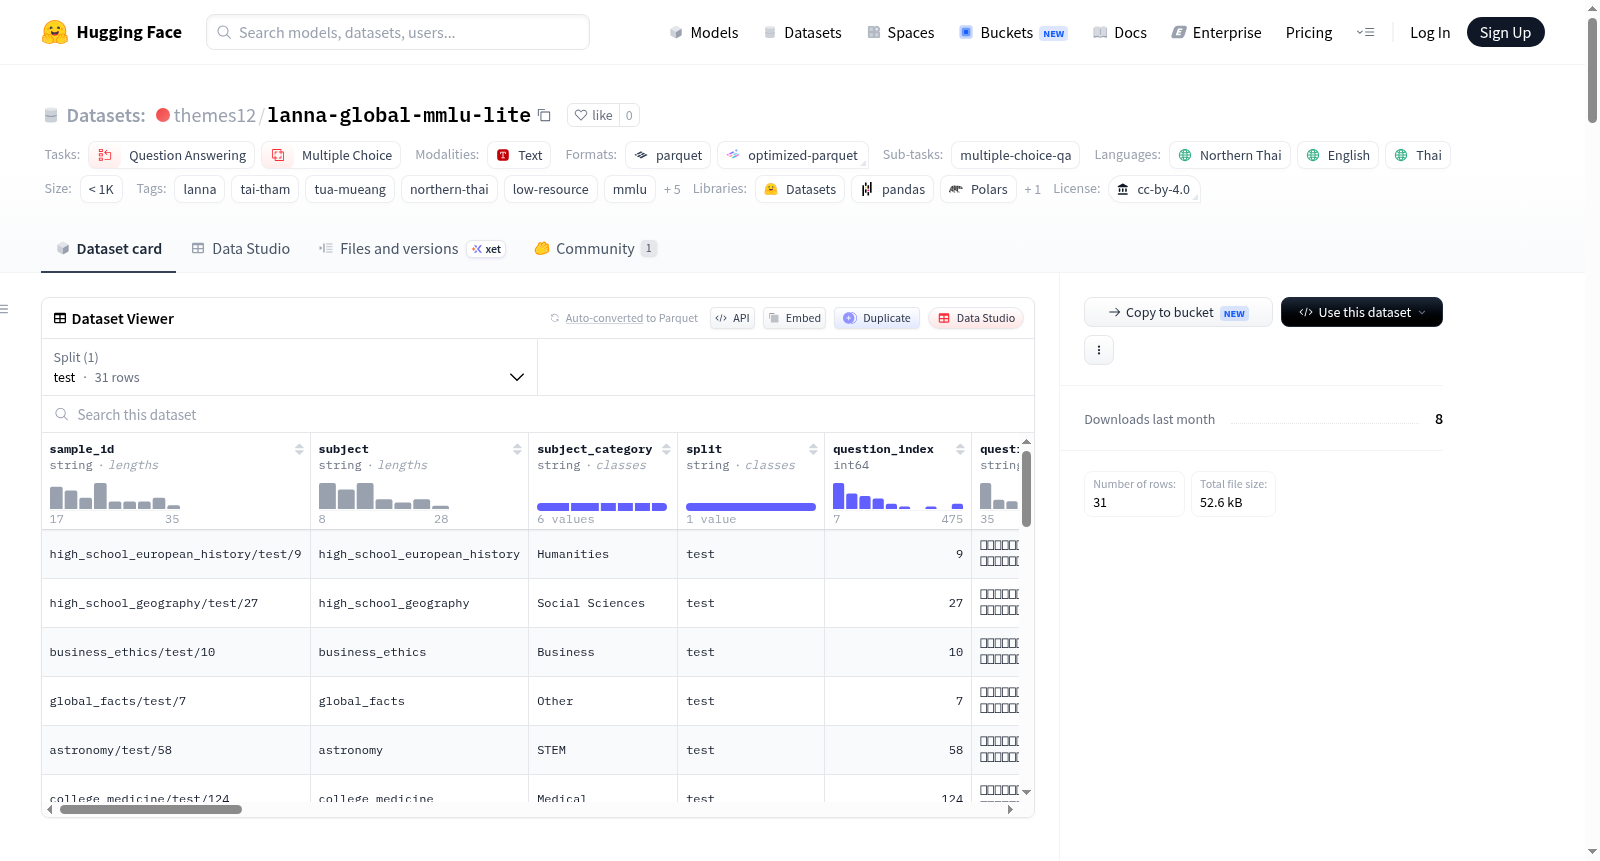
Lanna Global MMLU Lite 是一个小型、经过人工验证的多项选择基准数据集,使用兰纳文字(ᨲᩫ᩠ᩅᨾᩮᩬᩥᨦ / Tua Mueang / Tai Tham)——这是泰国北部古代兰纳王国的传统书写系统。该数据集是Global MMLU Lite子集的兰纳文字翻译版本,包含31个人工验证的问题,每个问题有4个选项(A/B/C/D)。翻译过程为:英文→泰文(通过ChatGPT)→兰纳文(通过Gemini)→人工验证。数据集覆盖6个学科类别(商业、人文、医学、其他、STEM、社会科学)和23个主题,旨在作为低资源脚本(兰纳文字)的基准,用于评估大型语言模型在罕见文字上的性能。数据集遵循CC BY 4.0许可证。

A small, hand-validated multiple-choice benchmark dataset in Lanna script (ᨲᩫ᩠ᩅᨾᩮᩬᩥᨦ / Tua Mueang / Tai Tham) — the traditional writing system of the ancient Lanna Kingdom of northern Thailand. This dataset is a Lanna-script translation of a subset of Global MMLU Lite, containing 31 hand-validated questions with 4 answer choices (A/B/C/D) each. The translation process involved: English → Thai (via ChatGPT) → Lanna (via Gemini) → human validation. It covers 6 subject categories (Business, Humanities, Medical, Other, STEM, Social Sciences) across 23 topics, serving as a benchmark for low-resource scripts (Lanna) to evaluate large language model performance on unseen scripts. The dataset is released under CC BY 4.0 license.
提供机构:
themes12
搜集汇总
数据集介绍
themes12/lanna-global-mmlu-lite 数据集图片
构建方式
Lanna Global MMLU Lite 数据集源自全球通用的多学科问答基准 Global MMLU Lite,经过精细的跨语言与跨文字转换流程构建而成。首先,将原始英文题目借助 ChatGPT 译为泰语,继而利用 Gemini 模型结合链式推理提示,依照兰纳文(Tua Mueang 或 Tai Tham)的语法惯例与书写规则完成从泰语到兰纳文的翻译。最终,由一名以北部泰语为母语的研究者逐题进行人工校验与修正,并对照词典与学术指南确保语义与文化的准确性。数据集共收录 31 道经过人工验证的多选题,覆盖 6 大类别与 23 个主题,每道题目均保留英文原题、翻译后的兰纳文选项及正确答案,同时附有文化敏感性标签、区域与国家信息等丰富元数据。
特点
该数据集的核心特质在于其针对极端低资源文字——兰纳文——的专注与稀缺性。兰纳文是历史上兰纳王国使用的元音附标文字,在当代几乎不存在于任何大规模语言模型的训练数据中。数据集通过保留英文原题与翻译后兰纳文内容的对应关系,支持跨语言与跨文字的性能对比分析。此外,每道题目均标注了文化敏感性、知识类型及时间敏感性等维度,便于研究者深入探究模型在特定文化背景下的推理缺陷。初步测评显示,即使最先进的模型在处理兰纳文时也出现显著的准确率下降与推理时间延长,凸显了该文字对现有自然语言处理系统的独特挑战。
使用方法
研究者可直接通过 Hugging Face Datasets 库加载该数据集的测试分片,每条样本包含兰纳文的问题与四个选项,以及英文原文。适用于零样本场景下的多语言多模态评估,用户无需提供额外的兰纳文上下文或系统提示即可复现基准结果。由于数据规模小巧且标注粒度精细,亦可用于验证翻译质量、分析文化敏感性对模型预测的影响,或作为低资源文字识别与理解的诊断工具。值得注意的是,使用时应充分考虑样本量有限的局限,避免对模型性能的细微差异做出过度解读,并参考原始 Global MMLU Lite 的许可条款进行合规使用。
背景与挑战
背景概述
兰纳文字(Tua Mueang/Tai Tham)作为古兰纳王国(今泰国北部、缅甸掸邦、老挝及中国云南部分地区)的传统书写系统,是一种濒危的元音附标文字(abugida),在当代仅存于佛教宗教语境与少量文化社群中,堪称极度低资源的语言文字。在全球多语言自然语言处理迅速发展的背景下,大型语言模型(LLM)在拥有海量训练数据的主流语言上表现卓越,却对濒危文字几乎毫无接触。为填补这一空白,Lanna Global MMLU Lite数据集于近期由一位兰纳语母语研究者创建,其基于CohereForAI发布的Global MMLU Lite,通过“英语→泰语→兰纳文字”的人工翻译与人工校验流程,最终产出31道经过严格验证的多选题。该数据集的核心研究问题在于:当前顶尖LLM在完全未见过的濒危文字推理任务中,其性能究竟会衰减到何种程度。凭借其独特的语言文化敏感性与极低资源属性,这一基准为评估LLM在语言多样性与文化包容性方面的真实能力提供了关键试金石,对推动多语言NLP向真正意义上的全球覆盖具有重要示范意义。
当前挑战
该数据集所应对的首要领域挑战,在于现有LLM基准测试几乎完全依赖英语等主流语言,严重忽视了对濒危文字与文化知识的泛化能力评估。语言模型在兰纳文字任务上的准确率普遍较英文下降21.7%至57.1%,且推理时间延长3至10倍,暴露出模型对非拉丁文字的字符级解码能力的根本缺失。在构建过程中,数据集面临着多重严峻挑战:翻译质量难以保证,由于兰纳文字缺乏统一的正字法规范,不同地区与传统的书写惯例存在显著差异,且无法在现行义务制教育体系中系统习得,即使母语者亦难以达到完全无误的书面水平;同时,受限于少数翻译者与学术资源,最终仅产出31个样本,统计显著性不足,难以对小样本差异做出稳健论断;此外,原始Global MMLU Lite问题可能已存在于模型训练语料中,而人工翻译过程中引入的语言风格变异性与潜在错误,均增加了评估结果的解释难度。
常用场景
经典使用场景
Lanna Global MMLU Lite作为一项精心手工验证的多选题基准数据集,其核心应用场景在于评估和比较大型语言模型在低资源文字——兰纳文(Tai Tham / Tua Mueang)上的推理能力。研究者通常利用该数据集对模型进行零样本测试,通过对比模型在英语原题与兰纳译文上的准确率差异,衡量其跨文字泛化能力。该数据集覆盖商业、人文学科、医学、社会科学等多个知识领域的23个主题,为多语言、多文化场景下的模型鲁棒性检验提供了稀缺的评测资源。
解决学术问题
该数据集直面低资源文字在自然语言处理领域的学术困境,尤其是兰纳文作为濒危音节文字,在现有训练数据中几乎完全缺失。它系统性地揭示了当前主流大型语言模型在面对陌生书写系统时的性能崩塌现象——例如DeepSeek与Qwen模型的准确率下降超过50%,而Gemini系列表现相对稳健。这种对比为研究模型内部字符级解码机制、训练数据文字多样性对泛化能力的影响,以及多语言预训练策略的有效性提供了关键实证依据。
衍生相关工作
该数据集的构建方法论催生了多项衍生工作,包括采用链式思维提示进行低资源文字翻译的流程(英语→泰语→兰纳文+人工验证),以及探究翻译质量对模型评估影响的控制实验。其评估结果激发了针对文字形态相似性(如兰纳文与泰文、缅文)的跨文字迁移学习研究,以及专门针对濒危文字设计的数据增强技术。同时,该数据集作为Global MMLU Lite的语种扩展,也推动了更多低资源文字版本(如傣绷文、老傣文)的基准构建工作。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

