
遇见数据集

theislab/chem-perturbridge

收藏
Hugging Face2026-05-28 更新2026-06-14 收录
官方服务:

资源简介:

Chem-PerturBridge是一个处理标准化表达数据(.h5ad文件)和差异基因表达(DGE)输出的数据集集合,源自多个上游数据集(如LINCS L1000、Novartis DRUG-seq、OP3等),这些上游数据集允许再分发。该数据集包含经过处理的组重复批量或伪批量输入文件(位于<dataset>/目录下)和DGE输出文件(位于<dataset>/group_rep/和<dataset>/sep_rep/目录下),其中DGE分析分为使用所有重复(group_rep)和每个重复单独(sep_rep)两种模式,用于数据集内部一致性评估。总共有316个DGE文件,覆盖8个子数据集。数据集遵循CC BY 4.0许可证进行整理和打包,同时保留每个上游数据集的原始许可证和归属要求。数据文件包括表达矩阵、基因注释和处理对比统计信息,适用于药物扰动和基因表达分析研究。

Chem-PerturBridge is a collection of processed standardized expression data (.h5ad files) and differential gene expression (DGE) outputs from multiple upstream datasets (e.g., LINCS L1000, Novartis DRUG-seq, OP3) that permit redistribution. It includes processed group-replicate bulk or pseudobulk input files (under <dataset>/) and DGE output files (under <dataset>/group_rep/ and <dataset>/sep_rep/), with DGE analysis conducted in two replicate modes: using all replicates (group_rep) and per replicate (sep_rep) for within-dataset agreement evaluation. In total, there are 316 DGE files across 8 sub-datasets. The dataset is released under CC BY 4.0 for curation and packaging, while preserving the original licenses, notices, and attributions of each upstream dataset. The files contain expression matrices, gene annotations, and treatment-vs-control contrast statistics, suitable for drug perturbation and gene expression analysis research.
提供机构:
theislab
搜集汇总
数据集介绍
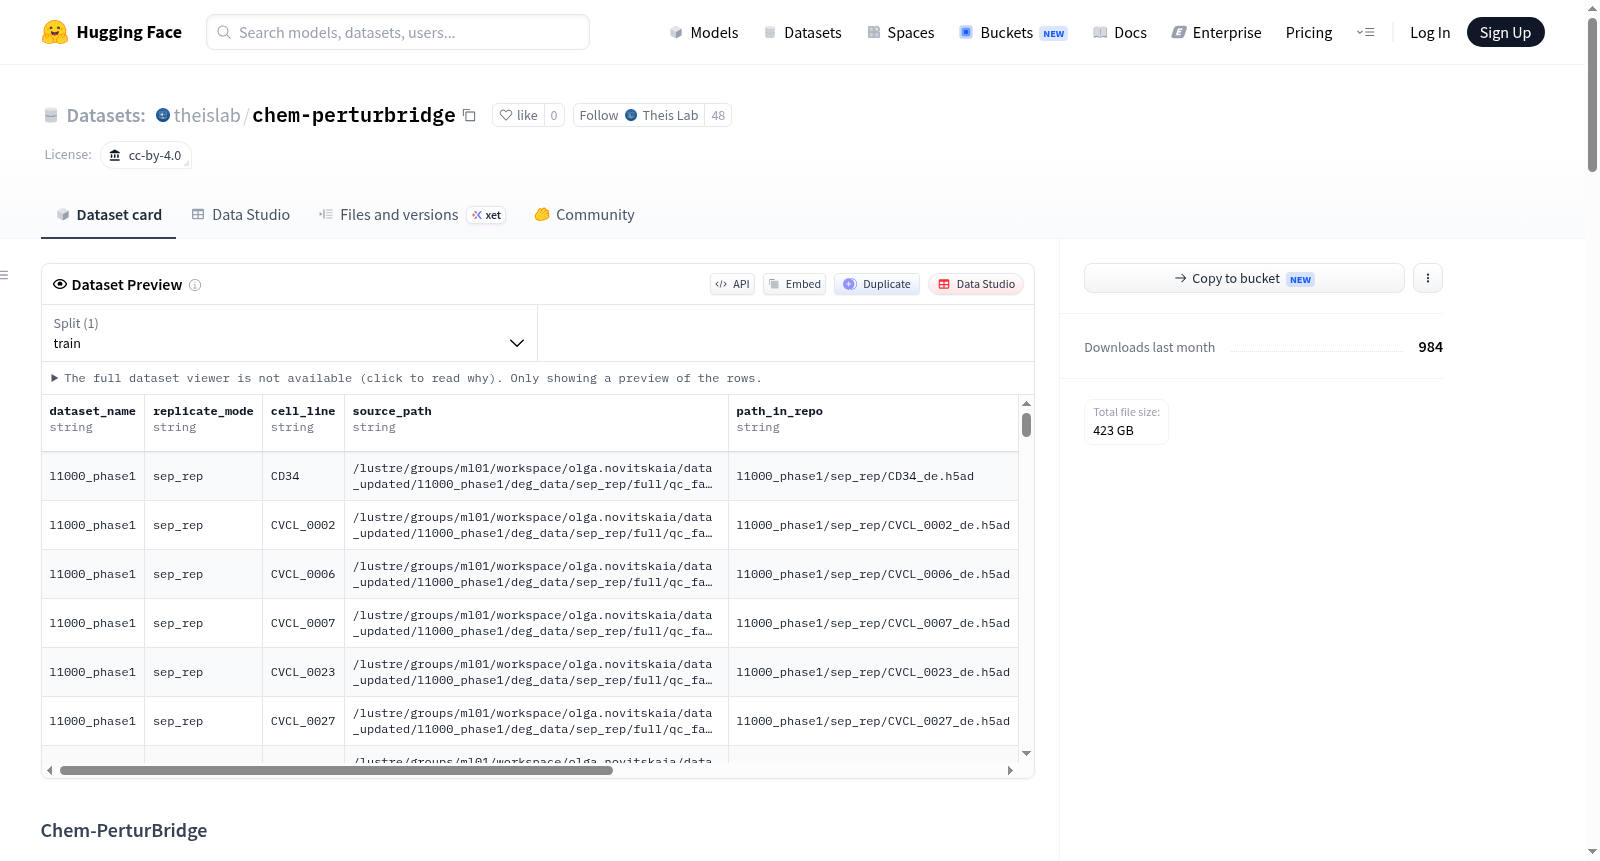
theislab/chem-perturbridge 数据集图片
构建方式
Chem-PerturBridge数据集整合了来自多个公开语料库的标准化基因表达谱与差异表达分析结果。其构建过程涉及对L1000、Novartis、OP3、SciPlex、Tahoe及VCPI等上游数据的统一处理,生成.h5ad格式的批量或伪批量输入文件。数据集进一步采用两种复制模式——组复制和分离复制,分别评估整体及批次内的一致性,从而产出316个差异表达分析文件,涵盖八个数据子集及多种细胞系背景。所有元数据均被完整保留于AnnData对象中,确保来源可追溯。
使用方法
研究人员可通过HuggingFace仓库直接下载.h5ad格式的标准化输入文件及差异表达输出。处理输入文件可直接加载至AnnData对象,并利用其.obs中的元数据字段(如perturbagen、cell_type)进行筛选。差异表达文件则适用于后续的基因集富集分析、通路分析或机器学习任务,其中.layers存储的统计量可直接用于计算。所有文件均附有清单表格(.tsv),明确记录了文件来源、复制模式及许可信息,便于用户实现精确引用与合规使用。
背景与挑战
背景概述
化学扰动转录组数据的系统整合对于理解化合物作用机制、加速药物发现至关重要。Chem-PerturBridge数据集由多机构研究者于近期构建,旨在解决不同来源化学扰动表达谱的标准化与融合问题。该数据集整合了LINCS L1000、Novartis DRUG-seq、Sci-Plex等八大公开资源,涵盖158个细胞系/条件下的316个差异表达分析文件,为化学扰动转录组研究提供了迄今最全面的标准化处理数据集合。其核心研究问题在于建立跨平台、跨实验的化学扰动效应比较基准,通过统一的数据处理流程消除批次效应,使得不同来源的基因表达数据具有可比性。该数据集的发布显著推动了计算药理学领域发展,为构建化学结构-基因表达预测模型、揭示化合物与疾病的关联提供了高质量训练资源。
当前挑战
该数据集面临的核心挑战包括:领域问题层面,化学扰动数据的高度异质性导致传统跨数据集整合方法失效,不同平台(如L1000的landmark基因与DRUG-seq的全转录组)间特征空间不匹配,且实验设计差异(如剂量、时间点、细胞类型)使得生物学信号混杂技术噪声。构建过程层面,各上游数据集采用不同的标准化策略(如伪批量计数、平台特异性强度值),需定义统一处理协议以平衡信息损失与可比性;同时,差异表达分析中复现模式的选择(group_rep与sep_rep)需权衡统计效力与跨批次一致性评估,且320余个对比文件的元数据对齐(如PubChem CID映射、细胞系标准命名)要求极高的自动化校验精度。此外,开源许可的多样性(从CC0至MIT)增加了合规性管理的复杂性。
常用场景
经典使用场景
在化学基因组学与药物重定位研究中,Chem-PerturBridge数据集为解析化合物扰动下的基因表达调控提供了标准化的多组学桥梁。该数据集整合了来自L1000、Sci-Plex、Tahoe-100M等多个公开资源的大规模扰动转录组数据,经过统一的质量控制和表达矩阵标准化处理,并以高效的h5ad格式存储。研究者可通过该资源直接获取不同细胞系、不同剂量与时间窗口下的差异表达基因列表,从而识别化学扰动与转录响应之间的量化关联。经典使用方式包括训练基于深度学习的扰动响应预测模型、评估跨数据集的可迁移性,以及构建化合物-基因-疾病网络中的因果关系图谱。
解决学术问题
Chem-PerturBridge数据集有效解决了扰动转录组学领域中数据碎片化与标准化缺失的核心瓶颈。长期以来,不同研究团队生成的化合物扰动数据因平台差异、处理流程不一而难以直接整合比较,制约了系统性药物机制解析与通用性预测模型的发展。该数据集通过统一处理流程生成标准化的表达矩阵与差异表达统计量,使得研究者能够跨越实验批次异质性进行联合分析。其重要意义在于提供了可复现的基准数据资源,支撑了化合物相似性推断、基因功能注释以及药物作用机制的大规模元分析,推动了从单个扰动实验到全局转录组景观的综合认知。
实际应用
在实际研究与产业转化层面,Chem-PerturBridge数据集为药物发现管线中的早期筛选与靶点预测提供了数据燃料。制药企业可利用该资源评估候选化合物在多种细胞背景下的转录指纹,从而快速排除具有潜在脱靶毒性或无效作用的分子。在精准医学领域,该数据集支持基于患者细胞模型预测个性化药物响应,辅助临床前实验设计。此外,它被广泛应用于计算毒理学中的化合物安全性评估,通过对比已知毒性扰动与待测化合物的表达谱相似性,实现高效的风险预警。数据集还推动了公共数据库互操作标准的建立,使学术界与工业界能够在统一语义下共享和比较扰动转录组知识。
数据集最近研究
最新研究方向
在当前单细胞转录组与药物扰动高通量数据爆炸式增长的时代,Chem-PerturBridge数据集通过系统整合LINCS L1000多阶段数据、Novartis DRUG-seq、OP3、scPerturb及Tahoe-100M等八大来源的标准化表达谱与差异表达分析结果,为化学扰动下的基因调控机制研究构建了跨平台、跨条件的统一基准。该数据集前沿聚焦于两大方向:一是利用大规模伪批量处理流程实现批次效应消除与复现性评估,通过group_rep与sep_rep双重分析模式为扰动-表型关联的稳健性提供统计保障;二是推动基于对比学习的药物重定位与协同效应预测,其涵盖310余组细胞系特异性扰动-对照对比的层析统计量(如logFC、校正P值等)直接服务于深度生成模型与图神经网络的训练,成为连接实验扰动与计算建模的关键枢纽。在AI制药与精准医学热点下,该数据集的开放许可分发策略(CC BY 4.0)有效促进了学术界与工业界在化学遗传学交叉领域的协作,其标准化AnnData架构更降低了多源异构数据的利用门槛,为解构疾病相关基因网络和发现新型治疗靶点提供了可复现的数据基础设施。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

