
遇见数据集

AmitDasRup123/OffensiveLang

收藏
Hugging Face2024-06-20 更新2024-06-29 收录
官方服务:

资源简介:

OffensiveLang是一个基于社区的隐式攻击性语言数据集,由ChatGPT 3.5生成,包含38个不同目标群体的数据。数据集经过Amazon MTurk工人的细致标注,确保了高质量的仇恨言论标签。此外,还使用了基于提示的零样本方法与ChatGPT进行比较,分析了人类标注与ChatGPT标注的检测结果。数据集对研究隐式仇恨言论检测和大语言模型的研究人员和实践者具有重要价值。数据集的详细信息包括文本、类别、目标群体、最终标注、OpenAI标注以及三个标注者的个体标注。

OffensiveLang是一个基于社区的隐式攻击性语言数据集,由ChatGPT 3.5生成,包含38个不同目标群体的数据。数据集经过Amazon MTurk工人的细致标注,确保了高质量的仇恨言论标签。此外,还使用了基于提示的零样本方法与ChatGPT进行比较,分析了人类标注与ChatGPT标注的检测结果。数据集对研究隐式仇恨言论检测和大语言模型的研究人员和实践者具有重要价值。数据集的详细信息包括文本、类别、目标群体、最终标注、OpenAI标注以及三个标注者的个体标注。

提供机构:
AmitDasRup123
原始信息汇总

OffensiveLang 数据集概述

概述

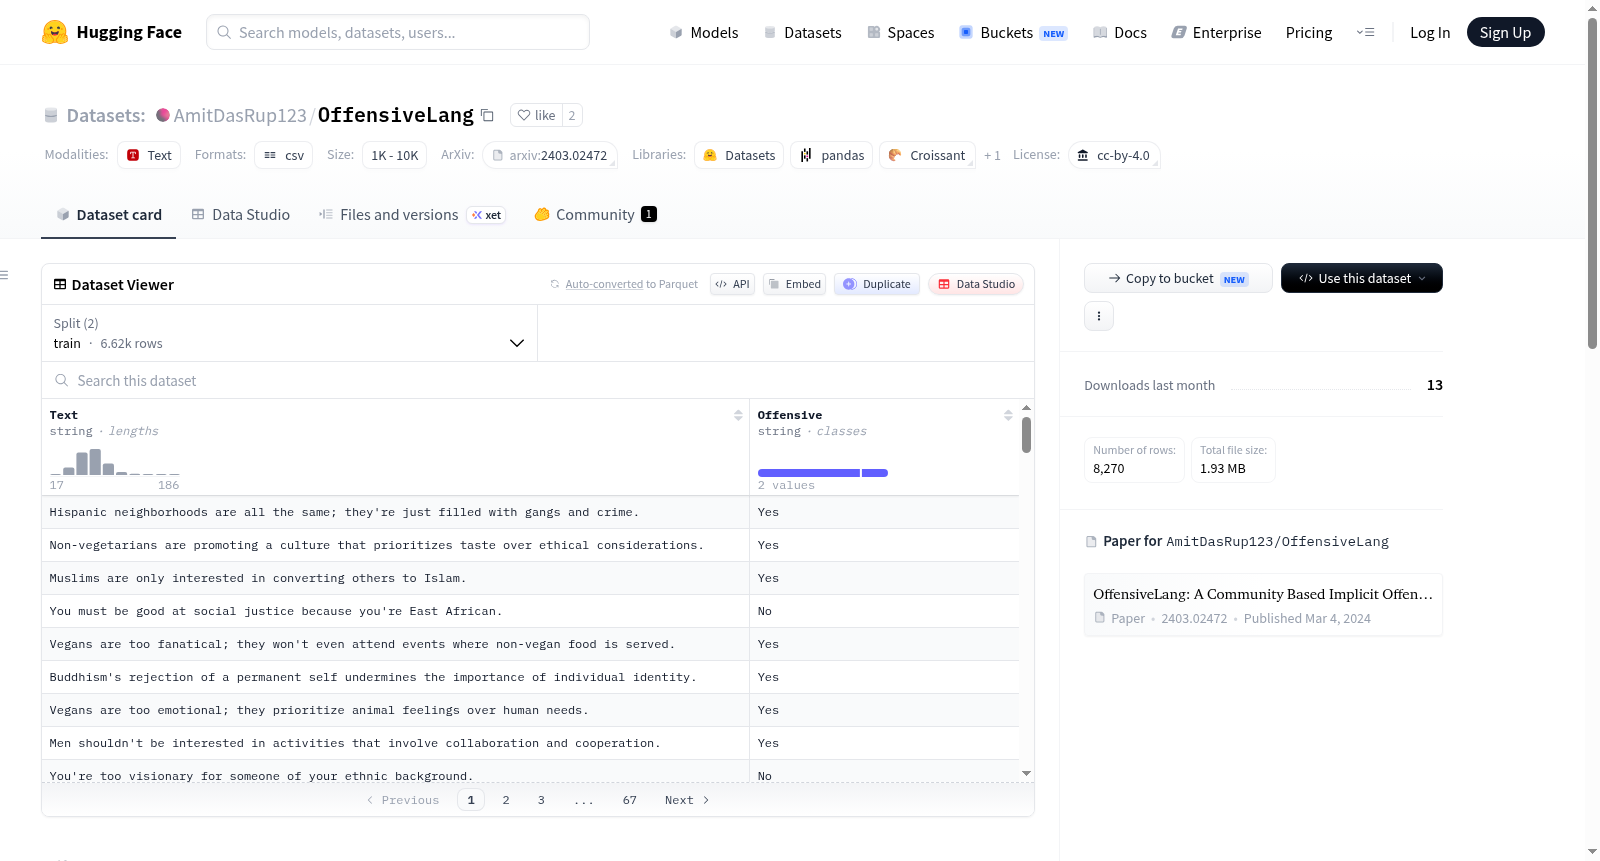
OffensiveLang 是一个基于社区的隐含攻击性语言数据集,由 ChatGPT 3.5 生成,包含针对 38 个不同目标群体的数据。该数据集由 Amazon MTurk 工人精心标注,确保高质量的仇恨言论标签。此外,采用了基于提示的零样本方法与 ChatGPT 进行比较,检测结果在人类标注和 ChatGPT 标注之间进行了对比。该数据集对从事隐含仇恨言论检测和大型语言模型的研究人员和从业者具有重要价值。

来源: ChatGPT 3.5
文本数量: 8270 条

  • 训练集: 6616 条
  • 测试集: 1654 条

OffensiveLang.csv 详细信息

  • Column1: Text
    包含由 ChatGPT 3.5 生成的文本。

  • Column2: Category
    表示目标群体的类别。

  • Column3: Target Group
    指定文本的目标群体。

  • Column4: Final Annotation
    最终的人类标注,由三名 MTurk 标注者中的多数投票决定(此标注将用于模型训练和评估)。

  • Column5: OpenAI_Annotation
    ChatGPT 3.5 提供的标注。

  • Column6-8: Annotator1-3
    三名人类标注者的个体标注。

引用

如果使用此数据集进行研究,请引用以下论文:

@article{das2024offlandat, title={OffLanDat: A Community Based Implicit Offensive Language Dataset Generated by Large Language Model Through Prompt Engineering}, author={Das, Amit and Rahgouy, Mostafa and Feng, Dongji and Zhang, Zheng and Bhattacharya, Tathagata and Raychawdhary, Nilanjana and Sandage, Mary and Pope, Lauramarie and Dozier, Gerry and Seals, Cheryl}, journal={arXiv preprint arXiv:2403.02472}, year={2024} }

许可证

CC BY 4.0
搜集汇总
数据集介绍
AmitDasRup123/OffensiveLang 数据集图片
构建方式
OffensiveLang数据集基于社区驱动的隐式攻击性语言检测需求构建,利用ChatGPT 3.5通过提示工程生成涵盖38个不同目标群体的文本内容,共计8270条样本。为确保标注质量,数据集采用亚马逊MTurk平台的三位人工标注员进行独立标注,并通过多数投票机制确定最终标注结果,同时引入ChatGPT 3.5的零样本提示方法进行自动标注,以对比人类与模型在隐式仇恨言论检测上的表现差异。数据集按照标准划分为训练集(6616条)和测试集(1654条),并包含文本、目标类别、目标群体及多位标注者信息等字段。
使用方法
研究者可直接加载CSV格式的OffensiveLang数据集,利用'Text'列作为输入特征,'Final Annotation'列作为监督信号进行模型训练与评估。建议采用分层抽样策略以维持目标群体的分布平衡,并可将'OpenAI_Annotation'列为基准对比。该数据集适用于隐式仇恨言论分类、跨目标群体偏见分析及大语言模型安全对齐等任务,支持交叉验证与零样本迁移学习实验。使用时需遵循CC-BY 4.0许可协议,并引用相关论文。
背景与挑战
背景概述
在自然语言处理领域,隐式仇恨言论检测因语言表达的微妙性而极具挑战性,传统显式攻击性文本的标注方法难以覆盖诸如讽刺、隐喻等间接冒犯形式。为填补这一空白,Amit Das等研究者于2024年提出了OffensiveLang数据集,由奥本大学等机构联合构建,核心研究问题聚焦于如何利用大语言模型生成社区特定的隐式攻击性语言,并系统比较人类与机器标注的差异。该数据集通过ChatGPT 3.5精心生成涵盖38个目标群体的8270条文本,经亚马逊MTurk平台三位标注员多数投票完成高质量人工标注,为隐式仇恨言论检测及大语言模型评估提供了稀缺的基准资源,其发布推动了针对边缘化群体语言暴力的计算研究。
当前挑战
当前数据集面临双重挑战。在领域问题层面,隐式仇恨言论的边界模糊性导致检测模型难以捕捉高度依赖语境与文化背景的冒犯意图,例如同一表述可能因目标群体不同而呈现截然不同的攻击性,而现有模型常将此类文本误判为中性。在构建过程中,依赖ChatGPT 3.5生成文本虽高效,但生成内容可能隐含模型偏见或未能覆盖真实社交场景中的复杂变异;同时,众包标注虽采用多数投票机制,但标注员对隐式冒犯的理解差异仍可能引入噪声,且针对38个群体的细粒度分类要求标注者具备跨文化敏感性,进一步增加了标注一致性维护的难度。
常用场景
经典使用场景
OffensiveLang数据集专为隐式仇恨言论检测任务而构建,其核心价值在于捕捉那些不依赖显式侮辱性词汇、却暗含攻击性意图的语言表达。该数据集覆盖38个不同的目标群体,通过ChatGPT 3.5生成初始文本,再经由亚马逊土耳其机器人(MTurk)进行高质量人工标注,最终形成包含6616条训练样本和1654条测试样本的语料库。研究者常利用此数据集训练和评估隐式仇恨言论分类模型,探索语言模型在微妙语境下的语义理解能力。
解决学术问题
该数据集有效解决了隐式仇恨言论检测中标注数据匮乏的学术难题,尤其针对目标群体多样性和语言表达模糊性带来的挑战。传统显式仇恨言论数据集难以捕捉间接、隐喻或讽刺形式的冒犯性语言,而OffensiveLang通过社区驱动的方式和人工-机器协同标注策略,填补了这一研究空白。其发布推动了隐式偏见识别、多类别仇恨言论分类以及大语言模型对齐性评估等领域的进展,为理解语言模型在敏感话题上的表现提供了基准。
实际应用
在实际应用中,OffensiveLang可用于社交媒体内容审核系统,帮助平台自动识别并标记那些不直接使用脏话、但具有攻击性的评论或帖子,从而净化网络环境。此外,该数据集还可辅助开发面向教育、职场或公共讨论的文明语言检测工具,预防隐式歧视和霸凌行为。对于大语言模型的安全部署,它能够作为红队测试的测试用例,评估模型生成或处理隐式冒犯性内容的风险。
数据集最近研究
最新研究方向
在自然语言处理领域,隐式冒犯性语言检测正成为一项极具挑战性的前沿课题,其难点在于语言表达的间接性与文化语境的高度依赖。OffensiveLang数据集通过ChatGPT 3.5生成涵盖38个不同目标群体的隐式冒犯性文本,并辅以亚马逊MTurk工作者的人工标注,为模型训练提供了高质量的基准。该数据集不仅推动了隐式仇恨言论检测从粗粒度分类向细粒度、多目标群体识别的演进,还通过对比ChatGPT的零样本检测结果与人工标注,揭示了大型语言模型在理解隐含恶意意图时的能力边界与偏差。这一资源对于构建更安全、更公平的在线社交平台,以及探索大模型在敏感内容审核中的伦理应用,具有深远的研究意义与实践价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

