
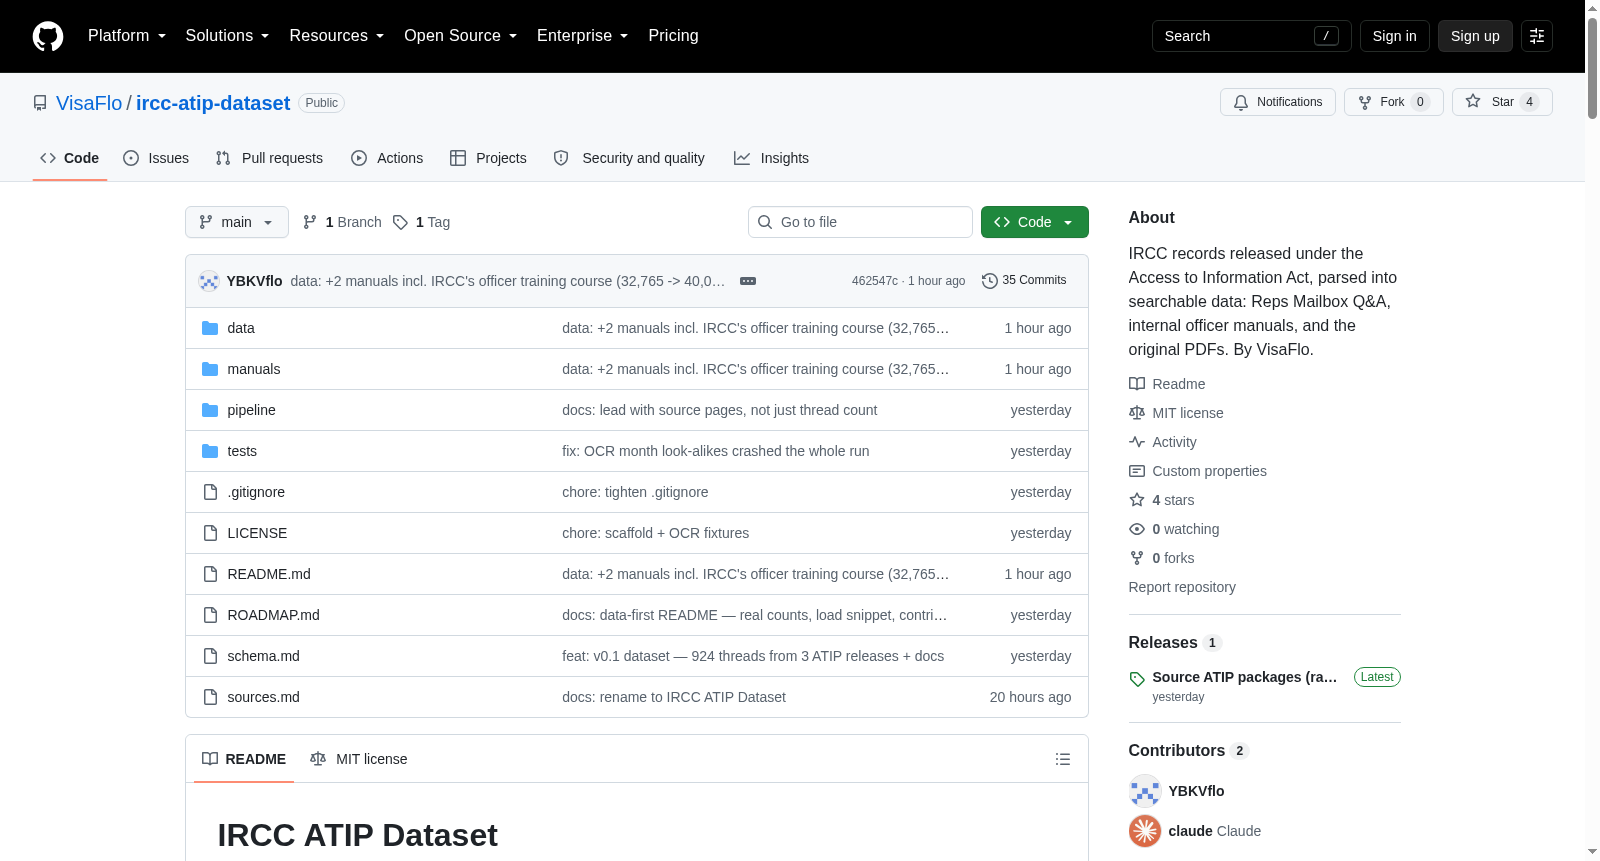
IRCC ATIP Dataset
收藏官方服务:
资源简介:
该数据集包含40,055页根据《信息获取法》获得的IRCC记录,解析为7,806个可搜索的答案,面向持牌移民代表、律师、RCICs以及开发者和研究人员,包含内部官员手册和原始PDF文件。
This dataset comprises 40,055 pages of IRCC (Immigration, Refugees and Citizenship Canada) records obtained under the Access to Information Act. These records have been parsed into 7,806 searchable answers, and it is targeted at licensed immigration representatives, lawyers, RCICs, developers and researchers, including internal officer manuals and original PDF documents.
创建时间:
2026-08-25
原始信息汇总
数据集概述
IRCC ATIP 数据集是一个开放、持续增长的数据集,包含根据加拿大《信息获取法》获得的加拿大移民、难民及公民部(IRCC)记录。数据集核心包含 40,055 页 原始记录,解析为 7,806 条 可搜索的、面向持牌移民代表的问答记录,以及 34 份 IRCC 内部官员手册的 OCR 文本。覆盖时间范围为 2016 至 2025 年,最近更新于 2026-08-25。
数据内容与结构
1. 邮件线程问答数据
- 数据按年份组织为多个 JSON 文件(
data/YYYY.json),包含各年的邮件线程问答。 - 另含一个
data/undated.json文件,存放无法解析日期的线程(365 条)。 data/index.json提供按年份、质量和 ATIP 发布编号的统计索引。- 每条记录包含以下字段:
id、atip_release、date、subject、question、answer、quality。 - 数据按
quality字段划分质量:- answered(5,935 条):实质性回复
- deflected(152 条):公式化拒绝或重定向
- partial(1,719 条):OCR 损坏或为空
2. 内部官员手册(manuals/)
- 包含 34 份 IRCC 内部文件,分为以下几类,提供了官员实际使用的指导:
- 评估流程:如 Express Entry R10 审核手册、PNP 数据录入与预评估手册、ENF 2 不可入境评估、TR 决策培训课程(CC8000)等
- 自动化与分流(Chinook):如 Chinook 1.5 & GCMS 用户手册、拒绝说明生成器模块等
- 代表与咨询处理:如客户端支持中心 webform 回复模板、第三方授权流程等
- 系统、代码与内部记录:如 GCMS 编码手册(责任中心及办公室代码)、功能指导库等
3. 原始 ATIP PDF 文件
- 数据集中每条记录均关联一个
atip_release编号(例如A-2025-72666),对应的原始 PDF 文件(IRCC 原始发布版本)可在仓库的 Releases 页面获取。
使用方式
无代码使用
- 直接在 GitHub 上打开年份 JSON 文件,使用浏览器查找功能(Cmd/Ctrl+F)搜索关键词。
- 将 JSON 文件转换为 CSV 后,可在 Excel 或 Google Sheets 中按
subject或quality字段筛选。
开发者使用
- 可直接通过
https://raw.githubusercontent.com/VisaFlo/ircc-atip-dataset/main/data基址远程加载 JSON 文件,无需克隆仓库或安装依赖(提供 Python 示例代码)。
自然语言查询(VisaFlo MCP)
- 该数据集已集成至 VisaFlo 的 MCP 服务器,AI 助手可帮助用户以自然语言搜索数据,并返回带引文和日期的 IRCC 原始回复。如需访问,可通过 info@vflo.app 联系。
数据统计示例
以下为部分主题在邮件线程中被提及的次数统计:
| 主题 | 提及数 |
|---|---|
| 学习许可 | 927 |
| 毕业后工作许可(PGWP) | 428 |
| 配偶 / 同居伴侣 | 212 |
| 无犯罪记录证明 | 41 |
| 资金证明 | 24 |
数据集特点与限制
- 开放性:所有数据均可免费获取,代码以 MIT 许可证发布,数据依据加拿大开放政府许可(OGL-Canada)发布。
- 可追溯性:每个线程均可追溯至对应的 ATIP 请求编号,且用户可自行免费申请同样的记录。
- 质量说明:源文件为扫描 PDF,存在 OCR 噪音;
question/answer提取为尽力而为,quality: partial标记表示可能存在 OCR 损坏的线程。 - 使用提醒:IRCC 的回复属于当时背景下的程序性指导,不等同于法律意见。应将每条线程视为需进一步核实的线索,而非当前有效权威,并需关注每条记录的日期。
可扩展性与贡献
- 用户可通过提交 issue 提供已完成的 IRCC ATIP 请求编号,帮助扩充数据集。
- 也欢迎提交 PR 来修复解析错误、改进 pipeline,或添加分类体系。
- 数据集包含
pipeline/目录,提供解析管线(OCR 文本 → 线程 → 去重 → JSON),基于 Python 标准库实现,并附带 90 余项测试。
搜集汇总
数据集介绍
构建方式
IRCC ATIP数据集源自加拿大信息获取法框架下所公开的官方记录,汇集了逾四万页的IRCC档案,经由自动化脚本与光学字符识别(OCR)技术,将扫描文档精密解析为结构化的JSON格式数据。数据涵盖自2016年至2025年的邮件往来记录,共提取出7,806条线索,每条均关联至对应的ATIP请求编号,并附有原始PDF文件,以确保可追溯性。此外,数据集亦囊括34份IRCC内部操作手册的OCR文本,构建流程透明且可复现,所有处理管道均以标准Python编写,并配备超过90项测试,保证了数据转换的严谨与一致性。
特点
该数据集的核心特质在于其开放性与全面性,为移民顾问、律师及研究人员提供了一套前所未有的、可直接检索的IRCC官方答复语料库。每条记录不仅包含完整的问答对,还精确标注了日期、主题及答复质量(如answered、deflected、partial),为分析政策演变提供了翔实的素材。特别值得一提的是,数据集中还收录了IRCC内部使用的操作指南与培训材料,这些内容通常不对外公开,其收录极大丰富了数据集的深度,使其成为解读移民程序幕后逻辑的珍贵资源。
使用方法
数据集的易用性体现在其多元的访问方式上,既适合技术用户亦照顾非编程人员。开发者可通过简单的Python脚本直接获取和分析JSON数据,无需克隆仓库或安装依赖;普通用户则可直接利用GitHub浏览功能或借助JSON至CSV转换工具,在电子表格中进行检索与筛选。此外,每条数据均附有ATIP发布编号,用户可据此在Releases中调取对应原始PDF文档进行核验。对于更倾向自然语言交互的实践者,VisaFlo MCP服务器提供了AI搜索接口,能够以问答形式快速定位相关答复并附上原文引用,极大提升了数据检索的便捷性与工作效率。
背景与挑战
背景概述
IRCC ATIP数据集由VisaFlo团队于2026年创建,旨在系统化整理加拿大移民、难民及公民部(IRCC)根据《信息获取法》公开的官方记录。该数据集涵盖2016年至2025年间超过4万页的ATIP文件,解析为7,806条可检索的问答记录及34份内部官员手册,填补了移民程序信息碎片化、难以获取的空白。其核心研究问题在于如何将分散的、非结构化的政府文件转化为结构化、可搜索的开放数据,以支持移民顾问、律师及研究人员高效获取权威程序指引。该数据集以开放政府许可发布,代码以MIT协议开源,影响力在于促进了移民政策透明化,为移民实践和学术研究提供了可靠的数据基础。
当前挑战
该数据集所解决的领域问题在于打破移民信息壁垒,将IRCC通过ATIP分散发布的扫描版PDF转化为统一、可检索的JSON格式,解决了传统上依赖繁琐FOIA流程和OCR管道才能访问的难题。构建过程中面临的挑战包括:源文档为扫描件,需通过本地OCR提取文本,导致结果存在噪声,影响question/answer字段的准确性;部分回复被拒或仅部分回复(如quality字段标记的deflected和partial),需保留并区分这些信号;跨年度数据稀疏不均(如2019年仅1条)及日期解析困难;还需确保个人信息的适当去标识化,同时维护数据的完整性与可追溯性,每个条目均关联原始ATIP编号以便验证。
常用场景
经典使用场景
该数据集的核心使用场景在于为移民法律从业者、研究者及政策制定者提供结构化的IRCC(加拿大移民、难民及公民部)程序性答复与内部手册全文。其典型应用包括:通过关键词检索快速定位特定主题(如学习许可、毕业后工签、配偶担保)的官方答复,或直接查阅已解析的JSON文档进行文本挖掘与统计分析。此类场景使原本分散、不可搜索的ATIP扫描件转化为可操作的证据基础,显著提升了信息可及性,是验证移民申请策略和解读政策演变的关键工具。
解决学术问题
该数据集解决了移民研究中长期存在的信息不对称与数据碎片化问题。它首次将IRCC依据《信息获取法》发布的逾四万页记录系统化整理为结构化语料,为学者提供了量化分析移民执法逻辑、内部决策模式及政策执行的实证基础。其包含的34份内部官员手册(如执法手册ENF2、反欺诈手册OP23)与邮件往来,首次向学界公开了移民审核的微观实践细节,使得从制度主义或官僚政治视角研究加拿大移民治理成为可能,填补了公开数据与内部实践之间的鸿沟。
衍生相关工作
该数据集已衍生出多项开创性工作。其一,其解析管线(pipeline)可复用于其他ATIP包,为自动化信息提取设立标准;其二,基于手册内容的执法研究(如Chinook系统的影响评估、GBA+统计)催生了关于算法决策在移民审核中应用的批判性讨论;其三,数据集在联邦法院案例(如IMM-6571-20)中作为证据引用,展示了其法律影响力。此外,其公开API模式和JSON结构已被多个第三方工具集成,促进了移民信息开放运动的兴起,并为同类政府信息公开项目提供了可借鉴的范式。
以上内容由遇见数据集搜集并总结生成


