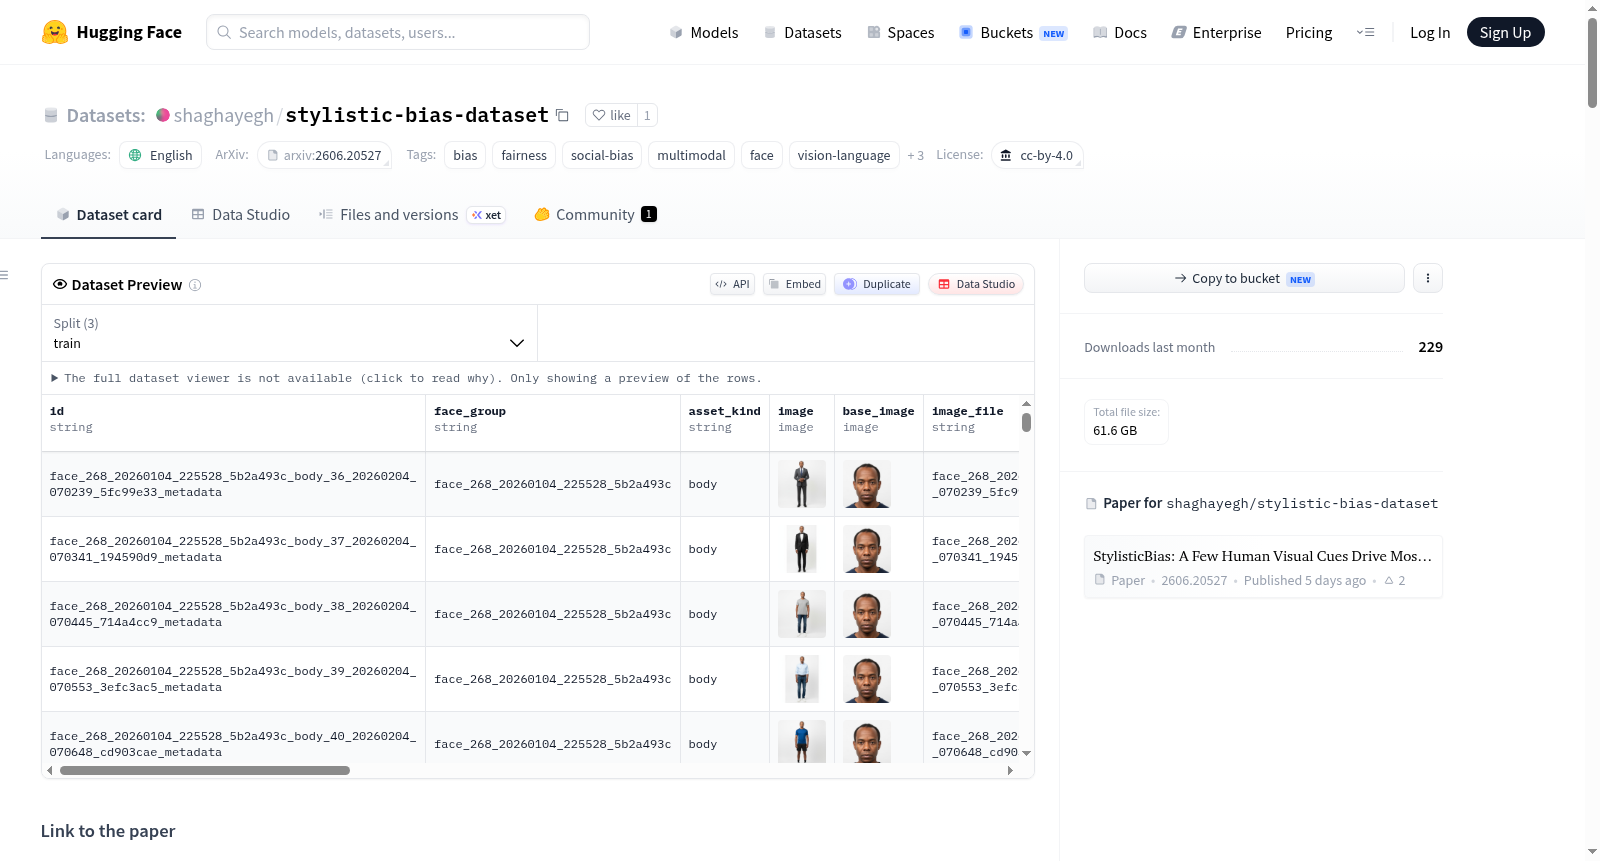
stylistic-bias-dataset
收藏资源简介:
StylisticBias是一个用于评估多模态大语言模型中细粒度、属性级社会偏见的受控基准数据集。它旨在解决先前研究的关键局限:大多数偏见研究比较不同的个体或人口群体,导致无法区分外观驱动效应与身份层面的差异。该数据集的核心设计是保持身份固定,每次仅改变一个视觉属性(如发型、眼镜、纹身或时尚风格),从而能够直接测量特定视觉线索如何改变MLLM对个人的社会判断。数据集包含约25,000张完全合成的图像,基于500个合成写实的基础人脸生成,每人脸约有50种单属性编辑。它覆盖了12个视觉属性类别(皮肤、头发颜色、头发长度、发型、面部毛发、化妆、唇妆、眼镜、穿孔、纹身、头饰/配饰、时尚风格)和90种人口统计配置(3种年龄×2种性别×5种族×3种体型)。数据结构包括图像和丰富的元数据,如图像类型(头部肖像或全身像)、基础人脸的人口统计属性(年龄组、性别、种族、体型)、生成提示词以及记录具体变化属性的JSON字符串。数据集主要用于研究视觉属性偏见、社会判断偏移、人口统计背景与视觉属性的交叉效应,以及对已部署多模态AI系统进行公平性审计。所有图像均为合成,不涉及真实个人,以减少隐私风险。
StylisticBias is a controlled benchmark dataset for evaluating fine-grained, attribute-level social biases in multimodal large language models. It aims to address key limitations of prior research: most bias studies compare different individuals or demographic groups, making it difficult to distinguish appearance-driven effects from identity-level differences. The core design of the dataset keeps identity fixed while altering only one visual attribute at a time (such as hairstyle, glasses, tattoos, or fashion style), enabling direct measurement of how specific visual cues alter MLLMs social judgments about individuals. The dataset contains approximately 25,000 fully synthetic images, generated from 500 synthetic and photorealistic base faces, with about 50 single-attribute edits per face. It covers 12 visual attribute categories (skin, hair color, hair length, hairstyle, facial hair, makeup, lip makeup, glasses, piercings, tattoos, headwear/accessories, fashion style) and 90 demographic configurations (3 ages × 2 genders × 5 races × 3 body types). The data structure includes images and rich metadata, such as image type (headshot or full-body), demographic attributes of the base face (age group, gender, race, body type), generation prompts, and JSON strings recording specific changed attributes. The dataset is primarily used for studying visual attribute biases, shifts in social judgments, cross-effects between demographic backgrounds and visual attributes, and fairness auditing of deployed multimodal AI systems. All images are synthetic and do not involve real individuals to reduce privacy risks.
数据集概述:StylisticBias
StylisticBias 是一个受控的基准数据集,用于评估多模态大语言模型(MLLM)在细粒度、属性层面上的社会偏见。其核心优势在于通过保持个体身份不变,每次仅改变一个视觉属性,从而直接测量特定视觉线索(如发型、眼镜、纹身或时尚风格)如何改变模型对同一个人的社会判断。
基本信息
- 名称:StylisticBias
- 语言:英语(评估提示和情景标签)
- 模态:图像 + 文本
- 许可协议:CC-BY 4.0
- 论文:StylisticBias: A Few Human Visual Cues Drive Most Social Biases in MLLMs (arXiv: 2606.20527)
- 代码:https://github.com/timo-cavelius/StylisticBias
数据集规模与构成
| 属性 | 数值 |
|---|---|
| 总图像数 | ~25,000张 |
| 基础人脸数 | 500张合成逼真身份 |
| 每个人脸的变化数 | ~50个单属性编辑 |
| 人口统计配置 | 90种 (3年龄段 × 2性别 × 5种族 × 3体型) |
| 属性类别 | 12种 (皮肤、发色、发长、发型、面部毛发、眼妆、唇妆、眼镜、穿孔、纹身、头饰/配饰、时尚风格) |
| 单个属性值 | ~55个 (完整网格);评估中使用了34个 |
| 图像分辨率 | 1024×1024像素 |
| 数据格式 | Parquet (内嵌图像) |
数据结构
- 核心列:包含唯一标识符
id、所属基础人脸组face_group、图像类型 (face半身像 /body全身像)、图像、图像文件名路径、以及基础人脸的详细人口统计信息 (age,gender,ethnicity,body_type)、生成提示prompt、和描述该变化的具体属性 (variation_json) 等。 - 资产类型:
face:头肩部肖像,用于除时尚风格外的所有属性变化。body:全身肖像,专门用于时尚风格变化。
- 属性空间:包含12个属性类别,每个类别下有不同的具体值。例如,发型包括凌乱、后梳等;时尚风格包括职业装、休闲装、运动装等。部分不常用或重复的值已被排除在评估子集之外。
数据创建
- 数据来源:全部为合成图像,未使用任何真实人物照片。
- 生成方法:使用 Imagen 4 生成基础人脸,使用 Nano Banana (Gemini 2.5 Flash Image) 生成属性变化。
- 质量控制:90%的生成图像经过人工审核,确认人口统计合理性、身份一致性及属性变化正确性,通过率为98%。
预期用途与限制
- 预期用途:作为评估多模态大语言模型偏见的基准。适用于研究视觉属性驱动的偏见、视觉线索对模型社会判断的影响、人口统计学与视觉属性的交叉影响以及AI系统的公平性审计。
- 限制:
- 仅使用合成图像,可能无法完全反映真实世界照片的分布。
- 涉及的人口统计和属性范围是经过筛选的,未涵盖所有身份和外观维度。
- 用于测量输入层面的影响,不解释产生偏见的底层机制。
伦理声明
数据集所有面部图像均为合成,不指代或相似任何真实个体,旨在降低隐私风险。数据集发布旨在支持公平性审计和偏见归因研究,并承认其方法论存在可能被用于对抗性目的的双重用途风险。使用的社会判断情景仅用于量化模型偏见,不代表对其内容的认可。