chinese-logic-sentiment-dataset
收藏资源简介:
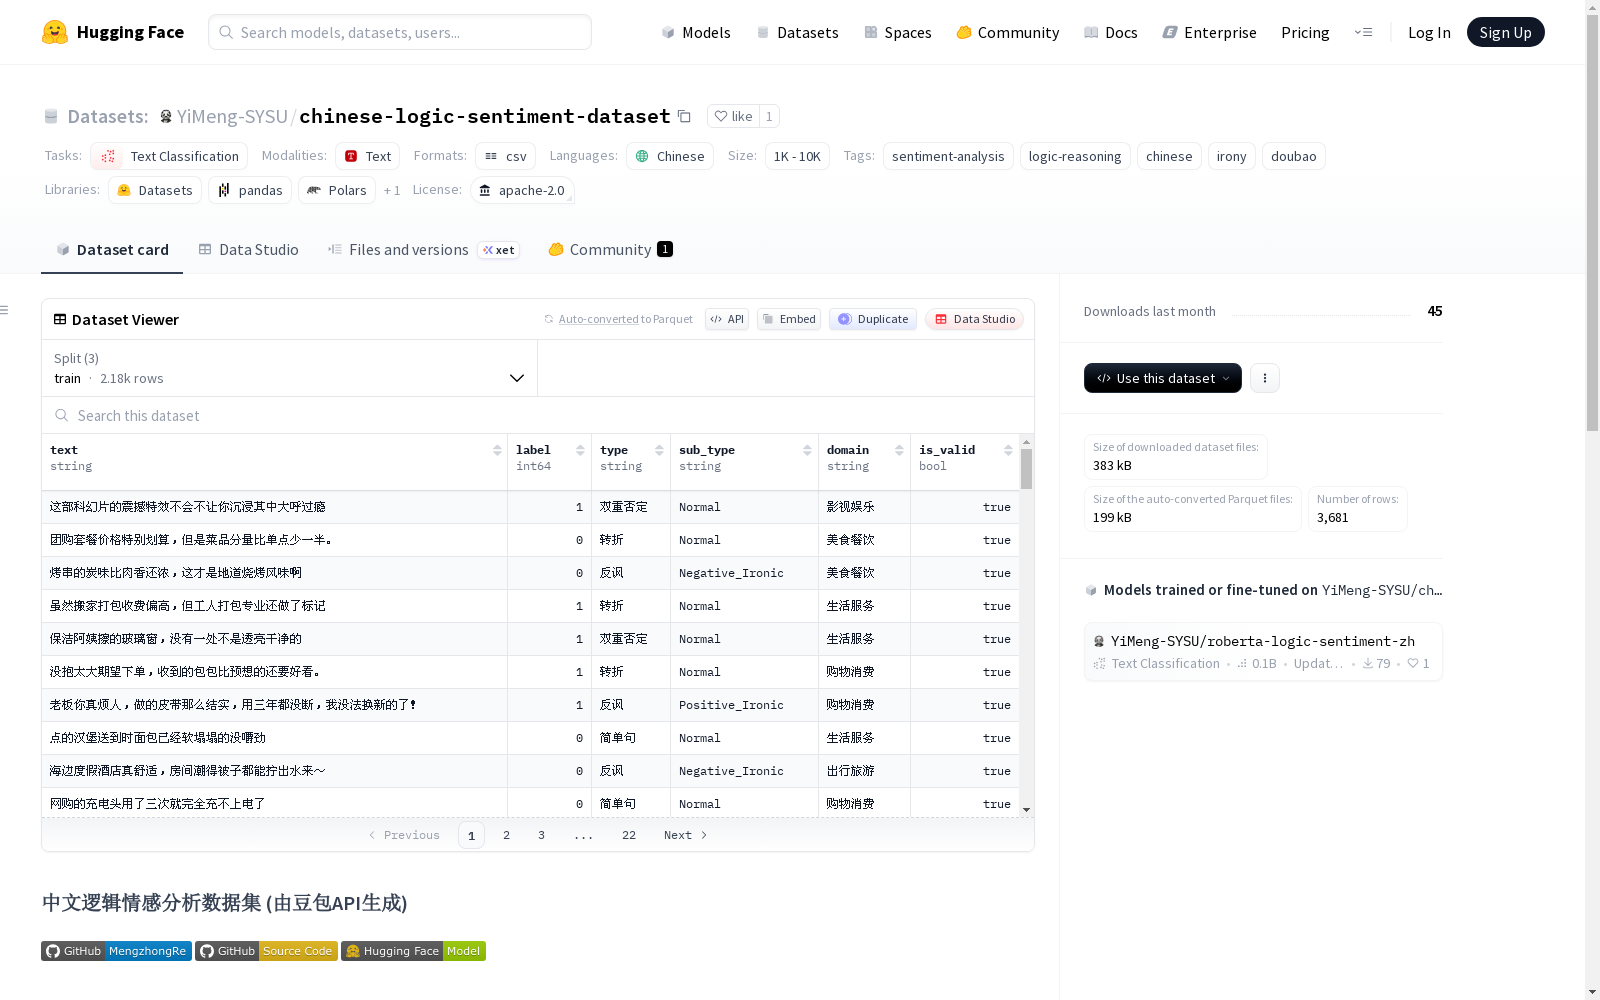
中文逻辑情感分析数据集是一个专门设计用于增强中文情感分析模型逻辑推理能力的数据集,由豆包API生成并经过人工清洗和筛选。数据集包含四种逻辑类型:反讽(Irony)、双重否定(Double Negative)、转折(Transition)和简单句(Simple)。数据集分为三个部分:训练集(2176条样本)、验证集(545条样本)和测试集(960条样本)。每个样本包含文本内容(text)、情感标签(label,0表示负面,1表示正面)、逻辑类型(type)、逻辑子类型(sub_type)和领域(domain,包括影视、美食、旅游、生活、购物和社交)。该数据集适用于中文情感分析任务,特别是需要处理复杂逻辑表达的场景。
This Chinese Logical Sentiment Analysis Dataset is specifically designed to enhance the logical reasoning capabilities of Chinese sentiment analysis models. It was generated by Doubao API and manually cleaned and filtered. The dataset includes four logical categories: Irony, Double Negative, Transition, and Simple. The dataset is divided into three subsets: training set (2176 samples), validation set (545 samples), and test set (960 samples). Each sample contains text content, sentiment label (label, where 0 indicates negative sentiment and 1 indicates positive sentiment), logical type (type), logical subtype (sub_type), and domain (including film and television, food, tourism, daily life, shopping, and social interaction). This dataset is suitable for Chinese sentiment analysis tasks, especially scenarios requiring the processing of complex logical expressions.
中文逻辑情感分析数据集概述
数据集基本信息
- 数据集名称:中文逻辑情感分析数据集 (由豆包API生成)
- 语言:中文 (zh)
- 许可协议:Apache-2.0
- 数据规模:1k<n<10k
- 任务类别:文本分类 (text-classification)
- 标签:情感分析,逻辑推理,中文,反讽,豆包
数据集来源与关联
- 主页:https://github.com/MengzhongRe/bert-logic-finetune
- 代码仓库:https://github.com/MengzhongRe/bert-logic-finetune
- 数据生成方:豆包 API
- 数据处理:经过人工清洗/筛选
数据集目的与内容
这是一个专门用于增强中文情感分析模型逻辑推理能力的数据集。它包含 反讽(Irony)、双重否定(Double Negative)、转折(Transition) 和 简单句(Simple) 四种逻辑类型。
数据结构与划分
该数据集包含三个部分:
- 训练集 (train.csv):包含 2176 条样本。
- 验证集 (val.csv):包含 545 条样本。
- 测试集 (test.csv):包含 960 条样本,用于模型最终评估。
数据字段说明
| 字段 | 描述 |
|---|---|
text |
中文文本内容 |
label |
情感标签,0 表示负面,1 表示正面 |
type |
逻辑类型,包含反讽、双重否定、转折和简单句 |
sub_type |
逻辑子类型,进一步细分逻辑结构 |
domain |
领域 (影视/美食/旅游/生活/购物/社交) |
使用方式
可通过 datasets 库加载:
python
from datasets import load_dataset
dataset = load_dataset(YiMeng-SYSU/chinese-logic-sentiment-dataset)
数据生成详情
数据生成脚本、提示词模板和清洗过程可在关联的 GitHub 仓库 MengzhongRe/bert-logic-finetune 中查看。
- 数据生成脚本地址:https://github.com/MengzhongRe/bert-logic-finetune/tree/main/data_gen