
遇见数据集

s512757/polish-tedx-asr-eval

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

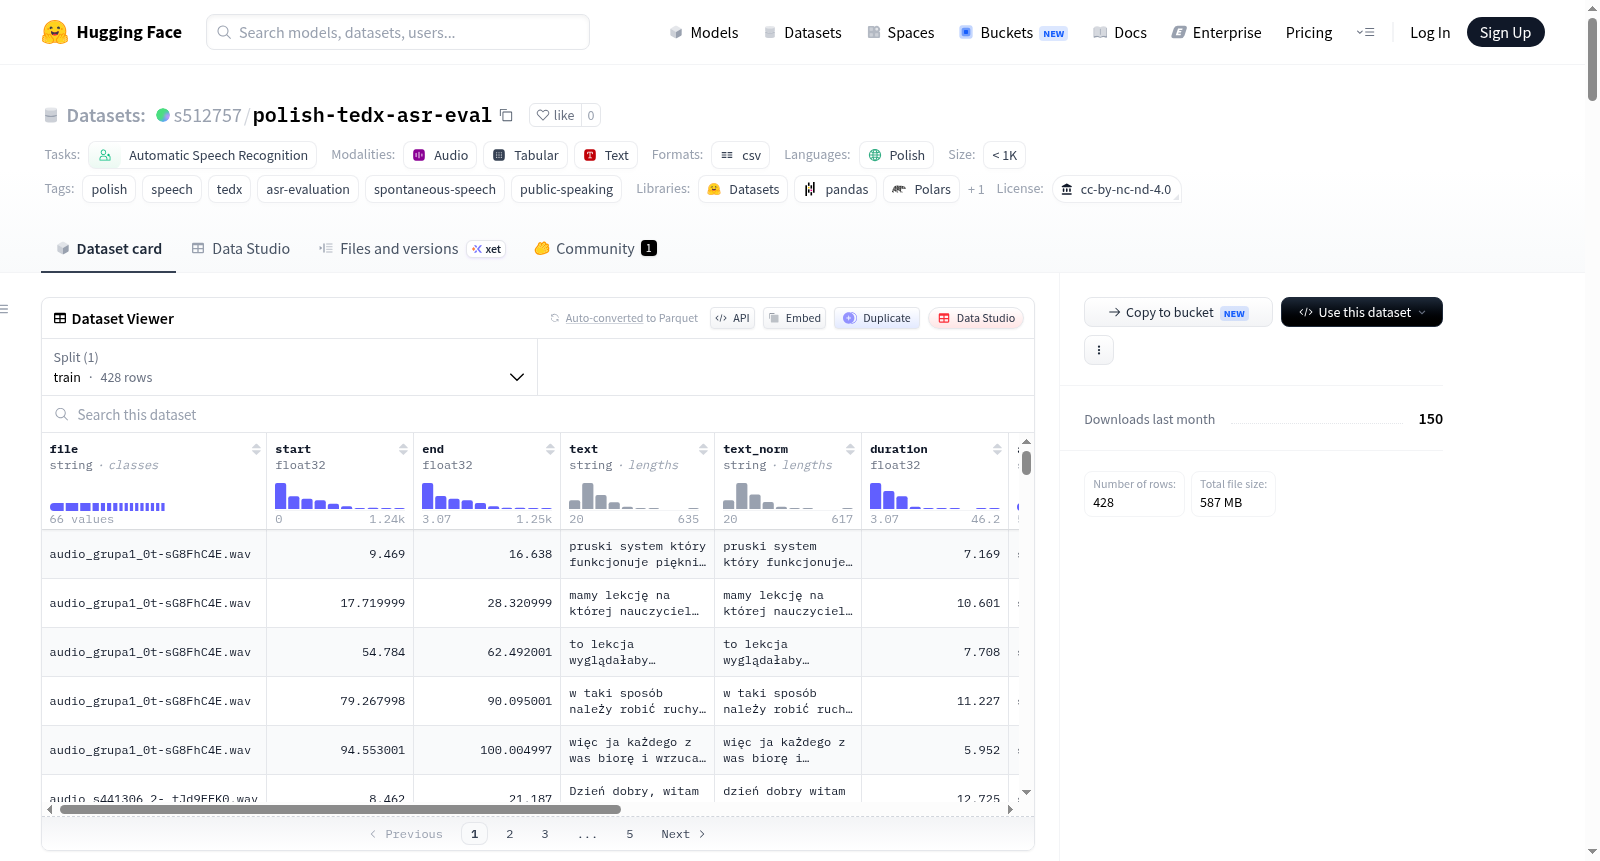
Polish-TEDx-ASR-Eval是一个用于评估波兰语自动语音识别(ASR)系统的数据集,专注于TEDx公共演讲领域。该数据集包含来自YouTube的波兰语TEDx演讲音频片段(采用CC BY-NC-ND 4.0许可证)和使用KugelAudio(MIT许可证)生成的合成语音,所有音频均带有手动创建和交叉验证的转录。数据集由5名注释者独立工作,并经过交叉验证以确保准确性。统计信息显示,总共有428个音频片段,总时长约4011秒(约67分钟),其中378个片段来自YouTube,50个片段来自文本到语音合成。音频特征包括16 kHz单声道WAV格式,涵盖自发性和计划性公共演讲以及合成语音,声学环境包括会议厅/剧院厅、混响和观众反应。数据集是在“Workshops on Evaluation of Speech Recognition Systems”(ZWESUI, AMU 2026)课程中由第一组创建的,旨在支持ASR系统的评估和开发。

A dataset for evaluating automatic speech recognition (ASR) systems for Polish in the domain of TEDx public talks. Contains audio segments from Polish TEDx talks available on YouTube (CC BY-NC-ND 4.0) and synthetic speech generated with KugelAudio (MIT), with manually created and cross-verified transcriptions. Created as part of the course Workshops on Evaluation of Speech Recognition Systems (ZWESUI, AMU 2026) by Group 1.
提供机构:
s512757
搜集汇总
数据集介绍
s512757/polish-tedx-asr-eval 数据集图片
构建方式
该数据集旨在为波兰语自动语音识别(ASR)系统在TEDx公开演讲领域提供评估基准。其构建过程严谨而多元:首先,从YouTube上获取16场波兰语TEDx演讲的音频,这些演讲涵盖心理学、教育、商业等十类主题,并涵盖不同性别与年龄层的讲者,共计378个语音片段;其次,借助KugelAudio合成语音技术生成了50个额外片段,以扩展数据多样性。所有音频均被切割为3至46秒不等的片段,并统一转换为16kHz单声道WAV格式。五名标注员独立完成转写,随后经由交叉验证确保转录准确性,最终形成包含原始文本与规范化文本的双层标注结构。
特点
该数据集的核心特质在于其真实性与复杂性的结合。音频来源于会议厅环境,带有明显混响与观众反应,属于自发性演讲语料,这模拟了现实应用中的声学挑战。同时,数据集成人工标注与合成语音,既保证高精度转录(通过双人交叉验证),又引入可控的噪声变化。规范化文本经过去标点、小写转换、犹豫语气词剔除及外来词归一化(如e-mail与email统一)等处理,直接适用于词错误率(WER)计算。此外,详细记录了每个片段的讲者信息、声学条件与主题分布,为分析ASR系统在不同场景下的表现提供了精细的元数据支撑。
使用方法
使用者可通过HuggingFace加载该数据集,或直接从corpus.csv文件以及对应WAV音频目录获取数据。每条记录包含音频文件名、起止时间、原始与规范化转录文本、时长、标注员与验证员标识、以及源链接与许可证信息。典型用法是:读取CSV文件后,根据file与start/end字段切取音频片段,将音频与text_norm字段配对用于WER评估。数据集中同时包含真实演讲与合成语音片段,建议在评测时分别报告混响环境与安静环境、以及不同主题下的ASR性能,以全面评估系统的鲁棒性。
背景与挑战
背景概述
在自动语音识别(ASR)领域,面向特定语言与场景的评估数据集是推动模型性能提升的关键资源。波兰语作为斯拉夫语系的重要成员,其语音特性(如丰富的屈折形态与辅音群)对ASR系统构成独特挑战,而TEDx公共演讲场景下的自发性言语、混响声学环境及观众反应等复杂因素,进一步加剧了识别难度。为此,波兰亚当·密茨凯维奇大学(AMU)2026届“语音识别系统评估工作坊”课程的第一小组于近年构建了Polish-TEDx-ASR-Eval数据集。该数据集包含从16场波兰语TEDx演讲中提取的378个真实语音片段及50个由KugelAudio合成的语音片段,总计428个片段,时长约67分钟。所有转录经五人独立标注与交叉验证,并依据规范化协议处理以适配词错误率(WER)计算。作为首个聚焦波兰语公共演讲领域的ASR评估基准,该数据集填补了该语言在自发性、多讲者、混响条件下评估资源的空白,为研究非朗读式语音识别提供了标准化测试平台,对推动波兰语语音技术的实证研究具有重要价值。
当前挑战
该数据集所解决的领域问题核心在于波兰语ASR在非受控公共演讲场景下的鲁棒性评估挑战。例如,英语为主的ASR基准多涵盖新闻播报或朗读语料,而波兰语缺乏对自发性言语中语速变化、口误、重复及停顿等动态现象的评测标准;同时,TEDx演讲常见的礼堂混响与背景噪音(如掌声)严重干扰声学模型的特征提取。此外,构建过程亦面临多重挑战:数据来源方面,YouTube上的波兰语TEDx视频需手动筛选并分割为短片段,因原始音视频可能包含多人发言或非言语音频;标注环节中,五人团队需统一规范以处理波兰语特有的冠词省略、借词变体(如“email”与“e-mail”)及序数词展开,但无需处理大写转换;验证机制依赖交叉校验,然而协议中未量化标注者间的一致性,导致部分片段无验证记录(如TTS合成样本)。最后,讲者分布不均(男性占比82%)与声学条件单一(混响厅占74%)限制了数据集对性别、年龄段及安静场景的覆盖均衡性,可能引入评估偏差。
常用场景
经典使用场景
Polish TEDx ASR Eval数据集专为评估波兰语自动语音识别(ASR)系统在TEDx公开演讲场景下的性能而设计。该数据集包含从YouTube波兰语TEDx演讲中提取的音频片段,涵盖自发式、计划性公开演讲及合成语音,并附有经过交叉验证的人工转录文本。研究者常利用该数据集测试ASR模型在混响礼堂环境、不同说话人年龄与性别分布、多样化主题(如心理学、教育、科技)等复杂条件下的鲁棒性。其提供的标准化转录(text_norm)字段便于直接计算词错误率(WER),成为衡量波兰语非正式、口语化语音识别精度的标杆基准。
衍生相关工作
该数据集推动了多项相关研究的开展,包括对波兰语自发语音的声学建模优化、基于注意力机制的端到端ASR模型在混响条件下的微调方法,以及跨说话人风格迁移的鲁棒性训练策略。研究者利用其标注信息探索了不同性别、年龄及演讲主题对词错误率的影响,进而设计出更适配公开演讲语境的语音特征提取方案。同时,该数据集催生了针对波兰语非规范文本(如犹豫词、仿声词)的标准化处理工具(如normalize.py),并启发了在低资源语言场景下结合真实与合成语音数据增强ASR性能的工作范式。
数据集最近研究
最新研究方向
波兰语TEDx演讲自动语音识别评估数据集(Polish TEDx ASR Eval)聚焦于自然、自发性公众演讲场景下的语音识别性能评测,涵盖混响大厅等复杂声学环境与多样化话题。其近期研究方向紧密围绕低资源语言ASR系统的鲁棒性提升,尤其关注真实口语中的语速变化、犹豫词、借词及非规范表达对识别的挑战。该数据集通过引入人工标注与交叉验证的精细转录,以及基于KugelAudio的合成语音数据,为波兰语ASR在学术评测与工业部署之间架起桥梁,推动多语种语音技术向更贴近人类真实交流的方向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

