chinese-painting-collection
收藏资源简介:
中国绘画收藏数据集包含91,438张中国绘画图像,附带双语(中文/英文)视觉语言模型描述、书法OCR转录、视角分类以及异物检测边界框。图像来源包括台北故宫博物院(86,666张,遵循台湾政府开放数据许可证)、大都会艺术博物馆(1,186张,CC0)、史密森尼弗利尔美术馆(1,782张,CC0)、普林斯顿大学艺术博物馆(1,631张,研究用途)和芝加哥艺术博物馆(173张,CC0)。数据经过采集、规则清洗(仅保留完整、装裱和细节视图)、VLM标注(使用gemini-3.5-flash-lite生成中文和英文描述、OCR文本、视角类型和文化属性)以及异物检测(识别色卡、标尺、桌面等并生成裁剪边界框)。数据以WebDataset tar分片形式存储,每个样本包含JPEG图像和JSON侧车文件,另提供parquet元数据文件便于过滤。视角分布:装裱视图43,548张、完整视图36,253张、细节视图11,637张。适用任务包括图像描述生成、文本到图像生成、OCR、文化分类等。建议使用时可过滤掉包含异物的图像或应用边界框裁剪,以及按文化或视角筛选。标注以CC-BY-4.0发布,图像保留原始来源许可证。
Chinese Painting Collection is a dataset containing 91,438 Chinese painting images, accompanied by bilingual (Chinese/English) VLM descriptions, calligraphy OCR transcriptions, viewpoint classifications, and foreign object detection bounding boxes. Image sources include the National Palace Museum in Taipei (86,666 images, subject to the Taiwan Government Open Data license), the Metropolitan Museum of Art (1,186 images, CC0), the Smithsonian Freer Gallery of Art (1,782 images, CC0), the Princeton University Art Museum (1,631 images, research use), and the Art Institute of Chicago (173 images, CC0). The data underwent collection, rule-based cleaning (retaining only complete, mounted, and detail views), VLM annotation (using gemini-3.5-flash-lite to generate Chinese and English descriptions, OCR text, viewpoint types, and cultural attributes), and foreign object detection (identifying color cards, rulers, tables, etc., and generating crop bounding boxes). Data is stored in WebDataset tar shards, each sample containing a JPEG image and a JSON sidecar file, with additional parquet metadata files for easy filtering. Viewpoint distribution: mounted view 43,548, complete view 36,253, detail view 11,637. Applicable tasks include image captioning, text-to-image generation, OCR, cultural classification, etc. It is recommended to filter out images with foreign objects or apply bounding box cropping, and to filter by culture or viewpoint when using. Annotations are released under CC-BY-4.0, images retain original source licenses.
数据集概述
该数据集名为 Chinese Painting Collection,包含 91,438 张中国绘画图像,并配有中英双语视觉语言模型(VLM)描述、书法 OCR 转录、视图类型分类、部分子集的长描述,以及异物检测与最终裁剪框信息。
数据来源
| 组成部分 | 来源机构 | 图像数量 | 图像许可 |
|---|---|---|---|
npm_tw_c0–npm_tw_c3 |
台北国立故宫博物院开放数据 | 86,666 | 台湾开放政府数据许可 v1(需注明出处) |
met_china |
大都会艺术博物馆开放获取 | 1,186 | CC0 |
fsg |
史密森尼弗利尔美术馆 / 国家亚洲艺术博物馆 | 1,782 | CC0 |
princeton |
普林斯顿大学艺术博物馆 | 1,631 | 需查阅来源条款,供研究使用 |
aic_china |
芝加哥艺术学院 | 173 | CC0 |
其中四个台北故宫组成部分是该机构开放数据的季度分片,经去重并筛选出可用视图;博物馆部分均通过各机构公开 API 采集,并筛选与中国绘画相关的物件。
生成流程
- 采集:从来源 API / 开放数据包获取图像与基础元数据(标题、艺术家、年代、物件编号)。
- 基于规则的清洗:移除非艺术作品视图(如卷轴展开、装置照、封面、损坏或不可读图像、近似重复项),仅保留
full、mounted和detail三种视图。 - VLM 标注(gemini-3.5-flash-lite):对每张图像生成中英文描述、可见书法文字的 OCR 转录及印章描述、视图类型、文化归属字段(
chinese88,928 张、japanese2,255 张、korean83 张、western10 张、other20 张、uncertain142 张)。 - 异物检测:识别博物馆摄影中常见色卡、尺子、标签、桌面、眩光等异物(39,509 张非空),并返回作品裁剪框。
- 第二轮裁剪:对首轮标记的图像在已裁剪视图内再次定位作品框,两框合成为原始照片坐标系中的单一
bbox。每行恰有一个最终bbox,存在于 39,338 张图像中;171 张标记图像无框,以未裁剪形式保留。 - 文本并入描述:OCR 转录作为尾部块并入
caption_zh/caption_en,供文生图模型使用。 - 长描述:59,860 张图像额外获得由 DeepSeek V4.1 Flash 生成的更长描述(
caption_long),中位长度 488 tokens,p90 为 817,最大 4,415;模型查看的是裁剪后视图。
数据格式
数据以 Parquet 分片存储于 default/train/part-*.parquet,每行一张图像,包含 image 列(struct<bytes: binary, path: string> 类型)。包含以下列:
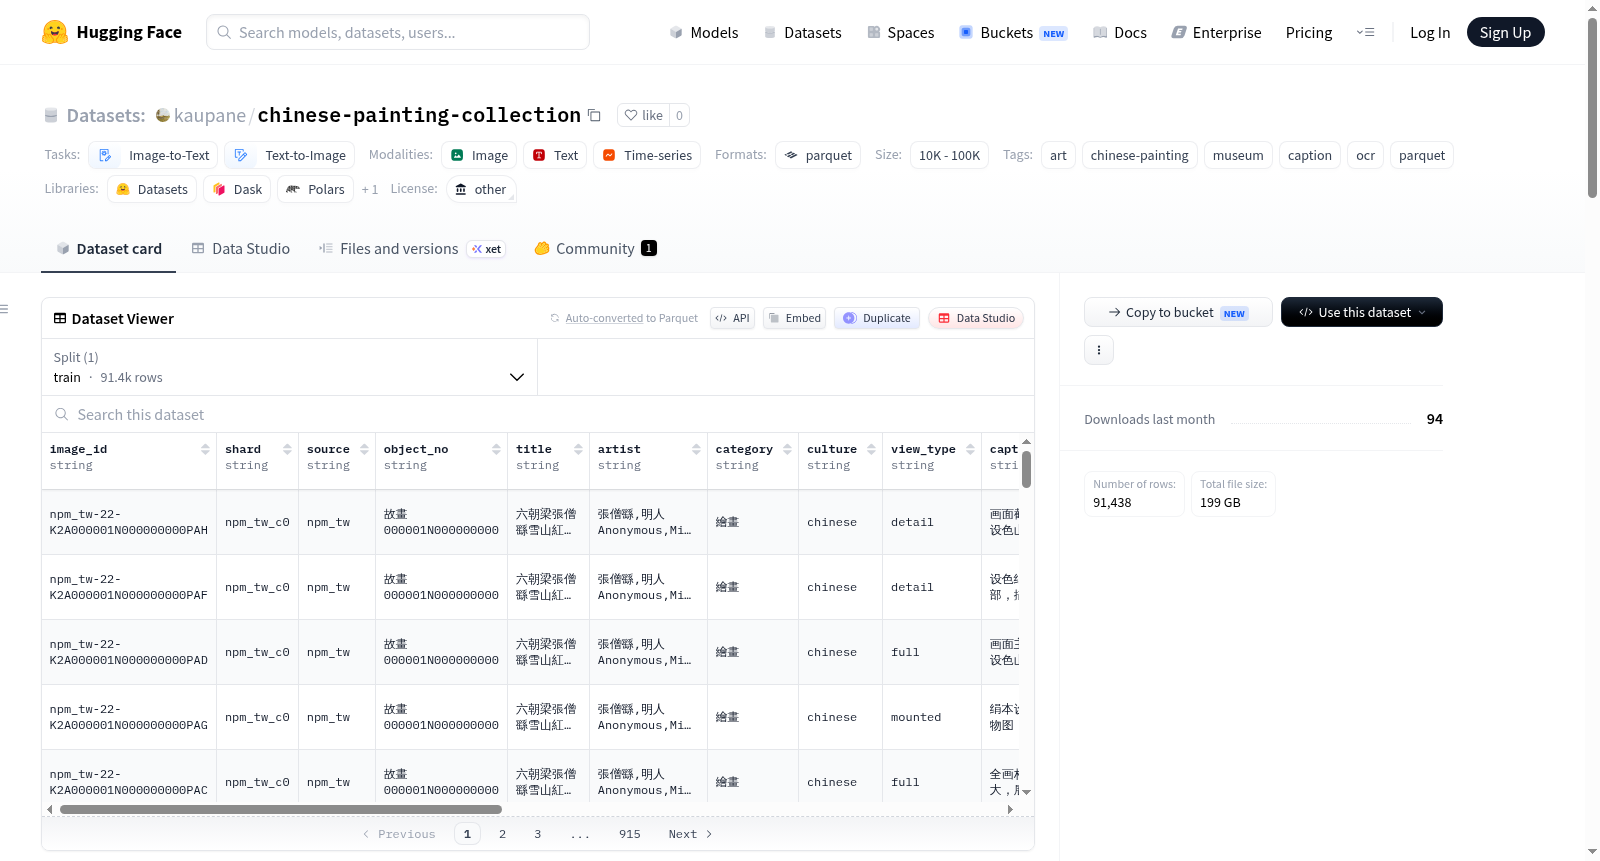
image_id、shard、source、object_no、title、artist、category、culture、view_type、caption_zh、caption_en、caption_long、ocr_text、artifacts(列表)、bbox(四个浮点数列表)、image
bbox 为归一化的 [x_min, y_min, x_max, y_max],单位为千分比坐标(0–1000)。视图类型分布:mounted 43,548 · full 36,253 · detail 11,637。
建议筛选方式
- 仅训练作品主体:应用
bbox裁剪(推荐),bbox为空则无需裁剪。 - 最干净子集:额外丢弃
artifacts非空的行。 - 排除装裱边框:保留
view_type == "full"或"detail"。 - 仅中国绘画:保留
culture == "chinese"。 - 长文本训练:在存在
caption_long处使用该字段。
注意事项
- 描述与 OCR 均由轻量级 VLM 机器生成,草书书法转录可能偶有错误。
- 裁剪框是模型对"作品在哪里"的作答,通常能移除色卡、尺子和标签条,但多数情况下会沿一条边缘留下薄背景条。
detail视图属大作品局部特写,可能与同一物件(相同object_no)的full视图内容重复。- 171 张图像虽有异物但无裁剪框,以未裁剪形式发布。
许可信息
图像保留各自来源的许可(见上表)。台北故宫部分需依台湾开放政府数据许可 v1 注明出处为國立故宮博物院(National Palace Museum, Taipei)。标注数据(描述、OCR、分类、裁剪框)以 CC-BY-4.0 发布。